一、概述
RAG(Retrieval-Augmented Generation,检索增强生成)是知识库系统的核心智能能力,通过将AI大模型与知识库文档深度结合,让AI助手能够基于企业内部文档内容回答用户问题,并标注引用来源,实现"有据可查"的智能问答。
1.1 功能定位
RAG知识库提供以下核心能力:
| 功能模块 | 说明 | 使用场景 |
|---|---|---|
| 文档分块 | 将长文档智能切分为语义完整的段落块 | 预处理阶段 |
| 向量嵌入 | 将文本块转换为1024维语义向量 | 索引阶段 |
| 混合检索 | BM25关键词 + kNN语义向量双重搜索 | 用户提问时 |
| RRF融合 | 倒数排名融合两种检索结果 | 结果排序 |
| LLM重排序 | 对候选结果进行精排 | 提升准确率 |
| RAG对话 | 基于知识库内容生成带引用的回答 | 用户问答 |
| 自动索引 | 文档发布/更新/删除时自动同步向量库 | 后台自动 |
| 重建索引 | 管理员手动重建全量或指定文档的向量索引 | 管理运维 |
1.2 系统架构
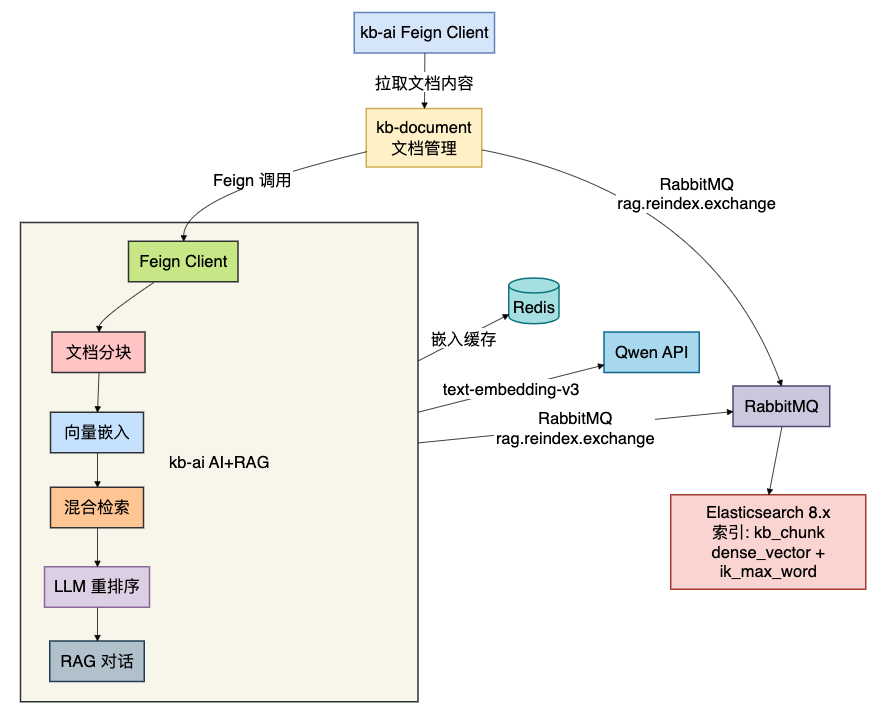
1.3 检索流程
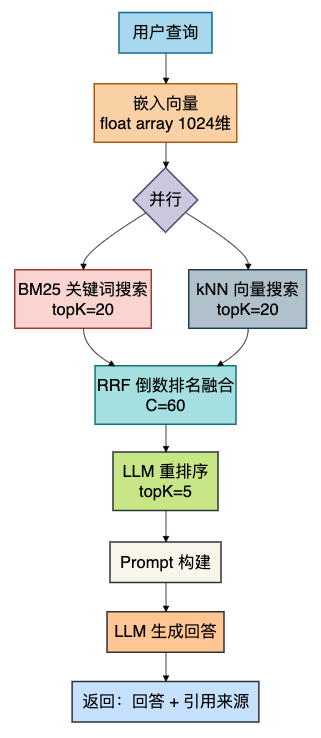
1.4 技术选型
| 组件 | 选型 | 说明 |
|---|---|---|
| 向量存储 | Elasticsearch 8.x | 已有部署,支持 dense\_vector + HNSW |
| 嵌入模型 | Qwen text-embedding-v3 | 1024维,OpenAI兼容接口 |
| 中文分词 | IK Analysis (ik\_max\_word) | BM25关键词检索 |
| 融合算法 | RRF (C=60) | 倒数排名融合 |
| 重排序 | LLM Scoring (1-10分) | 精排候选结果 |
| 消息队列 | RabbitMQ | 异步重建索引 |
| 服务调用 | Spring Cloud OpenFeign | kb-document kb-ai |
二、新增依赖
2.1 kb-ai/pom.xml
在 kb-ai 模块的 pom.xml 中添加以下依赖:
<!-- Elasticsearch for Vector Search -->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-data-elasticsearch</artifactId>
</dependency>
<!-- Spring Cloud OpenFeign -->
<dependency>
    <groupId>org.springframework.cloud</groupId>
    <artifactId>spring-cloud-starter-openfeign</artifactId>
</dependency>
<!-- Spring Cloud LoadBalancer -->
<dependency>
    <groupId>org.springframework.cloud</groupId>
    <artifactId>spring-cloud-starter-loadbalancer</artifactId>
</dependency>说明:
spring-boot-starter-data-elasticsearch:提供ElasticsearchOperations高级API和ElasticsearchClient低级APIspring-cloud-starter-openfeign:让 kb-ai 能通过Feign调用 kb-document 获取文档内容spring-cloud-starter-loadbalancer:Feign负载均衡
2.2 启用Feign客户端
在 kb-ai 的启动类上添加:
@EnableFeignClients(basePackages = "com.knowledge.base.ai.rag.client")三、YAML配置
3.1 新增RAG配置项
在 kb-ai/src/main/resources/application.yml 中添加:
# ==================== Elasticsearch配置(RAG向量搜索) ====================
spring:
  elasticsearch:
    uris: ${ELASTICSEARCH_URIS:http://localhost:9200}
    connection-timeout: 10s
    socket-timeout: 30s

# ==================== RAG 知识库检索增强配置 ====================
rag:
  enabled: true

  # 文档分块配置
  chunking:
    chunk-size: 512          # 每块最大token数
    chunk-overlap: 64        # 相邻块重叠token数

  # 嵌入模型配置
  embedding:
    model: text-embedding-v3  # Qwen嵌入模型名称
    dimension: 1024           # 向量维度
    cache-ttl-seconds: 86400  # 嵌入缓存TTL(24小时)

  # 检索参数配置
  retrieval:
    default-top-k: 5          # 默认返回结果数
    hybrid-top-k: 20          # 混合搜索候选数
    rrf-c: 60                 # RRF融合常数C

  # 重排序配置
  rerank:
    enabled: true             # 是否启用LLM重排序
    model: qwen               # 重排序使用的模型

  # 索引配置
  index:
    name: kb_chunk            # ES索引名称
    shards: 3                 # 分片数
    replicas: 1               # 副本数

  # 异步重建配置
  reindex:
    batch-size: 10            # 每批处理文档数
max-retries: 3 # 最大重试次数说明:
rag.enabled: true控制整个RAG功能的开关,设为false时所有RAG Bean不会被加载chunking.chunk-size: 512和chunking.chunk-overlap: 64控制文档分块行为embeddding.model指定向量嵌入模型,Qwen系列都支持text-embedding-v3retrieval.rrf-c: 60是RRF算法的平滑常数,值越大排名差异越小
四、实体类与POJO设计
4.1 ES文档映射 — KbChunkDoc
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/entity/KbChunkDoc.java:
package com.knowledge.base.ai.rag.entity;

import org.springframework.data.annotation.Id;
import org.springframework.data.elasticsearch.annotations.Document;
import org.springframework.data.elasticsearch.annotations.Field;
import org.springframework.data.elasticsearch.annotations.FieldType;
import lombok.Data;

import java.time.LocalDateTime;

@Data
@Document(indexName = "kb_chunk")
public class KbChunkDoc {

    @Id
    private String chunkId;

    @Field(type = FieldType.Long)
    private Long documentId;

    @Field(type = FieldType.Text, analyzer = "ik_max_word", searchAnalyzer = "ik_smart")
    private String documentTitle;

    @Field(type = FieldType.Text, analyzer = "ik_max_word", searchAnalyzer = "ik_smart")
    private String content;

    @Field(type = FieldType.Keyword)
    private String heading;

    @Field(type = FieldType.Integer)
    private Integer chunkIndex;

    @Field(type = FieldType.Integer)
    private Integer totalChunks;

    @Field(type = FieldType.Long)
    private Long categoryId;

    @Field(type = FieldType.Long)
    private Long authorId;

    @Field(type = FieldType.Long)
    private Long teamId;

    @Field(type = FieldType.Integer)
    private Integer docStatus;

    @Field(type = FieldType.Date)
    private LocalDateTime indexedAt;

    // 注意:embedding字段通过低级ES客户端写入
    // 不在Spring Data ES注解中声明,避免映射冲突
}
4.2 分块传输对象 — DocumentChunk
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/entity/DocumentChunk.java:
package com.knowledge.base.ai.rag.entity;

import lombok.AllArgsConstructor;
import lombok.Builder;
import lombok.Data;
import lombok.NoArgsConstructor;

import java.time.LocalDateTime;

@Data
@Builder
@NoArgsConstructor
@AllArgsConstructor
public class DocumentChunk {

    /** 块唯一ID(UUID) */
    private String chunkId;

    /** 来源文档ID */
    private Long documentId;

    /** 来源文档标题 */
    private String documentTitle;

    /** 块文本内容(含标题上下文) */
    private String content;

    /** 所属章节标题 */
    private String heading;

    /** 块在文档中的序号(从0开始) */
    private Integer chunkIndex;

    /** 文档总分块数 */
    private Integer totalChunks;

    /** 嵌入向量(1024维) */
    private float[] embedding;

    /** 分类ID */
    private Long categoryId;

    /** 作者ID */
    private Long authorId;

    /** 团队ID */
    private Long teamId;

    /** 文档状态 */
    private Integer docStatus;

    /** 索引时间 */
    private LocalDateTime indexedAt;
}设计说明:
DocumentChunk是服务间传输的POJO,不直接映射到数据库KbChunkDoc是Spring Data Elasticsearch的@Document映射embedding字段使用低级ElasticsearchClient的 bulk API 写入,因为Spring Data ES的@Field注解对dense_vector支持有限
五、RAG配置类设计
5.1 RagProperties — 集中配置管理
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/config/RagProperties.java:
package com.knowledge.base.ai.rag.config;

import lombok.Data;
import org.springframework.boot.context.properties.ConfigurationProperties;
import org.springframework.stereotype.Component;

@Data
@Component
@ConfigurationProperties(prefix = "rag")
public class RagProperties {

    private boolean enabled = true;

    private Chunking chunking = new Chunking();
    private Embedding embedding = new Embedding();
    private Retrieval retrieval = new Retrieval();
    private Rerank rerank = new Rerank();
    private Index index = new Index();
    private Reindex reindex = new Reindex();

    @Data
    public static class Chunking {
        private int chunkSize = 512;
        private int chunkOverlap = 64;
    }

    @Data
    public static class Embedding {
        private String model = "text-embedding-v3";
        private int dimension = 1024;
        private long cacheTtlSeconds = 86400;
    }

    @Data
    public static class Retrieval {
        private int defaultTopK = 5;
        private int hybridTopK = 20;
        private int rrfC = 60;
    }

    @Data
    public static class Rerank {
        private boolean enabled = true;
        private String model = "qwen";
    }

    @Data
    public static class Index {
        private String name = "kb_chunk";
        private int shards = 3;
        private int replicas = 1;
    }

    @Data
    public static class Reindex {
        private int batchSize = 10;
        private int maxRetries = 3;
    }
}
5.2 EmbeddingConfig — 嵌入模型Bean
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/config/EmbeddingConfig.java:
package com.knowledge.base.ai.rag.config;

import dev.langchain4j.model.embedding.EmbeddingModel;
import dev.langchain4j.model.openai.OpenAiEmbeddingModel;
import lombok.extern.slf4j.Slf4j;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.boot.autoconfigure.condition.ConditionalOnProperty;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Slf4j
@Configuration
@ConditionalOnProperty(name = "rag.enabled", havingValue = "true", matchIfMissing = true)
public class EmbeddingConfig {

    @Value("${qwen.api-key}")
    private String apiKey;

    @Value("${qwen.base-url}")
    private String baseUrl;

    @Bean
    public EmbeddingModel embeddingModel(RagProperties ragProperties) {
        return OpenAiEmbeddingModel.builder()
                .apiKey(apiKey)
                .baseUrl(baseUrl + "/embeddings")
                .modelName(ragProperties.getEmbedding().getModel())
                .build();
    }
}说明:
@ConditionalOnProperty确保rag.enabled=false时整个RAG不会加载- 复用项目已有的Qwen API Key和Base URL配置
- modelName从
RagProperties读取,支持动态配置
5.3 ElasticsearchConfig — ES客户端
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/config/ElasticsearchConfig.java:
package com.knowledge.base.ai.rag.config;

import co.elastic.clients.elasticsearch.ElasticsearchClient;
import co.elastic.clients.json.jackson.JacksonJsonpMapper;
import co.elastic.clients.transport.ElasticsearchTransport;
import co.elastic.clients.transport.rest_client.RestClientTransport;
import org.apache.http.HttpHost;
import org.elasticsearch.client.RestClient;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.boot.autoconfigure.condition.ConditionalOnProperty;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
@ConditionalOnProperty(name = "rag.enabled", havingValue = "true", matchIfMissing = true)
public class ElasticsearchConfig {

    @Value("${spring.elasticsearch.uris:http://localhost:9200}")
    private String uris;

    @Bean
    public ElasticsearchClient elasticsearchClient() {
        RestClient restClient = RestClient.builder(HttpHost.create(uris)).build();
        ElasticsearchTransport transport = new RestClientTransport(
                restClient, new JacksonJsonpMapper());
        return new ElasticsearchClient(transport);
    }
}
5.4 RagAutoConfiguration — 自动装配
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/config/RagAutoConfiguration.java:
package com.knowledge.base.ai.rag.config;

import org.springframework.boot.autoconfigure.condition.ConditionalOnProperty;
import org.springframework.context.annotation.ComponentScan;
import org.springframework.context.annotation.Configuration;

@Configuration
@ConditionalOnProperty(name = "rag.enabled", havingValue = "true", matchIfMissing = true)
@ComponentScan("com.knowledge.base.ai.rag")
public class RagAutoConfiguration {
}
六、文档分块服务
6.1 ChunkingService 接口
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/service/ChunkingService.java:
package com.knowledge.base.ai.rag.service;

import com.knowledge.base.ai.rag.entity.DocumentChunk;
import java.util.List;

public interface ChunkingService {

    /**
     * 将文档内容切分为块
     *
     * @param content        文档全文内容
     * @param documentId     文档ID
     * @param documentTitle  文档标题
     * @param categoryId     分类ID
     * @param authorId       作者ID
     * @param teamId         团队ID
     * @param docStatus      文档状态
     * @return 分块列表
     */
    List<DocumentChunk> chunk(String content, Long documentId, String documentTitle,
                              Long categoryId, Long authorId, Long teamId, Integer docStatus);
}
6.2 ChunkingServiceImpl — 分块实现
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/service/impl/ChunkingServiceImpl.java:
package com.knowledge.base.ai.rag.service.impl;

import com.knowledge.base.ai.rag.config.RagProperties;
import com.knowledge.base.ai.rag.entity.DocumentChunk;
import com.knowledge.base.ai.rag.service.ChunkingService;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.stereotype.Service;

import java.util.ArrayList;
import java.util.List;
import java.util.UUID;
import java.util.regex.Matcher;
import java.util.regex.Pattern;

@Slf4j
@Service
@RequiredArgsConstructor
public class ChunkingServiceImpl implements ChunkingService {

    private final RagProperties ragProperties;

    private static final Pattern HEADING_PATTERN =
            Pattern.compile("^(#{1,6})\\s+(.+)$", Pattern.MULTILINE);

    /** 中英文混合保守估计:1 token ≈ 2 字符 */
    private static final double CHARS_PER_TOKEN = 2.0;

    @Override
    public List<DocumentChunk> chunk(String content, Long documentId,
            String documentTitle, Long categoryId, Long authorId,
            Long teamId, Integer docStatus) {
        if (content == null || content.isEmpty()) {
            return List.of();
        }

        int chunkSize = ragProperties.getChunking().getChunkSize();
        int chunkOverlap = ragProperties.getChunking().getChunkOverlap();
        int maxChars = (int) (chunkSize * CHARS_PER_TOKEN);
        int overlapChars = (int) (chunkOverlap * CHARS_PER_TOKEN);

        List<Section> sections = splitByHeadings(content);
        List<DocumentChunk> chunks = new ArrayList<>();

        for (Section section : sections) {
            List<String> paragraphs = splitParagraphs(section.content);
            List<String> merged = mergeParagraphs(paragraphs, maxChars);

            for (int i = 0; i < merged.size(); i++) {
                String chunkContent = (section.heading != null
                        ? section.heading + "\n\n" : "") + merged.get(i);

                // 重叠:取上一块末尾overlapChars个字符
                if (i > 0 && overlapChars > 0) {
                    String prevContent = merged.get(i - 1);
                    if (prevContent.length() > overlapChars) {
                        chunkContent = prevContent.substring(
                                prevContent.length() - overlapChars)
                                + "\n" + chunkContent;
                    }
                }

                chunks.add(DocumentChunk.builder()
                        .chunkId(UUID.randomUUID().toString())
                        .documentId(documentId)
                        .documentTitle(documentTitle)
                        .content(chunkContent)
                        .heading(section.heading)
                        .chunkIndex(chunks.size())
                        .categoryId(categoryId)
                        .authorId(authorId)
                        .teamId(teamId)
                        .docStatus(docStatus)
                        .build());
            }
        }

        final int total = chunks.size();
        chunks.forEach(c -> c.setTotalChunks(total));
        return chunks;
    }

    // ========== 私有方法 ==========

    /** 按Markdown标题 (# ## ###) 划分章节 */
    private List<Section> splitByHeadings(String content) {
        List<Section> sections = new ArrayList<>();
        Matcher m = HEADING_PATTERN.matcher(content);
        int lastEnd = 0;
        String currentHeading = null;

        while (m.find()) {
            if (lastEnd < m.start()) {
                String sectionContent = content.substring(lastEnd, m.start()).trim();
                if (!sectionContent.isEmpty()) {
                    sections.add(new Section(currentHeading, sectionContent));
                }
            }
            currentHeading = m.group(2);
            lastEnd = m.end();
        }

        if (lastEnd < content.length()) {
            String lastContent = content.substring(lastEnd).trim();
            if (!lastContent.isEmpty()) {
                sections.add(new Section(currentHeading, lastContent));
            }
        }

        if (sections.isEmpty()) {
            sections.add(new Section(null, content.trim()));
        }
        return sections;
    }

    /** 按空行分段落 */
    private List<String> splitParagraphs(String content) {
        List<String> paragraphs = new ArrayList<>();
        for (String para : content.split("\n\n")) {
            String trimmed = para.trim();
            if (!trimmed.isEmpty()) {
                paragraphs.add(trimmed);
            }
        }
        return paragraphs;
    }

    /** 合并段落达到目标大小 */
    private List<String> mergeParagraphs(List<String> paragraphs, int maxChars) {
        List<String> result = new ArrayList<>();
        StringBuilder current = new StringBuilder();

        for (String paragraph : paragraphs) {
            if (paragraph.length() > maxChars) {
                if (current.length() > 0) {
                    result.add(current.toString().trim());
                    current = new StringBuilder();
                }
                result.addAll(splitLongParagraph(paragraph, maxChars));
                continue;
            }

            if (current.length() + paragraph.length() + 2 <= maxChars) {
                if (current.length() > 0) current.append("\n\n");
                current.append(paragraph);
            } else {
                if (current.length() > 0) result.add(current.toString().trim());
                current = new StringBuilder(paragraph);
            }
        }

        if (current.length() > 0) result.add(current.toString().trim());
        return result;
    }

    /** 超长段落按句子分割 */
    private List<String> splitLongParagraph(String paragraph, int maxChars) {
        List<String> result = new ArrayList<>();
        String[] sentences = paragraph.split("(?<=[。!?\\.!?\\n])");
        StringBuilder current = new StringBuilder();

        for (String sentence : sentences) {
            String trimmed = sentence.trim();
            if (trimmed.isEmpty()) continue;

            if (current.length() + trimmed.length() > maxChars) {
                if (current.length() > 0) {
                    result.add(current.toString().trim());
                    current = new StringBuilder();
                }
                if (trimmed.length() > maxChars) {
                    for (int i = 0; i < trimmed.length(); i += maxChars) {
                        int end = Math.min(i + maxChars, trimmed.length());
                        result.add(trimmed.substring(i, end));
                    }
                } else {
                    current = new StringBuilder(trimmed);
                }
            } else {
                if (current.length() > 0) current.append(" ");
                current.append(trimmed);
            }
        }

        if (current.length() > 0) result.add(current.toString().trim());
        return result;
    }

    /** 章节内部类 */
    private record Section(String heading, String content) {}
}
6.3 分块策略说明
文档全文
  │
  ├── 步骤1: 按 # ## ### 标题划分章节
  │     章节1 (heading="概述")   章节2 (heading="部署步骤")   ...
  │
  ├── 步骤2: 每章节按 \n\n 分段落
  │     [段落1] [段落2] [段落3] ...
  │
  ├── 步骤3: 段落合并到 maxChars (512 token × 2 = 1024字符)
  │     块1: [段落1 + 段落2]    块2: [段落3 + 段落4]  ...
  │
  └── 步骤4: 每块前加上章节标题,末尾加上重叠文本
块: "# 部署步骤\n\n首先需要安装Docker..."关键设计:
- 每个块都包含所属章节标题,使其自包含(Self-contained),独立于上下文即可理解
- 相邻块之间有 64 token 的重叠,避免分割点处漏掉关键信息
- 超长句子按最大字符数强制截断,保证每块大小可控
七、向量嵌入服务
7.1 EmbeddingService 接口
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/service/EmbeddingService.java:
package com.knowledge.base.ai.rag.service;

import java.util.List;

public interface EmbeddingService {

    /** 对单段文本生成嵌入向量 */
    float[] embed(String text);

    /** 批量生成嵌入向量 */
    List<float[]> embedBatch(List<String> texts);
}
7.2 EmbeddingServiceImpl — 嵌入实现
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/service/impl/EmbeddingServiceImpl.java:
关键实现要点:
@Service
@RequiredArgsConstructor
public class EmbeddingServiceImpl implements EmbeddingService {

    private final EmbeddingModel embeddingModel;  // langchain4j
    private final RagProperties ragProperties;
    private final StringRedisTemplate redisTemplate;  // 嵌入缓存

    @Override
    public float[] embed(String text) {
        // 1. 先查Redis缓存
        String cacheKey = "rag:emb:" + DigestUtil.md5Hex(text);
        String cached = redisTemplate.opsForValue().get(cacheKey);
        if (cached != null) {
            return JSON.parseObject(cached, float[].class);
        }

        // 2. 调用Qwen API
        Embedding emb = embeddingModel.embed(TextSegment.from(text)).content();

        // 3. 写入缓存(24小时TTL)
        redisTemplate.opsForValue().set(cacheKey, JSON.toJSONString(emb.vector()),
                ragProperties.getEmbedding().getCacheTtlSeconds(), TimeUnit.SECONDS);

        return emb.vector();
    }
}缓存策略:
- Key:
rag:emb:{MD5(text)}— 相同文本不重复调用API - TTL: 24小时(可配置)
- 降级: Redis不可用时直接调用API,不报错
八、向量索引服务(核心)
8.1 VectorIndexService 接口
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/service/VectorIndexService.java:
public interface VectorIndexService {
    void indexChunks(List<DocumentChunk> chunks);
    void deleteByDocId(Long documentId);
    List<RagSearchResultVO> searchHybrid(String queryText, float[] queryEmbedding,
                                          int topK, int hybridTopK, int rrfC);
    boolean indexExists();
    void createIndexIfNotExists();
    void dropIndex();
}
8.2 VectorIndexServiceImpl — ES向量操作实现
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/service/impl/VectorIndexServiceImpl.java:
8.2.1 ES索引创建
@Override
public void createIndexIfNotExists() {
    if (indexExists()) return;

    CreateIndexRequest request = CreateIndexRequest.of(c -> c
        .index("kb_chunk")
        .settings(s -> s
            .numberOfShards("3")
            .numberOfReplicas("1")
            .refreshInterval(ri -> ri.time("5s"))
            .analysis(a -> a
                .analyzer("ik_smart_analyzer", ana -> ana
                    .custom(cust -> cust.tokenizer("ik_smart")))))
        .mappings(m -> m
            .properties("chunk_id", p -> p.keyword(k -> k))
            .properties("document_id", p -> p.long_(l -> l))
            .properties("document_title", p -> p.text(t -> t
                .analyzer("ik_max_word").searchAnalyzer("ik_smart")
                .fields("keyword", f -> f.keyword(k -> k))))
            .properties("content", p -> p.text(t -> t
                .analyzer("ik_max_word").searchAnalyzer("ik_smart")))
            .properties("heading", p -> p.keyword(k -> k))
            .properties("chunk_index", p -> p.integer(i -> i))
            .properties("total_chunks", p -> p.integer(i -> i))
            .properties("category_id", p -> p.long_(l -> l))
            .properties("author_id", p -> p.long_(l -> l))
            .properties("team_id", p -> p.long_(l -> l))
            .properties("doc_status", p -> p.integer(i -> i))
            .properties("indexed_at", p -> p.date(d -> d))
            .properties("embedding", p -> p.denseVector(dv -> dv
                .dims(1024)
                .index(true)
                .similarity("cosine")))));

    esClient.indices().create(request);
}ES索引设计要点:
content使用ik_max_word(索引时细粒度分词)+ik_smart(搜索时粗粒度分词)document_title保留keyword子字段,支持精确聚合embedding使用dense_vector类型,dims=1024,similarity=cosine, 开启HNSW索引
8.2.2 混合检索 — BM25 + kNN + RRF融合
@Override
public List<RagSearchResultVO> searchHybrid(String queryText,
        float[] queryEmbedding, int topK, int hybridTopK, int rrfC) {

    // 并行执行 BM25 + kNN 搜索
    CompletableFuture<List<SearchResult>> bm25Future =
        CompletableFuture.supplyAsync(() -> bm25Search(queryText, hybridTopK));
    CompletableFuture<List<SearchResult>> knnFuture =
        CompletableFuture.supplyAsync(() -> knnSearch(queryEmbedding, hybridTopK));

    List<SearchResult> bm25Results = bm25Future.get(30, TimeUnit.SECONDS);
    List<SearchResult> knnResults = knnFuture.get(30, TimeUnit.SECONDS);

    // RRF融合
    Map<String, SearchResult> fused = rrfFuse(bm25Results, knnResults, rrfC);

    // 按融合得分降序排列,取topK
    return fused.values().stream()
        .sorted(Comparator.comparingDouble(SearchResult::getScore).reversed())
        .limit(topK)
        .map(this::toVO)
        .collect(Collectors.toList());
}
8.2.3 BM25搜索
使用 ElasticsearchOperations 的高级API:
private List<SearchResult> bm25Search(String queryText, int topK) {
    Criteria criteria = new Criteria("content").matches(queryText)
        .or(new Criteria("document_title").matches(queryText));
    CriteriaQuery query = new CriteriaQuery(criteria);
    query.setMaxResults(topK);

    SearchHits<KbChunkDoc> hits = esOperations.search(query, KbChunkDoc.class);
    // ... 转换为SearchResult列表
}
8.2.4 kNN向量搜索
使用低级 ElasticsearchClient 的 knn 查询:
private List<SearchResult> knnSearch(float[] queryEmbedding, int topK) {
    KnnQuery knn = KnnQuery.of(k -> k
        .field("embedding")
        .queryVector(toFloatList(queryEmbedding))
        .k(topK)
        .numCandidates(topK * 2));

    SearchRequest request = SearchRequest.of(s -> s
        .index("kb_chunk")
        .knn(knn)
        .size(topK));

    SearchResponse<Map> response = esClient.search(request, Map.class);
    // ... 转换为SearchResult列表
}
8.2.5 RRF融合算法(核心算法)
/**
 * Reciprocal Rank Fusion
 * score(d) = SUM_{r in {BM25, kNN}} 1 / (C + rank_r(d))
 *
 * C=60 是经验值,值越大排名差异越小
 */
private Map<String, SearchResult> rrfFuse(
        List<SearchResult> bm25Results, List<SearchResult> knnResults, int c) {

    Map<String, SearchResult> fused = new ConcurrentHashMap<>();

    // 分别按原始得分降序排序
    List<SearchResult> sortedBm25 = bm25Results.stream()
        .sorted(Comparator.comparingDouble(SearchResult::getScore).reversed()).toList();
    List<SearchResult> sortedKnn = knnResults.stream()
        .sorted(Comparator.comparingDouble(SearchResult::getScore).reversed()).toList();

    // BM25贡献
    for (int rank = 0; rank < sortedBm25.size(); rank++) {
        SearchResult sr = sortedBm25.get(rank);
        double rrfScore = 1.0 / (c + rank + 1);
        SearchResult existing = fused.get(sr.chunkId);
        if (existing == null) {
            sr.score = rrfScore;
            fused.put(sr.chunkId, sr);
        } else {
            existing.score += rrfScore;
        }
    }

    // kNN贡献(同上)
    for (int rank = 0; rank < sortedKnn.size(); rank++) {
        SearchResult sr = sortedKnn.get(rank);
        double rrfScore = 1.0 / (c + rank + 1);
        SearchResult existing = fused.get(sr.chunkId);
        if (existing == null) {
            sr.score = rrfScore;
            fused.put(sr.chunkId, sr);
        } else {
            existing.score += rrfScore;
        }
    }

    return fused;
}RRF算法原理:
- 如果某个块在BM25中排第1,在kNN中排第3 → score = 1/(60+1) + 1/(60+3) = 0.0164 + 0.0159 = 0.0322
- 如果某个块只在BM25中排第5 → score = 1/(60+5) = 0.0154
- 同时在两种搜索中排名靠前的块获得更高融合分数
九、检索编排服务
9.1 RagRetrievalService 接口
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/service/RagRetrievalService.java:
public interface RagRetrievalService {
    List<RagSearchResultVO> retrieve(String query, int topK, boolean enableRerank);
}
9.2 RagRetrievalServiceImpl — 检索流水线
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/service/impl/RagRetrievalServiceImpl.java:
@Service
@RequiredArgsConstructor
public class RagRetrievalServiceImpl implements RagRetrievalService {

    private final EmbeddingService embeddingService;
    private final VectorIndexService vectorIndexService;
    private final ModelProvider modelProvider;
    private final RagProperties ragProperties;

    @Override
    public List<RagSearchResultVO> retrieve(String query, int topK, boolean enableRerank) {
        // 1. 确保索引存在
        vectorIndexService.createIndexIfNotExists();

        // 2. 生成查询向量
        float[] queryEmbedding = embeddingService.embed(query);

        // 3. 混合搜索
        int hybridTopK = ragProperties.getRetrieval().getHybridTopK();
        int candidateK = Math.max(topK * 2, hybridTopK);
        List<RagSearchResultVO> candidates = vectorIndexService.searchHybrid(
                query, queryEmbedding, candidateK, hybridTopK,
                ragProperties.getRetrieval().getRrfC());

        // 4. LLM重排序
        if (enableRerank && ragProperties.getRerank().isEnabled()
                && candidates.size() > topK) {
            candidates = rerank(candidates, query, topK);
        }

        return candidates;
    }

    /**
     * LLM重排序:对每个候选块调用LLM打分(1-10)
     */
    private List<RagSearchResultVO> rerank(List<RagSearchResultVO> candidates,
            String query, int topK) {
        ChatLanguageModel model = modelProvider.getDefaultModel();
        List<ScoredChunk> scored = new ArrayList<>();

        for (RagSearchResultVO candidate : candidates) {
            String prompt = String.format("""
                你是一个搜索相关性评估专家。
                请根据"用户查询"和"文档片段",评估该文档片段的相关程度。

                用户查询:%s
                文档片段:%s

                请仅返回一个整数评分(1-10分):
                10-直接完美回答 | 7-9-高度相关 | 4-6-部分相关 | 1-3-基本无关
                """, query, candidate.getContent().substring(0, Math.min(1000, candidate.getContent().length())));

            String response = model.generate(UserMessage.from(prompt)).content().text();
            int score = parseRelevanceScore(response);
            scored.add(new ScoredChunk(candidate, score));
        }

        // 按得分降序
        scored.sort(Comparator.comparingInt(ScoredChunk::score).reversed());
        return scored.stream().limit(topK).map(sc -> {
            sc.result.setScore(sc.score);
            return sc.result;
        }).toList();
    }

    private record ScoredChunk(RagSearchResultVO result, int score) {}
}
十、RAG对话服务
10.1 RagChatService 接口
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/service/RagChatService.java:
public interface RagChatService {
    ChatResponseVO chatWithContext(ChatRequestDTO requestDTO, Long userId);
    SseEmitter chatWithContextStream(ChatRequestDTO requestDTO, Long userId);
}
10.2 RagChatServiceImpl — Prompt构建与对话
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/service/impl/RagChatServiceImpl.java:
10.2.1 核心流程
chatWithContext(requestDTO, userId)
  │
  ├── 1. prepareConversation()     —— 创建/验证对话
  ├── 2. safeRetrieve(query)       —— 检索相关知识(失败降级为空列表)
  ├── 3. buildRagPrompt()          —— 构建RAG Prompt
  ├── 4. LLM.generate(prompt)      —— 生成回答
  ├── 5. buildCitations()          —— 构建引用列表
  └── 6. 持久化消息 → MySQL
10.2.2 Prompt模板设计
private String buildRagPrompt(String query, List<RagSearchResultVO> context) {
    if (context.isEmpty()) {
        return query;  // 无检索结果时直接用原问题
    }

    StringBuilder sb = new StringBuilder();
    sb.append("你是一个企业知识库助手。请仅根据以下参考资料回答用户的问题。\n");
    sb.append("如果参考资料中没有相关信息,请说明"【根据现有知识库暂时无法回答此问题】",绝对不要编造内容。\n");
    sb.append("回答时,请在引用资料处的末尾标注引用编号,如 [1]、[2]。\n");
    sb.append("回答应当专业、准确、简洁。\n\n");

    sb.append("=== 参考资料 ===\n");
    for (int i = 0; i < context.size(); i++) {
        RagSearchResultVO chunk = context.get(i);
        sb.append(String.format("[%d] 来源文档:%s", i + 1, chunk.getDocumentTitle()));
        if (chunk.getHeading() != null && !chunk.getHeading().isEmpty()) {
            sb.append(" | 章节:").append(chunk.getHeading());
        }
        sb.append("\n").append(chunk.getContent()).append("\n\n");
    }

    sb.append("=== 用户问题 ===\n").append(query);
    return sb.toString();
}Prompt设计要点:
- 明确指令:仅根据参考资料回答,不编造
- 引用标注:要求LLM在回答中使用
[1] [2]标注 - 结构化:参考资料每块有编号、来源文档名、章节名
- 降级:无检索结果时直接用原问题
10.2.3 优雅降级
/** 安全检索:异常时返回空列表,不中断对话 */
private List<RagSearchResultVO> safeRetrieve(String query) {
    try {
        return ragRetrievalService.retrieve(query,
                ragProperties.getRetrieval().getDefaultTopK(),
                ragProperties.getRerank().isEnabled());
    } catch (Exception e) {
        log.warn("RAG检索失败,降级为纯LLM回答:{}", e.getMessage());
        return List.of();
    }
}降级链路:
| 故障点 | 降级行为 |
|---|---|
| 嵌入模型不可用 | 返回空结果,普通对话 |
| ES不可达 | 返回空结果,普通对话 |
| 检索无结果 | 提示"知识库中暂无相关信息" |
| LLM调用失败 | 返回错误信息 |
| RAG未启用 | 直接走普通LLM对话 |
十一、检索结果与引用VO
11.1 RagSearchResultVO
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/vo/RagSearchResultVO.java:
@Data
@Builder
@NoArgsConstructor
@AllArgsConstructor
public class RagSearchResultVO {
    private String chunkId;
    private Long documentId;
    private String documentTitle;
    private String content;
    private String heading;
    private double score;       // RRF融合得分或重排序得分
    private double bm25Score;   // BM25原始得分
    private double vectorScore; // kNN原始得分
}
11.2 CitationVO
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/vo/CitationVO.java:
@Data
@Builder
@NoArgsConstructor
@AllArgsConstructor
@Schema(description = "引用来源")
public class CitationVO {
    @Schema(description = "引用编号(与回答中的 [1] [2] 对应)")
    private int index;

    @Schema(description = "来源文档ID")
    private Long documentId;

    @Schema(description = "来源文档标题")
    private String documentTitle;

    @Schema(description = "引用片段摘要")
    private String excerpt;

    @Schema(description = "相关度得分")
    private double relevanceScore;
}
十二、控制器层
12.1 RagChatController — RAG对话接口
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/controller/RagChatController.java:
@Slf4j
@RestController
@RequestMapping("/rag")
@Tag(name = "RAG对话", description = "知识库检索增强对话接口")
public class RagChatController {

    @Resource
    private RagChatService ragChatService;

    @PostMapping("/chat")
    @Operation(summary = "RAG对话", description = "基于知识库内容的增强对话")
    public Result<ChatResponseVO> chat(@RequestBody @Valid ChatRequestDTO requestDTO) {
        Long userId = UserContext.getUserId();
        ChatResponseVO response = ragChatService.chatWithContext(requestDTO, userId);
        return Result.success(response);
    }

    @PostMapping("/chat/stream")
    @Operation(summary = "RAG流式对话", description = "基于知识库内容的增强流式对话(SSE)")
    public SseEmitter chatStream(@RequestBody @Valid ChatRequestDTO requestDTO) {
        Long userId = UserContext.getUserId();
        return ragChatService.chatWithContextStream(requestDTO, userId);
    }
}
12.2 RagSearchController — 独立检索接口
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/controller/RagSearchController.java:
@Slf4j
@RestController
@RequestMapping("/rag")
@Tag(name = "RAG检索", description = "知识库检索接口")
public class RagSearchController {

    @Resource
    private RagRetrievalService ragRetrievalService;

    @PostMapping("/search")
    @Operation(summary = "RAG检索", description = "在知识库中检索相关文档片段")
    public Result<List<RagSearchResultVO>> search(
            @RequestBody @Valid RagSearchRequestDTO requestDTO) {
        List<RagSearchResultVO> results = ragRetrievalService.retrieve(
                requestDTO.getQuery(),
                requestDTO.getTopK() != null ? requestDTO.getTopK() : 5,
                requestDTO.isEnableRerank());
        return Result.success(results);
    }
}
12.3 RagReindexController — 重建索引管理接口
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/controller/RagReindexController.java:
@Slf4j
@RestController
@RequestMapping("/rag/reindex")
@Tag(name = "RAG重建索引", description = "知识库向量索引管理接口")
public class RagReindexController {

    @Resource
    private ReindexService reindexService;

    @PostMapping("/{docId}")
    @Operation(summary = "重建单个文档索引")
    public Result<String> reindexByDoc(@PathVariable Long docId) {
        String taskId = reindexService.reindexByDocId(docId);
        return Result.success(taskId);
    }

    @PostMapping("/batch")
    @Operation(summary = "批量重建文档索引")
    public Result<String> reindexBatch(@RequestBody ReindexRequestDTO dto) {
        String taskId = reindexService.reindexBatch(dto.getDocumentIds());
        return Result.success(taskId);
    }

    @PostMapping("/all")
    @Operation(summary = "全量重建所有已发布文档索引")
    public Result<String> reindexAll() {
        String taskId = reindexService.reindexAll();
        return Result.success(taskId);
    }

    @DeleteMapping("/{docId}")
    @Operation(summary = "删除单个文档向量索引")
    public Result<String> deleteByDoc(@PathVariable Long docId) {
        String taskId = reindexService.deleteByDocId(docId);
        return Result.success(taskId);
    }

    @GetMapping("/progress/{taskId}")
    @Operation(summary = "查询重建进度")
    public Result<ReindexProgressVO> getProgress(@PathVariable String taskId) {
        return Result.success(reindexService.getProgress(taskId));
    }
}
12.4 RESTful API汇总
| 方法 | 路径 | 说明 |
|---|---|---|
| POST | /rag/chat | RAG同步对话 |
| POST | /rag/chat/stream | RAG流式对话(SSE) |
| POST | /rag/search | 独立知识库检索 |
| POST | /rag/reindex/{docId} | 重建单个文档索引 |
| POST | /rag/reindex/batch | 批量重建文档索引 |
| POST | /rag/reindex/all | 全量重建所有已发布文档索引 |
| DELETE | /rag/reindex/{docId} | 删除单个文档索引 |
| GET | /rag/reindex/progress/{taskId} | 查询重建进度 |
十三、MQ异步重建索引
13.1 消息定义
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/mq/ReindexMessage.java:
@Data
@Builder
@NoArgsConstructor
@AllArgsConstructor
public class ReindexMessage implements Serializable {

    private String taskId;                     // 任务ID (UUID)
    private ReindexType type;                  // 任务类型
    private List<Long> documentIds;             // 文档ID列表

    public enum ReindexType {
        ALL,                // 重建所有已发布文档
        BY_DOC_IDS,         // 重建指定文档
        DELETE_BY_DOC_IDS   // 删除指定文档的向量索引
    }
}
13.2 RabbitMQ配置
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/config/RabbitConfig.java:
@Configuration
@ConditionalOnProperty(name = "rag.enabled", havingValue = "true", matchIfMissing = true)
public class RabbitConfig {

    public static final String EXCHANGE = "rag.reindex.exchange";
    public static final String QUEUE = "rag.reindex.queue";
    public static final String ROUTING_KEY_ALL = "rag.reindex.all";
    public static final String ROUTING_KEY_BY_IDS = "rag.reindex.by_ids";
    public static final String ROUTING_KEY_DELETE = "rag.reindex.delete";

    @Bean public TopicExchange ragReindexExchange() { return new TopicExchange(EXCHANGE); }

    @Bean
    public Queue ragReindexQueue() {
        return QueueBuilder.durable(QUEUE)
                .withArgument("x-dead-letter-exchange", EXCHANGE + ".dlx")  // 死信队列
                .build();
    }

    @Bean public Binding ragReindexAllBinding() { /* EXCHANGE + ROUTING_KEY_ALL → QUEUE */ }
    @Bean public Binding ragReindexByIdsBinding() { /* EXCHANGE + ROUTING_KEY_BY_IDS → QUEUE */ }
    @Bean public Binding ragReindexDeleteBinding() { /* EXCHANGE + ROUTING_KEY_DELETE → QUEUE */ }

    @Bean
    public Jackson2JsonMessageConverter jackson2JsonMessageConverter() {
        return new Jackson2JsonMessageConverter();
    }
}
13.3 ReindexConsumer — 消费者
创建 kb-ai/src/main/java/com/knowledge/base/ai/rag/mq/ReindexConsumer.java:
核心流程:
@RabbitListener(queues = "rag.reindex.queue")
public void handleReindex(@Payload ReindexMessage message, Channel channel,
        @Header(AmqpHeaders.DELIVERY_TAG) long deliveryTag) {

    // DELETE_BY_DOC_IDS:仅删除向量索引
    if (message.getType() == ReindexMessage.ReindexType.DELETE_BY_DOC_IDS) {
        for (Long docId : message.getDocumentIds()) {
            vectorIndexService.deleteByDocId(docId);
        }
        channel.basicAck(deliveryTag, false);
        return;
    }

    // ALL / BY_DOC_IDS:拉取文档 → 分块 → 嵌入 → 索引
    List<Map<String, Object>> documents = (message.getType() == BY_DOC_IDS)
        ? loadDocumentsByIds(message.getDocumentIds())
        : loadAllPublishedDocuments();

    for (Map<String, Object> doc : documents) {
        Long docId = toLong(doc.get("id"));
        String title = (String) doc.get("title");
        String content = (String) doc.get("content");

        // 1. 删除旧块
        vectorIndexService.deleteByDocId(docId);

        // 2. 分块
        List<DocumentChunk> chunks = chunkingService.chunk(
                content, docId, title, toLong(doc.get("categoryId")),
                toLong(doc.get("authorId")), null, (Integer) doc.get("status"));

        // 3. 嵌入
        List<float[]> embeddings = embeddingService.embedBatch(
                chunks.stream().map(DocumentChunk::getContent).toList());
        for (int i = 0; i < chunks.size(); i++) {
            chunks.get(i).setEmbedding(embeddings.get(i));
        }

        // 4. 写入ES
        vectorIndexService.indexChunks(chunks);
        progress.incrementAndGet();
    }

    channel.basicAck(deliveryTag, false);
}
十四、集成到现有对话流程
14.1 修改ChatRequestDTO
在 kb-ai/src/main/java/com/knowledge/base/ai/dto/ChatRequestDTO.java 中添加:
/** 是否启用RAG知识库检索增强 */
private boolean enableRag = false;
14.2 修改ChatResponseVO
在 kb-ai/src/main/java/com/knowledge/base/ai/vo/ChatResponseVO.java 中添加:
/** 引用来源列表(RAG模式下返回) */
private List<CitationVO> citations;

/** 是否来自知识库 */
private boolean fromKnowledgeBase;
14.3 在AiChatServiceImpl中添加RAG路由
在 kb-ai/src/main/java/com/knowledge/base/ai/service/impl/AiChatServiceImpl.java 中:
@Autowired(required = false)
private RagChatService ragChatService;

@Override
public ChatResponseVO chat(ChatRequestDTO requestDTO, Long userId) {
    // RAG路由:如果启用了知识库检索增强且RAG服务可用
    if (requestDTO.isEnableRag() && ragChatService != null) {
        try {
            return ragChatService.chatWithContext(requestDTO, userId);
        } catch (Exception e) {
            log.warn("RAG对话失败,降级为普通LLM对话:{}", e.getMessage());
            // 优雅降级:继续执行普通对话流程
        }
    }

    // ... 原有普通对话逻辑
}
同样的RAG路由逻辑也添加到 chatStream() 方法中,调用 ragChatService.chatWithContextStream()。
十五、kb-document 自动索引集成
15.1 创建RagFeignClient
在 kb-document/src/main/java/com/knowledge/base/document/feign/ 下创建:
@FeignClient(name = "kb-ai", path = "/rag/reindex")
public interface RagFeignClient {

    @PostMapping("/{docId}")
    Result<String> reindexDocument(@PathVariable("docId") Long docId);

    @DeleteMapping("/{docId}")
    Result<String> removeFromIndex(@PathVariable("docId") Long docId);
}
15.2 在DocumentServiceImpl中添加自动索引触发
在 kb-document/src/main/java/com/knowledge/base/document/service/impl/DocumentServiceImpl.java 中:
@Resource
private RagFeignClient ragFeignClient;

/** 异步触发RAG重建索引(不阻塞主流程) */
private void triggerRagReindex(Long docId) {
    CompletableFuture.runAsync(() -> {
        try {
            ragFeignClient.reindexDocument(docId);
            log.info("已触发RAG重建索引:documentId={}", docId);
        } catch (Exception e) {
            log.warn("触发RAG重建索引失败(RAG服务不可用,不影响文档操作):docId={}, error={}",
                    docId, e.getMessage());
        }
    });
}

/** 异步触发RAG删除索引 */
private void triggerRagDelete(Long docId) {
    CompletableFuture.runAsync(() -> {
        try {
            ragFeignClient.removeFromIndex(docId);
        } catch (Exception e) {
            log.warn("触发RAG删除索引失败:docId={}", docId);
        }
    });
}
15.3 触发时机
| 操作 | 条件 | RAG动作 |
|---|---|---|
| createDocument | 直接发布(status=1)且有内容 | 重建索引 |
| updateDocument | 内容变更 且 已发布 | 重建索引 |
| updateDocument | 从草稿发布 | 重建索引 |
| updateDocument | 从发布变为非发布 | 删除索引 |
| deleteDocument | 删除成功 | 删除索引 |
| publishDocument | 发布成功 | 重建索引 |
| archiveDocument | 归档成功 | 删除索引 |
所有调用都是异步非阻塞的(CompletableFuture.runAsync),RAG服务不可用不会影响文档CRUD操作。
十六、前端集成
16.1 类型定义
在 src/types/index.ts 中添加:
export interface Citation {
  index: number;
  documentId: number | string;
  documentTitle: string;
  excerpt: string;
  relevanceScore: number;
}

// 扩展AIMessage类型
export interface AIMessage {
  // ... 原有字段
  citations?: Citation[];
  fromKnowledgeBase?: boolean;
}
16.2 API服务
在 src/services/ai.service.ts 中,askStream 方法的请求体增加 enableRag:
body: JSON.stringify({
  content: data.question,
  conversationId: data.conversationId,
  model: data.model,
  enableRag: data.context?.knowledgeBase === true,
}),
16.3 状态管理
在 src/stores/ai.store.ts 中添加:
ragEnabled: false,  // 知识库搜索开关状态

toggleRag: (enabled: boolean) => {
  set({ ragEnabled: enabled });
},
16.4 UI组件
在 src/pages/AIAssistantPage.tsx 中:
- 添加知识库搜索
Switch开关(带Tooltip提示) - AI回答气泡下方展示引用来源标签(带Tooltip悬浮显示文档摘要和相关度)
- 知识库增强标志
Tag
{/* 知识库搜索开关 */}
<Tooltip title={ragEnabled ? '关闭知识库搜索' : '开启知识库搜索,基于文档内容回答'}>
  <Switch
    checked={ragEnabled}
    onChange={toggleRag}
    checkedChildren="知识库"
    unCheckedChildren="通用"
  />
</Tooltip>
{/* 引用来源展示 */}
{message.citations && message.citations.length > 0 && (
  <div style={{ borderTop: '1px solid #f0f0f0', padding: '8px' }}>
    <Text type="secondary" style={{ fontSize: 11 }}>引用来源</Text>
    <Space wrap>
      {message.citations.map(citation => (
        <Tooltip title={
          <div>
            <div>{citation.documentTitle}</div>
            <div>{citation.excerpt}</div>
            <div>相关度: {(citation.relevanceScore * 100).toFixed(0)}%</div>
          </div>
        }>
          <Tag color="blue">[{citation.index}] {citation.documentTitle}</Tag>
        </Tooltip>
      ))}
    </Space>
  </div>
)}
十七、MessagePack序列化约束
所有在RabbitMQ中传输的对象(ReindexMessage)以及通过Feign传输的复杂对象,遵循阿里巴巴Java规范的序列化要求:
- 实现
java.io.Serializable接口 - 定义
serialVersionUID(如private static final long serialVersionUID = 1L;) - 使用
Jackson2JsonMessageConverter进行JSON序列化
测试
1 启动服务
# 启动kb-auth-user服务
cd knowledge-base-backend/kb-auth-user
mvn spring-boot:run

# 启动kb-file服务
cd knowledge-base-backend/kb-file
mvn spring-boot:run

# 启动kb-document服务
cd knowledge-base-backend/kb-document
mvn spring-boot:run

# 启动kb-ai服务
cd knowledge-base-backend/kb-ai
mvn spring-boot:run


# 启动前端
cd knowledge-base-frontend
npm run dev
2 测试功能
访问文档中心页面:http://localhost:3002/documents
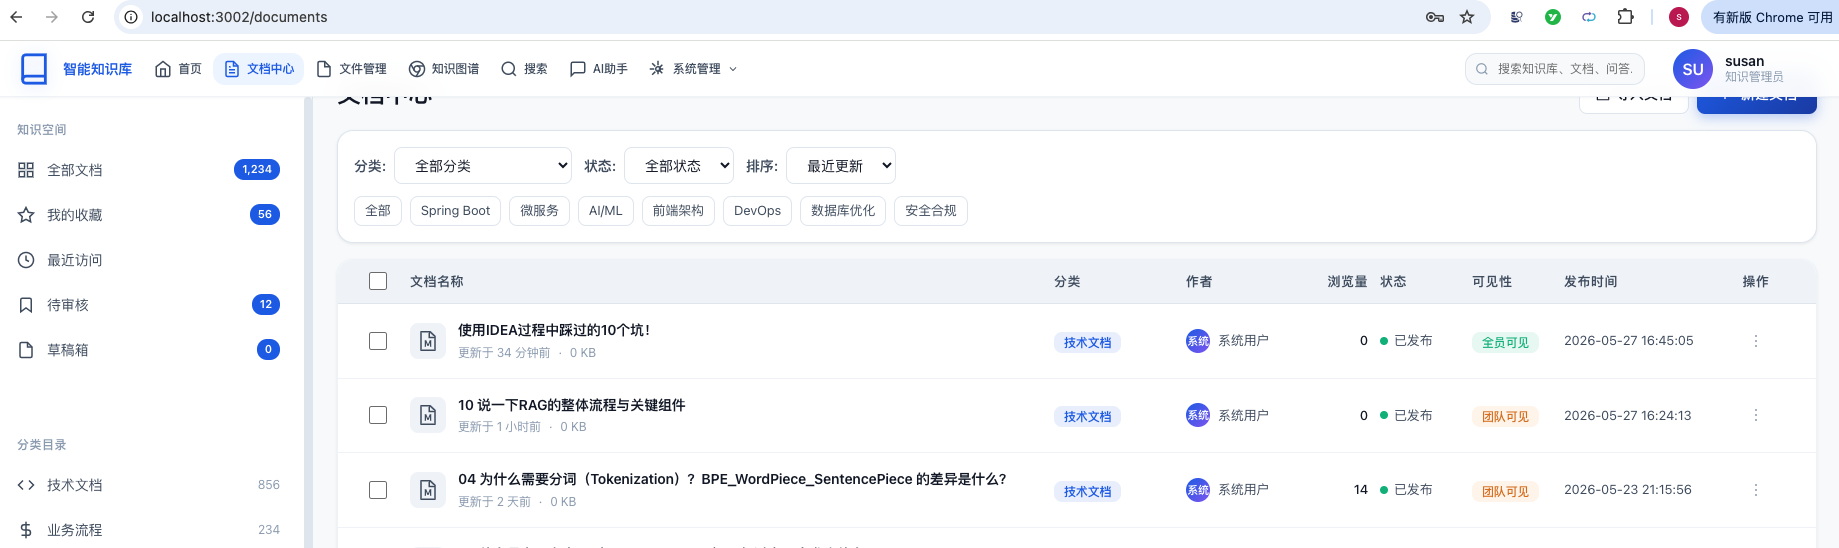
新建了一个《使用IDEA过程中踩过的10个坑!》文档。
内容如下:
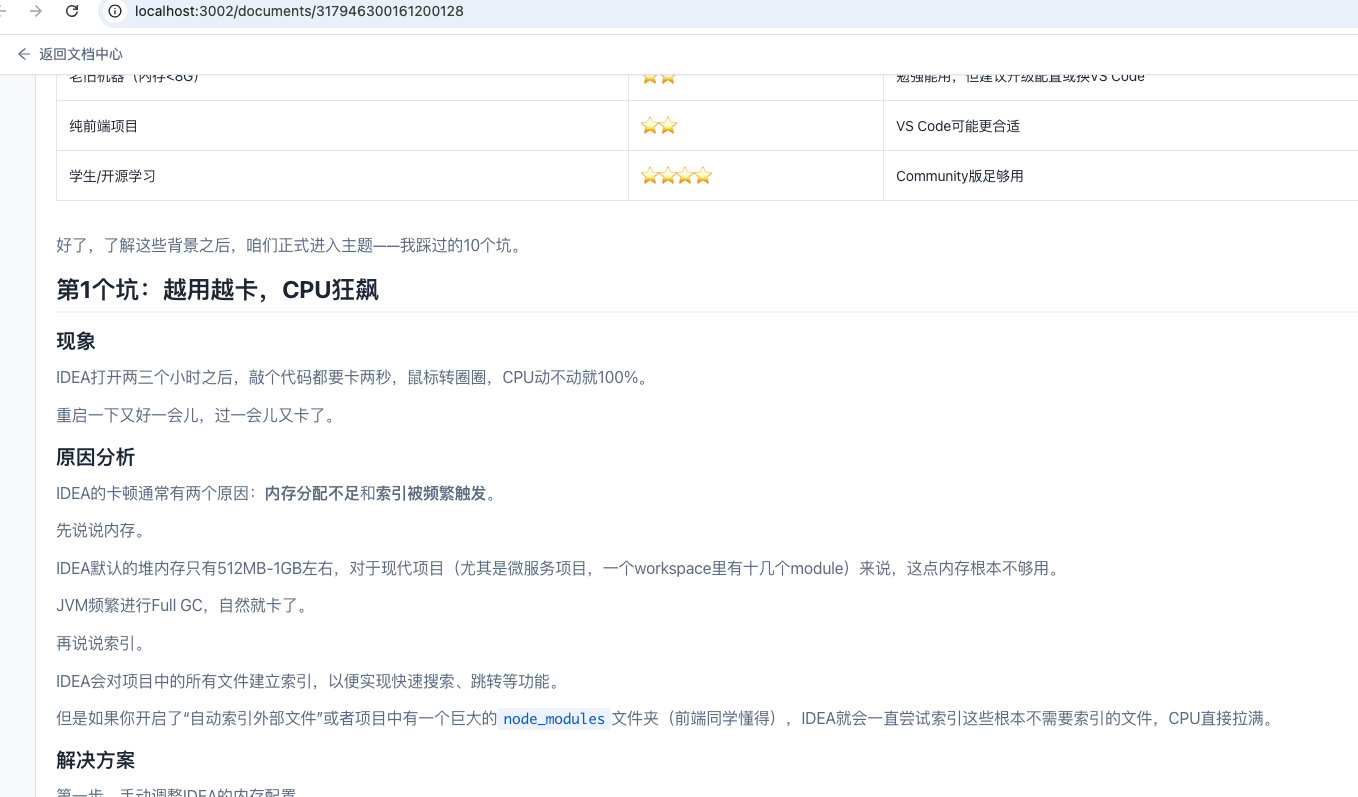
在发布文档的时候,会自动将文档进行分块,添加到ES向量数据库中。
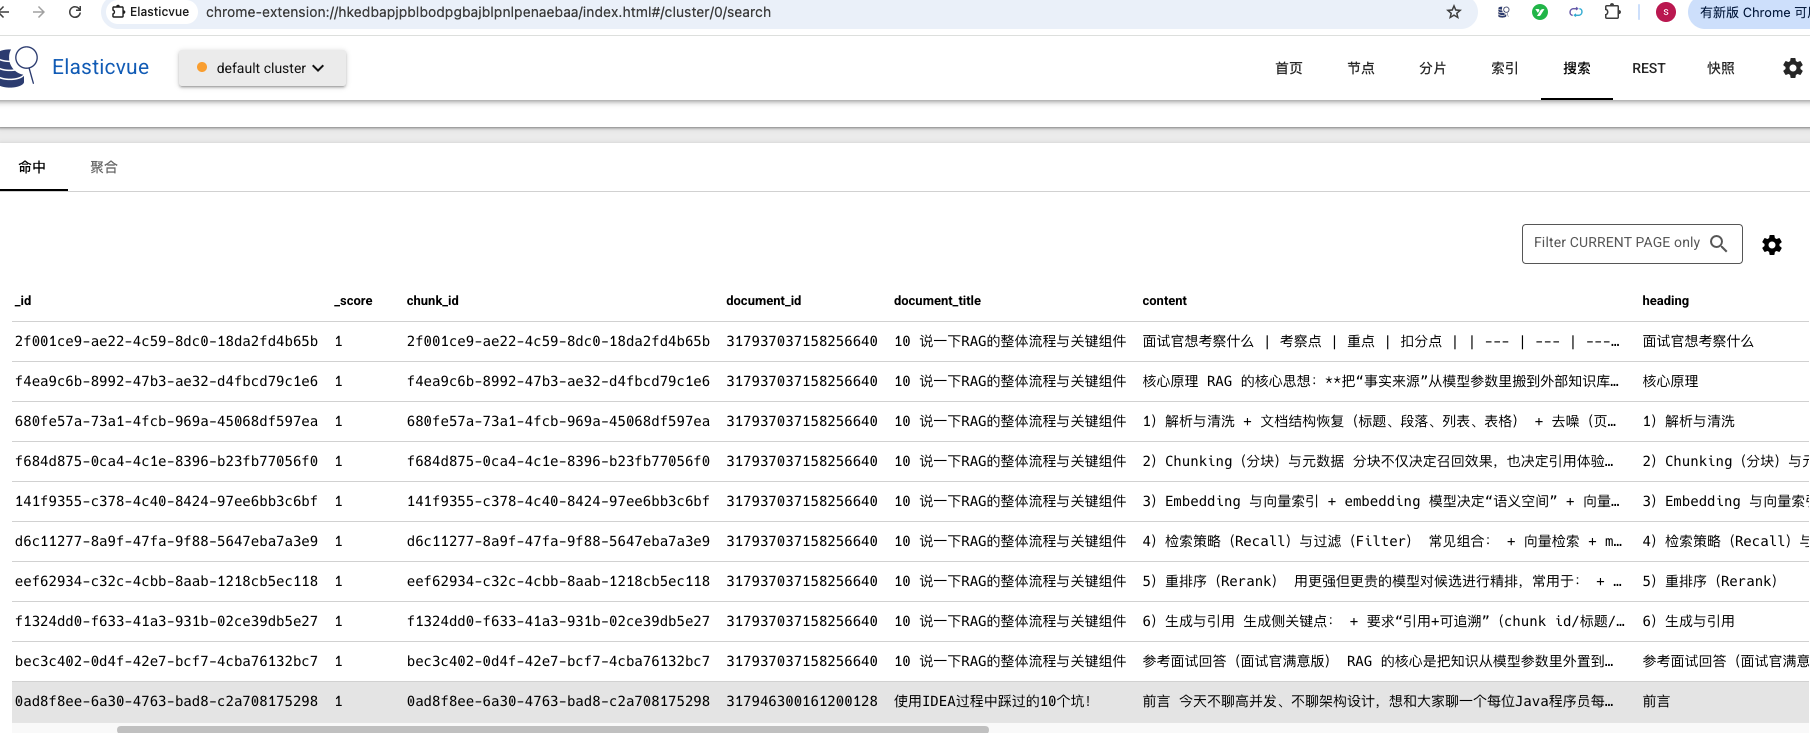
然后访问AI助手页面:http://localhost:3002/ai
选择一个会话:
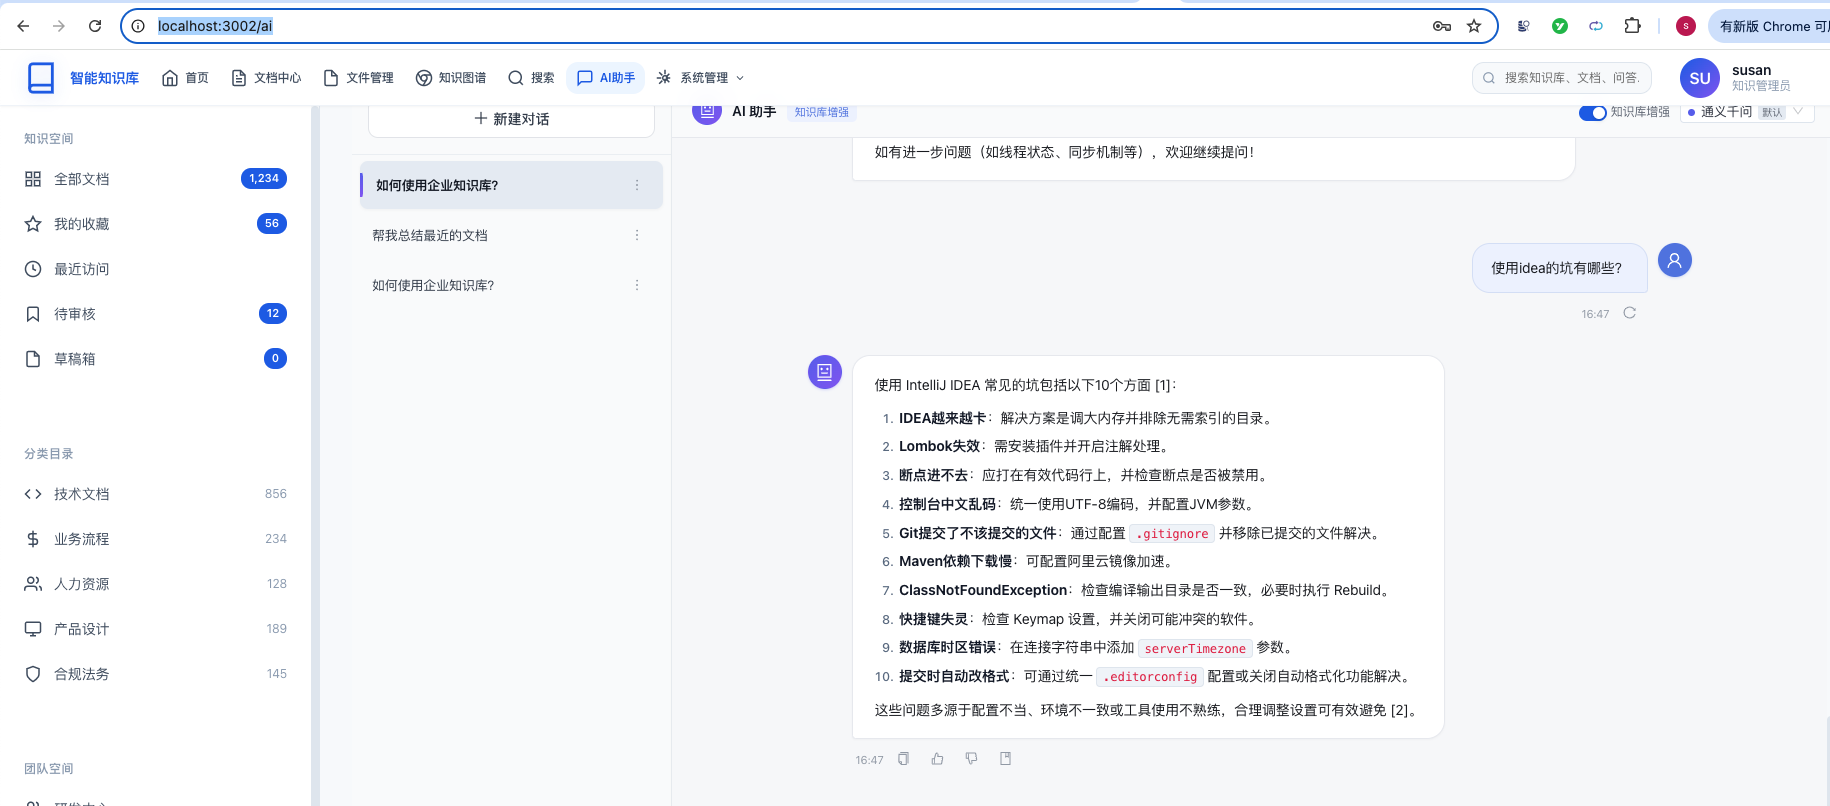
在右上角,默认是启用了知识库增强的。
然后在AI对话框中输入问题:使用idea有哪些坑?
下面AI会根据我们上传的文档,进行RAG知识库增强回复,会去寻找RAG知识库中的内容,如何找到合适的内容,会使用已有的内容回复。
总结
通过本文的学习,你应该能够掌握:
- Elasticsearch作为向量数据库的完整使用方式
- BM25 + kNN混合检索与RRF融合算法
- LangChain4j的嵌入模型和聊天模型集成
- RabbitMQ异步任务处理模式
- Spring Cloud OpenFeign微服务间调用
- 企业级RAG系统的架构设计与实现
- 优雅降级和异常处理的最佳实践
