一、概述
在企业知识库系统中,用户不仅需要手动编写文档,更需要将已有的 Word、PDF、Excel、PPT 等办公文件直接导入系统,自动提取文本内容,进入知识库的 RAG(检索增强生成)、KAG(知识图谱增强生成)和全文搜索管线。
1.1 功能定位
文件解析作为知识入库的「入口管道」,提供以下核心能力:
| 功能模块 | 说明 | 使用场景 |
|---|---|---|
| PDF 解析 | 提取文本、表格、图片、代码块,识别标题层级和段落结构 | 技术文档、论文、报告导入 |
| Word 解析 | 提取段落、标题、列表、表格、内联格式(加粗/斜体/等宽) | 产品文档、用户手册导入 |
| Excel 解析 | 逐 Sheet 提取,自动转换为 Markdown 表格 | 数据报表、配置表导入 |
| PPT 解析 | 逐页提取标题和文本内容 | 方案演示、培训材料导入 |
| 纯文本解析 | 直接读取 .txt / .md 文件 | 日志、笔记、Markdown 文件导入 |
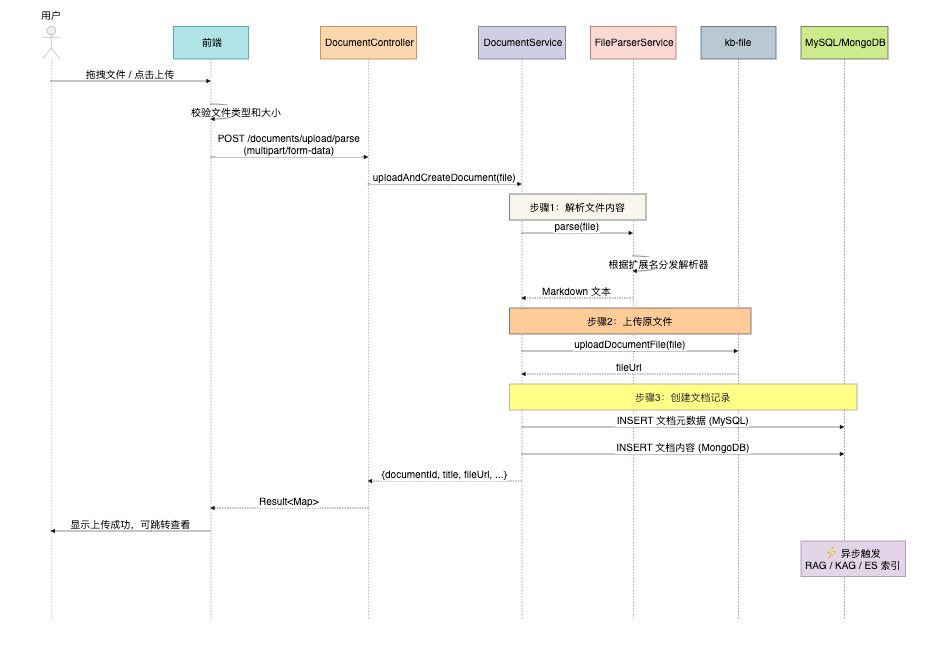
| 统一上传入口 | POST /documents/upload/parse 一键完成上传→解析→入库→发布 | 前端拖拽上传 |
1.2 整体架构
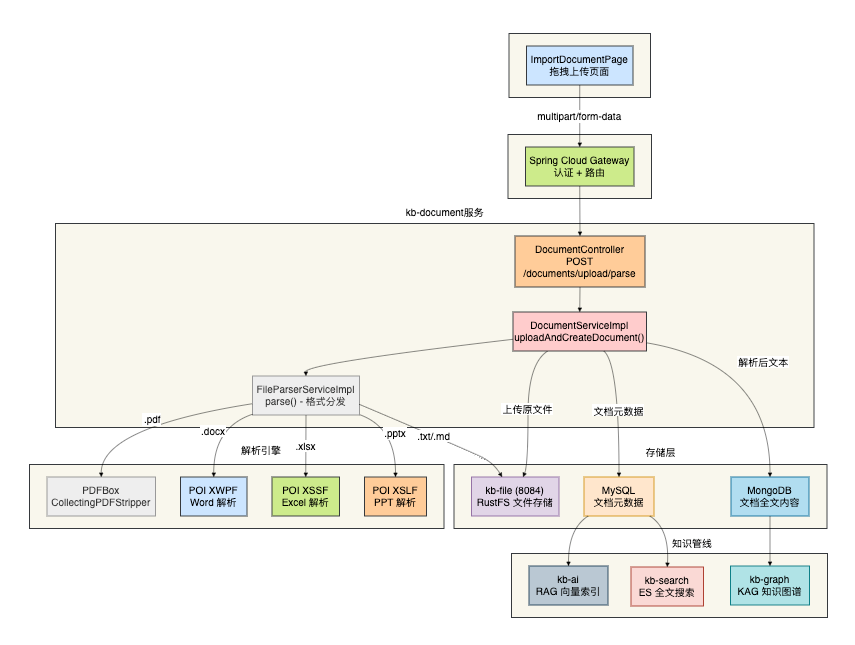
1.3 数据流时序
二、依赖配置
2.1 Maven 依赖
在 kb-document/pom.xml 中添加以下依赖:
<!-- Apache POI - Word / Excel / PPT 解析 -->
<dependency>
    <groupId>org.apache.poi</groupId>
    <artifactId>poi-ooxml</artifactId>
    <version>5.2.5</version>
</dependency>
<!-- Apache PDFBox - PDF 解析 -->
<dependency>
    <groupId>org.apache.pdfbox</groupId>
    <artifactId>pdfbox</artifactId>
    <version>2.0.29</version>
</dependency>
<!-- Feign 表单支持 - 文件上传跨服务调用 -->
<dependency>
    <groupId>io.github.openfeign.form</groupId>
    <artifactId>feign-form</artifactId>
    <version>3.8.0</version>
</dependency>
<dependency>
    <groupId>io.github.openfeign.form</groupId>
    <artifactId>feign-form-spring</artifactId>
    <version>3.8.0</version>
</dependency>
2.2 依赖说明
| 依赖 | 版本 | 用途 |
|---|---|---|
| poi-ooxml | 5.2.5 | 提供 XWPF (Word), XSSF (Excel), XSLF (PPT) 解析能力 |
| pdfbox | 2.0.29 | 提供 PDF 文本提取、图片提取、内容流解析能力 |
| feign-form | 3.8.0 | 支持 Feign 客户端以 multipart/form-data 格式调用 kb-file 服务 |
2.3 上传大小限制配置
在 kb-document/src/main/resources/application.yml 中:
spring:
  servlet:
    multipart:
      max-file-size: 20MB
      max-request-size: 20MB
      file-size-threshold: 2MB
      location: ${java.io.tmpdir}/kb-document-multipart
三、解析服务接口设计
3.1 FileParserService 接口
创建 kb-document/src/main/java/com/knowledge/base/document/service/FileParserService.java:
package com.knowledge.base.document.service;

import org.springframework.web.multipart.MultipartFile;

/**
 * 文件解析Service
 *
 * <p>将上传的 PDF / Word / Excel / PPT / 纯文本文件解析为 Markdown 文本,
 * 解析后的内容可直接存入知识库,走后续的 RAG / KAG 管线。</p>
 *
 * @author Knowledge Base Team
 * @since 1.0.0
 */
public interface FileParserService {

    /**
     * 解析文件内容,返回 Markdown 格式文本
     *
     * @param file 上传的文件
     * @return 解析后的文本内容
     * @throws Exception 解析异常时抛出
     */
    String parse(MultipartFile file) throws Exception;

    /**
     * 判断文件扩展名是否支持解析
     *
     * @param extension 文件扩展名(不含点,如 "pdf", "docx")
     * @return true = 支持解析
     */
    boolean isSupported(String extension);
}
3.2 支持的文件格式
// FileParserServiceImpl 中的常量定义
private static final Set<String> SUPPORTED_EXTENSIONS =
    Set.of("pdf", "doc", "docx", "xls", "xlsx", "ppt", "pptx", "txt", "md");
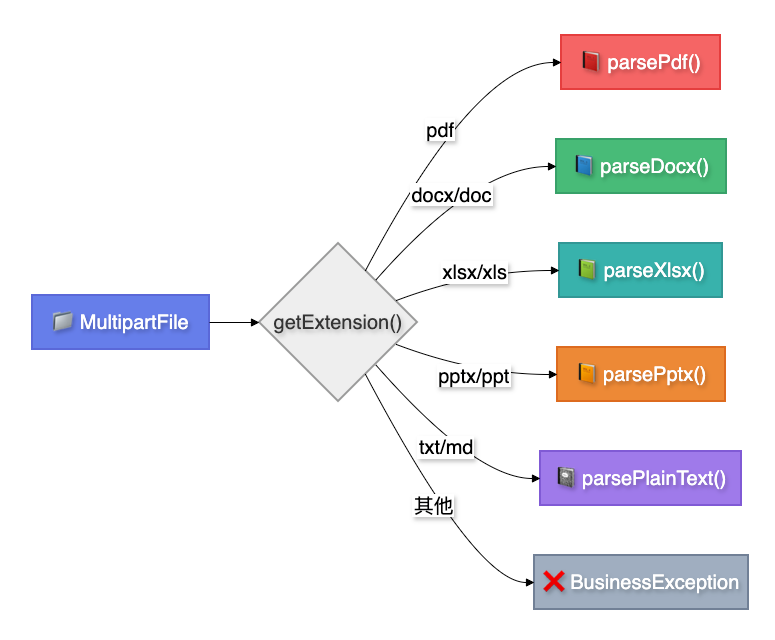
3.3 格式分发策略
四、PDF 解析实现(核心)
PDF 解析是整个文件解析体系中最复杂的部分。不同的 PDF 生成工具(Word 导出、浏览器打印、LaTeX、WPS 等)生成的 PDF 内部结构差异很大,需要综合运用多种技术手段才能提取出结构化的 Markdown。
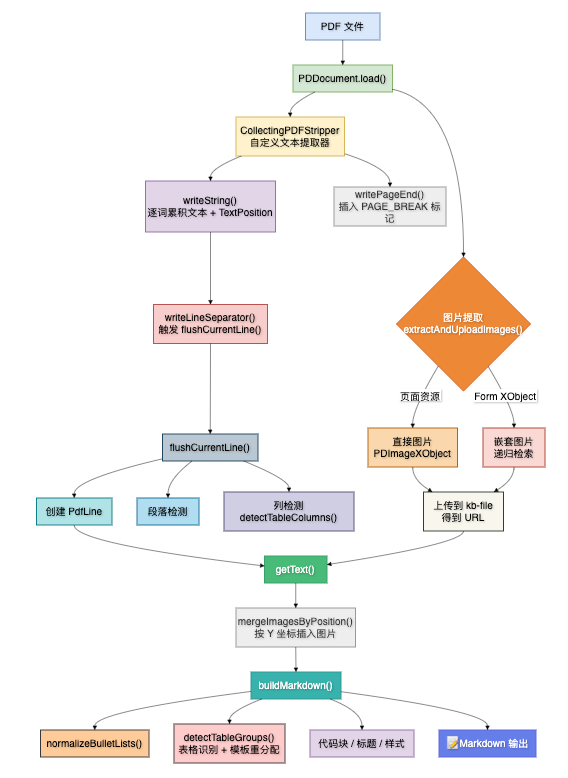
4.1 解析流程总览
4.2 核心数据结构
4.2.1 PdfLine 行数据模型
/**
 * 文本行数据模型,存储从 PDF 提取的元数据
 */
private static class PdfLine {
    final String text;          // 行文本内容
    final float fontSize;       // 最大字号(用于标题检测)
    final boolean isBold;       // 是否含加粗字体
    final boolean isMono;       // 是否含等宽字体(代码信号)
    final float y;              // Y 坐标(页面顶部向下)
    String[] columns;           // 检测到的表格列文本
    float[] columnX;            // 各列的起始 X 坐标
    float[] posXs;              // 原始字符 X 坐标(模板重分配用)
    String[] posTexts;          // 原始字符文本(模板重分配用)
}

/**
 * 图片占位信息
 */
private static class ImagePlacement {
    final float y;              // Y 坐标
    final String url;           // 上传后的图片 URL
}
4.2.2 设计思路
| 字段 | 用途 | 关键决策 |
|---|---|---|
fontSize | 标题层级推断 | 取行内最大字号,与基准字号比较计算层级 |
isBold | 加粗标题 / 行内强调 | 检测字体名称是否含 "bold", "semibold", "heavy", "black" |
isMono | 代码块信号 | 检测字体名是否包含等宽特征:Courier, Consolas, Monaco, Source Code, Fira Code, Menlo 等 |
columns / columnX | 表格列检测 | 由 X 坐标间隙分析得出,非 null 表示该行是表格行 |
posXs / posTexts | 模板列重分配 | 当行内逗号等标点导致列检测失败时,用首行模板修复 |
4.3 CollectingPDFStripper 自定义文本提取器
private static class CollectingPDFStripper extends PDFTextStripper {

    // ── 行累积器(PDFBox 逐词调用 writeString,需累积整行后做列检测) ──
    private final StringBuilder curText = new StringBuilder();
    private final List<TextPosition> curPositions = new ArrayList<>();
    private float curMaxFontSize = 0;
    private boolean curIsBold = false;
    private boolean curIsMono = false;
    private float curY = Float.NaN;
关键配置:
CollectingPDFStripper() throws IOException {
    super();
    setSortByPosition(true);          // 按 Y 坐标排序 → 正确行顺序
    setAddMoreFormatting(false);      // 不添加额外格式(我们自己做)
    setSuppressDuplicateOverlappingText(true); // 去重
}
4.4 逐行累积机制(解决表格检测的关键)
问题背景:PDFBox 的 writeString() 方法是按「词」(被空格/大间隙分隔的连续文本)调用的,而不是按「行」。如果直接在 writeString() 中创建 PdfLine,detectTableColumns() 只能看到**一个单元格**内的字符位置,无法检测跨单元格的列间隙。
解决方案:三阶段累积机制
writeString("考察点", [cell1_positions])   → 累积到 curText / curPositions
writeString("你需要讲的要点", [cell2_positions]) → 继续累积
writeString("扣分点", [cell3_positions])   → 继续累积
writeLineSeparator() → flushCurrentLine() → 整行一起做列检测 ✓
@Override
protected void writeString(String text, List<TextPosition> textPositions)
throws IOException {
String cleaned = text.stripTrailing();
if (cleaned.isEmpty()) return;
// 防御:Y 坐标明显变化(>2pt)→ 提前 flush(新行开始)
if (!Float.isNaN(curY) && maxY - curY > 2f) {
flushCurrentLine();
}
// 累积文本(词间加空格)
if (curText.length() > 0) curText.append(' ');
curText.append(cleaned);
curPositions.addAll(textPositions);
// 累积字体元数据
for (TextPosition tp : textPositions) {
curMaxFontSize = Math.max(curMaxFontSize, tp.getFontSizeInPt());
curY = Math.max(curY, tp.getYDirAdj());
if (tp.getFont() != null) {
String fn = tp.getFont().getName().toLowerCase();
if (fn.contains("bold") || fn.contains("semibold")
|| fn.contains("heavy") || fn.contains("black"))
curIsBold = true;
if (isMonospacePdfFont(fn))
curIsMono = true;
}
}
}
@Override
protected void writeLineSeparator() throws IOException {
flushCurrentLine(); // 行结束 → flush
consecutiveSeparators++;
}4.5 段落边界检测(flushCurrentLine 核心)
private void flushCurrentLine() {
    if (curText.length() == 0) return;

    String text = curText.toString();
    float lineY = curY;
    boolean isParagraphBreak = false;

    // ── 方法 A:Y 间距检测 ──
    if (!Float.isNaN(prevLineY) && !Float.isNaN(lineY)) {
        float gap = lineY - prevLineY;  // 正值 = 下一行更靠下
        if (gap > 0 && runningLineGap > 0) {
            if (gap > runningLineGap * 1.8f) {
                isParagraphBreak = true;  // 大间距 → 确定是新段落
            } else if (gap > runningLineGap * 1.25f
                       && prevLineEndsWithSentencePunct()) {
                isParagraphBreak = true;  // 中等间距 + 前一行以。!?结尾
            }
        }
        // 指数移动平均更新行间距
        if (gap > 0 && runningLineGap > 0 && gap <= runningLineGap * 1.5f) {
            runningLineGap = runningLineGap * 0.7f + gap * 0.3f;
        } else if (gap > 0 && runningLineGap == 0) {
            runningLineGap = gap;
        }
    }
    prevLineY = lineY;

    // ── 方法 B:文本特征检测(Y 间距未检测到时的补充) ──
    if (!isParagraphBreak && prevLineEndsWithSentencePunct()) {
        if (text.length() <= 15) isParagraphBreak = true;  // 短行 → 独立段落
        else if (looksLikeSectionStart(text)) isParagraphBreak = true;  // 新章节标记
    }

    // ── 方法 C:前一行是短独立行(迷你标题) ──
    if (!isParagraphBreak && isPrevLineShortStandalone()) {
        isParagraphBreak = true;
    }

    // ── 列检测:此时 curPositions 包含整行所有字符 ──
    PdfLine pdfLine = new PdfLine(text, curMaxFontSize, curIsBold, curIsMono, lineY);
    detectTableColumns(pdfLine, curPositions);
    lines.add(pdfLine);

    // 重置累积器
    curText.setLength(0); curPositions.clear();
    curMaxFontSize = 0; curIsBold = false;
    curIsMono = false; curY = Float.NaN;
}
4.6 表格列检测算法
4.6.1 基本间隙检测
基于 X 坐标分析,找到同一行字符间超过 12pt 的水平间隙,判定为列边界。
private void detectTableColumns(PdfLine line, List<TextPosition> positions) {
    if (positions.size() < 3) return;

    // 按 X 坐标排序
    List<TextPosition> sorted = new ArrayList<>(positions);
    sorted.sort(Comparator.comparingDouble(TextPosition::getXDirAdj));

    // 存储原始位置数据(供后续模板重分配使用)
    line.posXs = new float[sorted.size()];
    line.posTexts = new String[sorted.size()];
    for (int i = 0; i < sorted.size(); i++) {
        line.posXs[i] = sorted.get(i).getXDirAdj();
        line.posTexts[i] = sorted.get(i).getUnicode();
    }

    // 找出列间隙(X 间距 > 12pt)
    List<Integer> gapBefore = new ArrayList<>();
    float prevEndX = -Float.MAX_VALUE;
    for (int i = 0; i < sorted.size(); i++) {
        TextPosition tp = sorted.get(i);
        float x = tp.getXDirAdj();
        if (i > 0 && prevEndX > 0 && x - prevEndX > 12f) {
            gapBefore.add(i);
        }
        prevEndX = Math.max(prevEndX, x + tp.getWidthDirAdj());
    }

    if (gapBefore.isEmpty()) return;

    // 提取各列文本
    int colCount = gapBefore.size() + 1;
    StringBuilder[] colTexts = new StringBuilder[colCount];
    float[] colX = new float[colCount];
    Arrays.setAll(colTexts, i -> new StringBuilder());

    int col = 0;
    for (int i = 0; i < sorted.size(); i++) {
        while (col < gapBefore.size() && i == gapBefore.get(col)) col++;
        if (colTexts[col].length() == 0)
            colX[col] = sorted.get(i).getXDirAdj();
        colTexts[col].append(sorted.get(i).getUnicode());
    }

    line.columns = new String[colCount];
    for (int c = 0; c < colCount; c++)
        line.columns[c] = colTexts[c].toString().strip();
    line.columnX = colX;
}
4.6.2 模板列重分配(解决逗号 / 空单元格问题)
问题 1:单元格内中文逗号 , 产生的微小间隙可能被误判为列边界 → 行获得 4 列而不是 3 列。
问题 2:某些行某列为空(无文本)→ gap 检测只找到 2 列。
解决:以第一行的列 X 坐标为「模板」,将后续行的字符按最近列中心重新分配。
/**
 * 使用首行列 X 坐标模板,将本行原始字符重分配到正确列。
 */
private void applyColumnTemplate(PdfLine line, float[] templateColX) {
    if (line.posXs == null || templateColX == null) return;

    // 计算列边界中点(用于字符→列分配)
    float[] midpoints = new float[templateColX.length - 1];
    for (int i = 0; i < templateColX.length - 1; i++)
        midpoints[i] = (templateColX[i] + templateColX[i + 1]) / 2;

    StringBuilder[] colTexts = new StringBuilder[templateColX.length];
    Arrays.setAll(colTexts, i -> new StringBuilder());

    for (int i = 0; i < line.posXs.length; i++) {
        float x = line.posXs[i];
        int col = templateColX.length - 1;
        for (int m = 0; m < midpoints.length; m++) {
            if (x <= midpoints[m]) { col = m; break; }
        }
        colTexts[col].append(line.posTexts[i]);
    }

    line.columns = new String[templateColX.length];
    for (int c = 0; c < templateColX.length; c++)
        line.columns[c] = colTexts[c].toString().strip();
    line.columnX = templateColX;
}
4.7 表格组检测与 Markdown 格式化
/**
 * 扫描所有行,检测连续表格行组(列数相同、X 对齐或可模板重分配),
 * 并预格式化为 Markdown 表格。
 */
private Map<Integer, String> detectTableGroups() {
    Map<Integer, String> result = new LinkedHashMap<>();

    for (int i = 0; i < lines.size(); i++) {
        PdfLine line = lines.get(i);
        if (line.columns == null || line.columns.length < 2) continue;
        float[] templateColX = line.columnX;

        int start = i, end = i + 1;
        while (end < lines.size()) {
            PdfLine nextLine = lines.get(end);

            // 尝试①:直接匹配(列数相同 + X 对齐)
            if (nextLine.columns != null
                    && nextLine.columns.length == line.columns.length
                    && columnsAligned(line.columnX, nextLine.columnX)) {
                end++;
                continue;
            }

            // 尝试②:模板重分配
            if (nextLine.posXs != null && templateColX != null) {
                applyColumnTemplate(nextLine, templateColX);
                if (nextLine.columns != null
                        && nextLine.columns.length == line.columns.length) {
                    end++;
                    continue;
                }
            }
            break;
        }

        if (end - start < 2) continue; // 单行不算表格

        // 格式化为 Markdown 表格
        StringBuilder table = new StringBuilder();
        for (int r = start; r < end; r++) {
            PdfLine row = lines.get(r);
            table.append("|");
            for (String col : row.columns)
                table.append(' ').append(col.isEmpty() ? " " : col).append(" |");
            table.append('\n');
            if (r == start) {  // 表头分隔行
                table.append("|");
                for (int c = 0; c < row.columns.length; c++)
                    table.append(" --- |");
                table.append('\n');
            }
        }

        result.put(start, table.toString());
        i = end - 1;
    }
    return result;
}
4.8 图片提取
4.8.1 递归图片收集
/**
 * 递归收集 PDResources 及其 Form XObject 子资源中的所有图片。
 * 许多 PDF 生成器(PowerPoint 导出、LaTeX 等)会把图片嵌套在 Form XObject 中,
 * 仅遍历页面顶层的 getXObjectNames() 会漏掉这些图片。
 */
private void collectImageXObjects(PDResources resources,
                                   Map<COSName, PDImageXObject> images) {
    if (resources == null) return;
    try {
        for (COSName name : resources.getXObjectNames()) {
            PDXObject xobj;
            try {
                xobj = resources.getXObject(name);
            } catch (Exception e) { continue; }

            if (xobj instanceof PDImageXObject image) {
                images.put(name, image);
            } else if (xobj instanceof PDFormXObject form) {
                // 递归进入 Form XObject 子资源
                collectImageXObjects(form.getResources(), images);
            }
        }
    } catch (Exception e) {
        log.debug("递归收集图片失败: {}", e.getMessage());
    }
}
4.8.2 图片 Y 坐标定位
通过解析 PDF 内容流,跟踪 cm(变换矩阵)和 Do(调用 XObject)操作符,计算图片在页面上的 Y 坐标。
/**
 * 解析 PDF 每页的内容流,找到每个图片 XObject 的 Y 坐标。
 *
 * <p>通过跟踪 cm(变换矩阵)和 Do(调用 XObject)操作符,
 * 计算图片的 Y 位置(与 getYDirAdj 坐标系一致:从页面顶部向下)。</p>
 */
private Map<Integer, Map<COSName, Float>> findImagePositions(PDDocument document) {
    Map<Integer, Map<COSName, Float>> allPositions = new LinkedHashMap<>();

    for (int p = 0; p < document.getNumberOfPages(); p++) {
        PDPage page = document.getPage(p);
        float pageHeight = page.getMediaBox().getHeight();

        PDFStreamParser parser = new PDFStreamParser(page);
        parser.parse();
        List<Object> tokens = parser.getTokens();

        float tx = 0, ty = 0;
        Deque<float[]> saved = new ArrayDeque<>();

        for (int i = 0; i < tokens.size(); i++) {
            Object token = tokens.get(i);
            String opName = getOperatorName(token);

            if (opName != null) {
                switch (opName) {
                    case "q" -> saved.push(new float[]{tx, ty});
                    case "Q" -> {
                        if (!saved.isEmpty()) {
                            float[] prev = saved.pop();
                            tx = prev[0]; ty = prev[1];
                        }
                    }
                    case "Do" -> {
                        if (i > 0 && tokens.get(i - 1) instanceof COSName xobjName) {
                            float yDirAdj = pageHeight - ty;
                            pagePositions.put(xobjName, yDirAdj);
                        }
                    }
                }
            } else if (token instanceof COSNumber) {
                // 检查是否为 "a b c d e f cm" 变换矩阵
                if (i + 6 < tokens.size() && isMatrixOp(tokens, i)) {
                    float a = ((COSNumber) tokens.get(i + 0)).floatValue();
                    float b = ((COSNumber) tokens.get(i + 1)).floatValue();
                    float c = ((COSNumber) tokens.get(i + 2)).floatValue();
                    float d = ((COSNumber) tokens.get(i + 3)).floatValue();
                    float e = ((COSNumber) tokens.get(i + 4)).floatValue();
                    float f = ((COSNumber) tokens.get(i + 5)).floatValue();
                    // cm 是矩阵乘法: CTM' = CTM × [a b c d e f]
                    float newTx = a * tx + c * ty + e;
                    float newTy = b * tx + d * ty + f;
                    tx = newTx; ty = newTy;
                    i += 6;
                }
            }
        }
        allPositions.put(p, pagePositions);
    }
    return allPositions;
}
4.8.3 图片按 Y 坐标插入
private void mergeImagesByPosition() {
List<PdfLine> merged = new ArrayList<>();
int pageStart = 0;
for (int i = 0; i < lines.size(); i++) {
if (lines.get(i).text.startsWith("__PAGE_BREAK__")) {
mergePageLines(currentPage + 1, pageStart, i, merged);
currentPage++;
pageStart = i + 1; // 跳过 PAGE_BREAK 标记
}
}
if (pageStart < lines.size())
mergePageLines(currentPage + 1, pageStart, lines.size(), merged);
lines.clear();
lines.addAll(merged);
}
private void mergePageLines(int pageNum, int fromIdx, int toIdx,
List<PdfLine> output) {
List<ImagePlacement> images = pageImages != null
? pageImages.get(pageNum) : null;
if (images == null || images.isEmpty()) {
for (int i = fromIdx; i < toIdx; i++)
output.add(lines.get(i));
return;
}
int imgIdx = 0;
for (int i = fromIdx; i < toIdx; i++) {
PdfLine line = lines.get(i);
// Y 坐标 ≤ 当前文本行的图片插入在前
while (imgIdx < images.size()
&& !Float.isNaN(line.y)
&& images.get(imgIdx).y <= line.y) {
output.add(new PdfLine(".url + ")",
0, false, false));
output.add(new PdfLine("", 0, false, false)); // 空行分隔
imgIdx++;
}
output.add(line);
}
// 剩余图片放页尾
while (imgIdx < images.size()) {
output.add(new PdfLine(".url + ")",
0, false, false));
output.add(new PdfLine("", 0, false, false));
imgIdx++;
}
}4.9 Markdown 构建
private String buildMarkdown() {
    // 1. 归一化列表符号(• → -)
    normalizeBulletLists();

    // 2. 检测表格组
    Map<Integer, String> tableBlocks = detectTableGroups();

    // 3. 计算基准字号(用于标题层级推断)
    float baseFontSize = computeBaseFontSize();

    StringBuilder md = new StringBuilder();
    boolean inCodeBlock = false;
    boolean prevWasBullet = false;

    for (int i = 0; i < lines.size(); i++) {
        PdfLine line = lines.get(i);

        // 表格行 → 输出预格式化的 Markdown 表格
        if (tableBlocks.containsKey(i)) {
            if (inCodeBlock) { md.append("```\n"); inCodeBlock = false; }
            md.append('\n').append(tableBlocks.get(i)).append('\n');
            continue;
        }

        // 代码块检测
        boolean isCodeLine = line.isMono || looksLikeCodeLine(line.text);
        // ... 代码块开启/关闭逻辑 ...

        // 标题层级推断
        int headingLevel = computeHeadingLevel(
            line.fontSize, baseFontSize, line.isBold);

        // 列表项 → 非列表项转换时插入空行
        boolean isBullet = line.text.startsWith("- ");
        if (prevWasBullet && !isBullet && headingLevel == 0) {
            md.append('\n');
        }

        md.append(formatted).append('\n');
        prevWasBullet = (headingLevel == 0 && isBullet);
    }

    return cleanMarkdown(md.toString());
}
4.10 完整 parsePdf 入口
private static final Set<String> SUPPORTED_EXTENSIONS =
    Set.of("pdf", "doc", "docx", "xls", "xlsx", "ppt", "pptx", "txt", "md");

@Override
public String parse(MultipartFile file) throws Exception {
    String originalFilename = file.getOriginalFilename();
    String extension = FileUtil.extName(originalFilename).toLowerCase();

    if (!isSupported(extension)) {
        throw new BusinessException("不支持的文件格式: " + extension);
    }

    return switch (extension) {
        case "pdf" -> parsePdf(file);
        case "docx", "doc" -> parseDocx(file);
        case "xlsx", "xls" -> parseXlsx(file);
        case "pptx", "ppt" -> parsePptx(file);
        default -> parsePlainText(file);
    };
}

@Override
public boolean isSupported(String extension) {
    return extension != null && SUPPORTED_EXTENSIONS.contains(extension.toLowerCase());
}

private String parsePdf(MultipartFile file) throws Exception {
    long start = System.currentTimeMillis();
    try (PDDocument document = PDDocument.load(file.getInputStream())) {
        // 1. 提取图片并上传
        Map<Integer, List<ImagePlacement>> pageImages
            = extractAndUploadImages(document);

        // 2. 提取文本(自定义 Stripper)
        CollectingPDFStripper stripper = new CollectingPDFStripper();
        stripper.setImagePlacements(pageImages);
        String markdown = stripper.getText(document);

        log.info("PDF 解析完成: file={}, pages={}, chars={}, time={}ms",
            file.getOriginalFilename(), document.getNumberOfPages(),
            markdown.length(), System.currentTimeMillis() - start);
        return markdown;
    }
}
五、Word 解析实现(.docx)
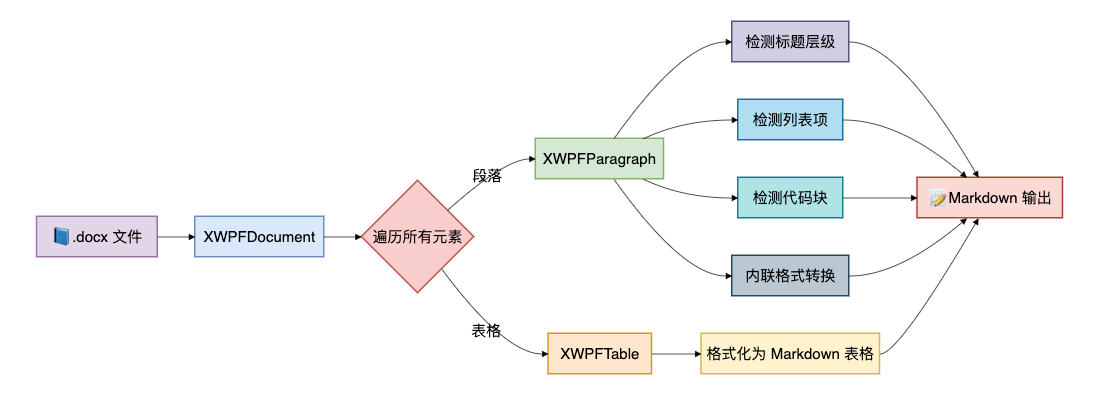
5.1 核心原理
使用 Apache POI XWPF 读取 docx 文件的 XML 结构,逐段落提取文本和样式,转换为 Markdown。
5.2 标题检测
/**
 * 检测 Word 段落是否为标题,返回层级(1-6),0 表示非标题。
 */
private int getDocxHeadingLevel(XWPFParagraph paragraph) {
    // 方式1:outlineLvl 属性(Word 内置标题样式)
    String styleId = paragraph.getStyleID();
    if (styleId != null) {
        if (styleId.matches("(?i)heading\\d+")) {
            int level = Integer.parseInt(styleId.replaceAll("(?i)heading", ""));
            return Math.min(level, 6);
        }
    }

    // 方式2:通过段落属性中的 outlineLvl 检测
    CTPPr ppr = paragraph.getCTP().getPPr();
    if (ppr != null && ppr.getOutlineLvl() != null) {
        int level = ppr.getOutlineLvl().getVal().intValue() + 1;
        return Math.min(level, 6);
    }

    // 方式3:中文编号模式(一、二、... / 1. 2. ...)
    String text = paragraph.getText().trim();
    if (text.matches("^[一二三四五六七八九十]+[、,\\s].*") ||
        text.matches("^\\d+[.、)]\\s.*")) {
        // 根据字号和加粗判断是否为标题
        // ...
    }

    return 0;
}
5.3 列表检测
/**
 * 检测 Word 段落是否为列表项。
 * 支持有序列表(编号)和无序列表(项目符号)。
 */
private String detectDocxListPrefix(XWPFParagraph paragraph) {
    // 通过 numPr 元素检测(Word 自动编号/项目符号)
    CTPPr ppr = paragraph.getCTP().getPPr();
    if (ppr != null && ppr.getNumPr() != null) {
        CTNumPr numPr = ppr.getNumPr();
        if (numPr.getNumId() != null) {
            // 有序列表:提取编号
            if (numPr.getIlvl() != null) {
                return "1. ";  // 简化为有序前缀,实际可从 numbering.xml 解析
            }
            // 无序列表
            return "- ";
        }
    }

    // 通过文本模式检测手动编号
    String text = paragraph.getText().trim();
    if (text.matches("^[•\\-*]\\s.*")) return "- ";
    if (text.matches("^\\d+[.)]\\s.*")) return "1. ";

    return null;
}
5.4 内联格式转换
private String formatDocxRun(XWPFRun run, String text) {
    if (text.isEmpty()) return text;

    String formatted = text;

    // 等宽字体 → 代码标记
    String fontFamily = run.getFontFamily();
    if (fontFamily != null && isMonoFont(fontFamily)) {
        if (text.contains("`")) {
            formatted = "``" + text + "``";
        } else {
            formatted = "`" + text + "`";
        }
        return formatted;
    }

    // 加粗
    if (run.isBold()) formatted = "**" + formatted + "**";

    // 斜体
    if (run.isItalic()) formatted = "*" + formatted + "*";

    // 下划线(用 HTML 标签保留)
    if (run.getUnderline() != UnderlinePatterns.NONE) {
        formatted = "<u>" + formatted + "</u>";
    }

    return formatted;
}
5.5 表格转 Markdown
private String formatDocxTable(XWPFTable table) {
    StringBuilder sb = new StringBuilder("\n");

    List<XWPFTableRow> rows = table.getRows();
    for (int r = 0; r < rows.size(); r++) {
        XWPFTableRow row = rows.get(r);
        sb.append("|");
        for (XWPFTableCell cell : row.getTableCells()) {
            String cellText = cell.getText().replace("\n", " ").trim();
            sb.append(' ').append(cellText.isEmpty() ? " " : cellText).append(" |");
        }
        sb.append('\n');

        // 首行后添加分隔线
        if (r == 0) {
            sb.append("|");
            for (int c = 0; c < row.getTableCells().size(); c++) {
                sb.append(" --- |");
            }
            sb.append('\n');
        }
    }

    return sb.append('\n').toString();
}
5.6 解析入口
private String parseDocx(MultipartFile file) throws Exception {
    StringBuilder md = new StringBuilder();

    try (XWPFDocument document = new XWPFDocument(file.getInputStream())) {
        // 获取所有 body 元素(段落 + 表格按顺序)
        for (IBodyElement element : document.getBodyElements()) {
            if (element instanceof XWPFParagraph paragraph) {
                String text = paragraph.getText();
                if (text.trim().isEmpty()) {
                    md.append('\n');
                    continue;
                }

                int headingLevel = getDocxHeadingLevel(paragraph);
                String listPrefix = (headingLevel == 0)
                    ? detectDocxListPrefix(paragraph) : null;

                // 标题输出
                if (headingLevel > 0) {
                    md.append("#".repeat(headingLevel)).append(' ');
                    md.append(buildDocxParagraphText(paragraph)).append('\n');
                    continue;
                }

                // 列表输出
                if (listPrefix != null) {
                    md.append(listPrefix)
                      .append(buildDocxParagraphText(paragraph))
                      .append('\n');
                    continue;
                }

                // 普通段落
                md.append(buildDocxParagraphText(paragraph))
                  .append('\n').append('\n');

            } else if (element instanceof XWPFTable table) {
                md.append(formatDocxTable(table));
            }
        }
    }

    return md.toString();
}
六、Excel 解析实现(.xlsx)
6.1 解析策略
逐 Sheet 读取,将每个 Sheet 转换为一个 Markdown 表格(首行为表头)。
private String parseXlsx(MultipartFile file) throws Exception {
    StringBuilder md = new StringBuilder();

    try (XSSFWorkbook workbook = new XSSFWorkbook(file.getInputStream())) {
        for (int s = 0; s < workbook.getNumberOfSheets(); s++) {
            XSSFSheet sheet = workbook.getSheetAt(s);
            String sheetName = sheet.getSheetName();

            // Sheet 标题
            md.append("## ").append(sheetName).append("\n\n");

            // 获取有效行列范围
            int firstRow = sheet.getFirstRowNum();
            int lastRow = sheet.getLastRowNum();
            if (lastRow < firstRow) continue;

            // 确定最大列数
            int maxCols = 0;
            for (int r = firstRow; r <= lastRow; r++) {
                XSSFRow row = sheet.getRow(r);
                if (row != null) maxCols = Math.max(maxCols, row.getLastCellNum());
            }

            // 转换为 Markdown 表格
            for (int r = firstRow; r <= lastRow; r++) {
                XSSFRow row = sheet.getRow(r);
                md.append("|");
                for (int c = 0; c < maxCols; c++) {
                    String cellValue = getCellValue(row, c);
                    md.append(' ').append(cellValue.isEmpty() ? " " : cellValue)
                      .append(" |");
                }
                md.append('\n');

                // 首行后添加分隔线
                if (r == firstRow) {
                    md.append("|");
                    for (int c = 0; c < maxCols; c++) md.append(" --- |");
                    md.append('\n');
                }
            }
            md.append('\n');
        }
    }

    return md.toString();
}

/**
 * 获取单元格值(处理各种数据类型)
 */
private String getCellValue(XSSFRow row, int colIndex) {
    if (row == null) return "";
    XSSFCell cell = row.getCell(colIndex);
    if (cell == null) return "";

    return switch (cell.getCellType()) {
        case STRING  -> cell.getStringCellValue().trim();
        case NUMERIC -> {
            if (DateUtil.isCellDateFormatted(cell)) {
                yield cell.getLocalDateTimeCellValue().toString();
            }
            double val = cell.getNumericCellValue();
            // 整数值去掉小数点
            yield val == Math.floor(val) && !Double.isInfinite(val)
                ? String.valueOf((long) val)
                : String.valueOf(val);
        }
        case BOOLEAN -> String.valueOf(cell.getBooleanCellValue());
        case FORMULA -> {
            try { yield cell.getStringCellValue().trim(); }
            catch (Exception e) { yield String.valueOf(cell.getNumericCellValue()); }
        }
        default -> "";
    };
}
七、PPT 解析实现(.pptx)
7.1 解析策略
逐页读取幻灯片,提取每页的标题和文本内容。
private String parsePptx(MultipartFile file) throws Exception {
    StringBuilder md = new StringBuilder();

    try (XMLSlideShow ppt = new XMLSlideShow(file.getInputStream())) {
        List<XSLFSlide> slides = ppt.getSlides();

        for (int i = 0; i < slides.size(); i++) {
            XSLFSlide slide = slides.get(i);

            // 页标题
            md.append("## 第 ").append(i + 1).append(" 页\n\n");

            // 尝试从标题占位符获取标题
            String slideTitle = extractSlideTitle(slide);
            if (slideTitle != null && !slideTitle.isEmpty()) {
                md.append("### ").append(slideTitle).append("\n\n");
            }

            // 提取所有形状的文本
            for (XSLFShape shape : slide.getShapes()) {
                extractShapeText(shape, md);
            }

            md.append('\n');
        }
    }

    return md.toString();
}

/**
 * 从幻灯片标题占位符提取标题
 */
private String extractSlideTitle(XSLFSlide slide) {
    for (XSLFShape shape : slide.getShapes()) {
        if (shape instanceof XSLFTextShape textShape) {
            if ("title".equalsIgnoreCase(textShape.getPlaceholder())) {
                return textShape.getText().trim();
            }
        }
    }
    // 回退:取第一个 XSLFTextShape 的文本
    for (XSLFShape shape : slide.getShapes()) {
        if (shape instanceof XSLFTextShape textShape) {
            String text = textShape.getText().trim();
            if (!text.isEmpty()) return text;
        }
    }
    return null;
}

/**
 * 递归提取形状文本(包括组合形状)
 */
private void extractShapeText(XSLFShape shape, StringBuilder md) {
    if (shape instanceof XSLFGroupShape group) {
        for (XSLFShape child : group.getShapes()) {
            extractShapeText(child, md);
        }
    } else if (shape instanceof XSLFTextShape textShape) {
        // 跳过已作为标题的占位符
        if ("title".equalsIgnoreCase(textShape.getPlaceholder())) return;

        String text = textShape.getText().trim();
        if (!text.isEmpty()) {
            // 内联格式
            StringBuilder formatted = new StringBuilder();
            for (XSLFTextParagraph para : textShape.getTextParagraphs()) {
                for (XSLFTextRun run : para.getTextRuns()) {
                    String fragment = run.getRawText();
                    if (fragment == null) continue;
                    if (run.isBold()) fragment = "**" + fragment + "**";
                    if (run.isItalic()) fragment = "*" + fragment + "*";
                    formatted.append(fragment);
                }
            }
            md.append(formatted.toString().trim()).append("\n\n");
        }
    } else if (shape instanceof XSLFTable table) {
        // 表格格式化为 Markdown
        md.append(formatPptxTable(table));
    }
}
八、纯文本解析实现
/**
 * 纯文本解析:直接以 UTF-8 读取文件内容。
 * 支持 .txt 和 .md 文件。
 */
private String parsePlainText(MultipartFile file) throws Exception {
    return new String(file.getBytes(), StandardCharsets.UTF_8);
}
九、上传流程整合
9.1 DocumentService 接口扩展
在 DocumentService.java 中新增方法签名:
/**
 * 上传文件 → 解析内容 → 创建文档 → 返回结果
 *
 * @param file 上传的文件
 * @return 包含 documentId、title、fileUrl 等信息的 Map
 */
Map<String, Object> uploadAndCreateDocument(MultipartFile file);
9.2 DocumentServiceImpl 核心实现
@Override
@Transactional(rollbackFor = Exception.class)
public Map<String, Object> uploadAndCreateDocument(MultipartFile file) {
    // 1. 参数校验
    if (file == null || file.isEmpty()) {
        throw new BusinessException("文件不能为空");
    }

    String originalFilename = file.getOriginalFilename();
    String extension = FileUtil.extName(originalFilename);

    if (!fileParserService.isSupported(extension)) {
        throw new BusinessException("不支持的文件格式: " + extension
            + ",支持的格式: pdf, docx, xlsx, pptx, txt, md");
    }

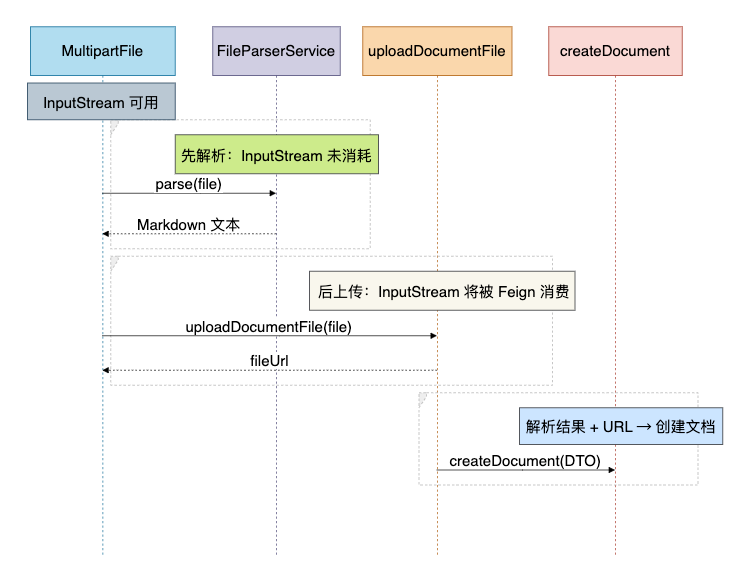
    // 2. 解析文件内容(必须先于上传:上传通过 Feign 消费 InputStream)
    String parsedContent;
    try {
        parsedContent = fileParserService.parse(file);
    } catch (Exception e) {
        throw new BusinessException("文件解析失败: " + e.getMessage());
    }

    // 3. 上传原文件到 kb-file 服务
    String fileUrl = uploadDocumentFile(file);

    if (StrUtil.isBlank(parsedContent)) {
        throw new BusinessException("文件解析结果为空");
    }

    // 4. 构建文档标题(去掉扩展名)
    String title = originalFilename != null && originalFilename.contains(".")
        ? originalFilename.substring(0, originalFilename.lastIndexOf('.'))
        : originalFilename;

    // 5. 构建 DocumentDTO 并创建文档
    DocumentDTO documentDTO = new DocumentDTO();
    documentDTO.setTitle(title);
    documentDTO.setContent(parsedContent);
    documentDTO.setDocumentType(2);           // 文件类型
    documentDTO.setFileSize(file.getSize());
    documentDTO.setFileExtension(extension);
    documentDTO.setFilePath(fileUrl);
    documentDTO.setStatus(0);                 // 初始为草稿

    Long documentId = createDocument(documentDTO);

    // 6. 构建返回结果
    int previewLen = Math.min(200, parsedContent.length());
    Map<String, Object> result = new LinkedHashMap<>();
    result.put("documentId", documentId);
    result.put("title", title);
    result.put("fileUrl", fileUrl);
    result.put("fileSize", file.getSize());
    result.put("contentLength", parsedContent.length());
    result.put("contentPreview", parsedContent.substring(0, previewLen));

    return result;
}关键注意点:文件解析必须在uploadDocumentFile()之前执行。因为uploadDocumentFile()通过 Feign 客户端以 MultipartFile 形式发送文件,Feign 的OutputStream会消费InputStream。如果在解析之前调用了上传,解析时InputStream已经被消费完毕,将导致解析失败。
十、控制器层
10.1 上传并解析端点
在 DocumentController.java 中新增端点:
/**
 * 上传文件并解析创建文档
 *
 * <p>上传文件 → 解析文本内容 → 自动创建文档记录 → 发布走管线</p>
 *
 * @param file 文件
 * @return 文档创建结果
 */
@PostMapping("/upload/parse")
@Operation(summary = "上传文件并解析创建文档",
    description = "上传文件后自动解析内容并创建文档记录,直接发布走知识管线")
@PreAuthorize("hasAnyAuthority("
    + "T(...).DOCUMENT_CREATE, "
    + "T(...).DOCUMENT_EDIT)")
public Result<Map<String, Object>> uploadAndParseDocument(
        @Parameter(description = "文件", required = true)
        @RequestParam("file") MultipartFile file) {
    log.info("上传并解析文档请求:fileName={}, size={}",
        file.getOriginalFilename(), file.getSize());

    Map<String, Object> result = documentService
        .uploadAndCreateDocument(file);
    return Result.success("文件解析并创建文档成功", result);
}
10.2 API 接口一览
| 方法 | 路径 | 说明 | 请求格式 |
|---|---|---|---|
| POST | /documents/upload | 仅上传文件,返回 URL | multipart/form-data |
| POST | /documents/upload/parse | 上传 + 解析 + 创建文档 | multipart/form-data |
| POST | /documents | 手动创建文档 | application/json |
10.3 返回数据格式
{
  "code": 200,
  "message": "文件解析并创建文档成功",
  "data": {
    "documentId": 1234567890,
    "title": "Spring Boot 升级指南",
    "fileUrl": "http://117.72.88.11:9091/knowledge-dev/abc123.pdf",
    "fileSize": 204800,
    "contentLength": 15780,
    "contentPreview": "# Spring Boot 升级指南\n\n## 概述\n\n本文档介绍了从 Spring Boot 2.x 升级到 3.x 的详细步骤..."
  }
}
十一、前端实现
11.1 API 服务层
在 document.service.ts 中新增方法:
// 上传文件并解析创建文档
uploadAndParseDocument: (file: File): Promise<{
  documentId: string;
  title: string;
  fileUrl: string;
  fileSize: number;
  contentLength: number;
  contentPreview: string;
}> => {
  const formData = new FormData();
  formData.append('file', file);
  return (http as any).postForm(
    '/document/documents/upload/parse',
    formData
  );
},
11.2 上传页面核心逻辑
ImportDocumentPage.tsx 的关键片段:
const handleFileUpload = async (files: File[]) => {
  const results: UploadResult[] = [];

  for (const file of files) {
    // 前端校验文件类型
    const ext = file.name.split('.').pop()?.toLowerCase();
    if (!allowedFileTypes.includes(ext || '')) {
      results.push({
        fileName: file.name,
        success: false,
        error: `不支持的文件类型: .${ext}`
      });
      continue;
    }

    // 前端校验文件大小
    if (file.size > maxFileSize) {
      results.push({
        fileName: file.name,
        success: false,
        error: `文件大小超过限制 (${formatFileSize(maxFileSize)})`
      });
      continue;
    }

    try {
      const result = await documentService
        .uploadAndParseDocument(file);
      results.push({
        fileName: file.name,
        success: true,
        data: result
      });
    } catch (error) {
      results.push({
        fileName: file.name,
        success: false,
        error: getErrorMessage(error)
      });
    }
  }

  setUploadResults(results);
};
十二、测试
按顺序启动下面这些微服务:
kb-file
kb-auth-user
kb-document
kb-gateway
启动前端
cd knowledge-base-frontend
npm run dev
浏览器访问文档中心页面:
http://localhost:3002/documents
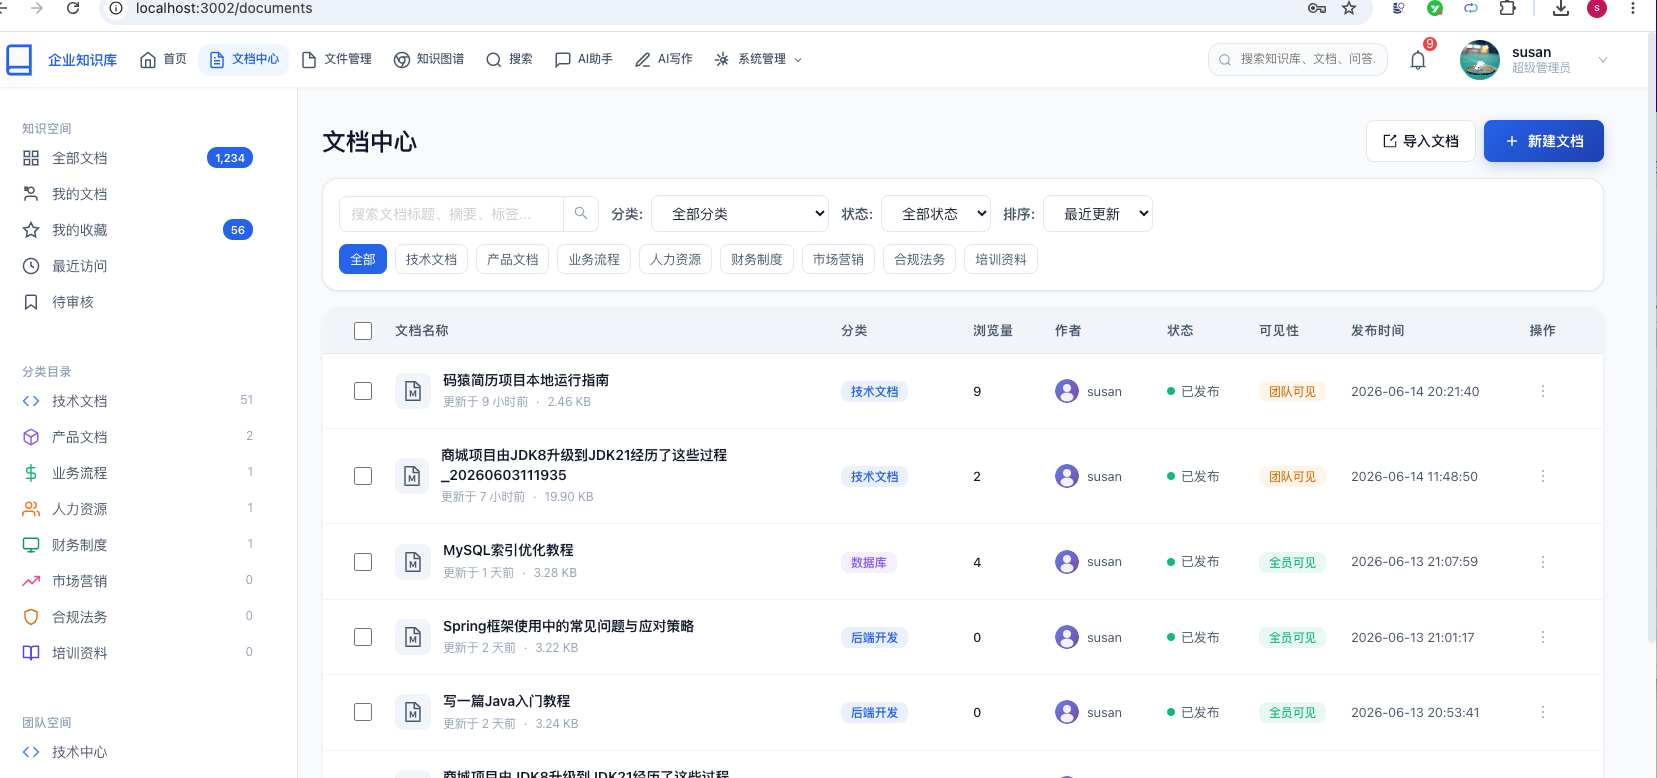
点击导入文档按钮,会出现导入文档页面:
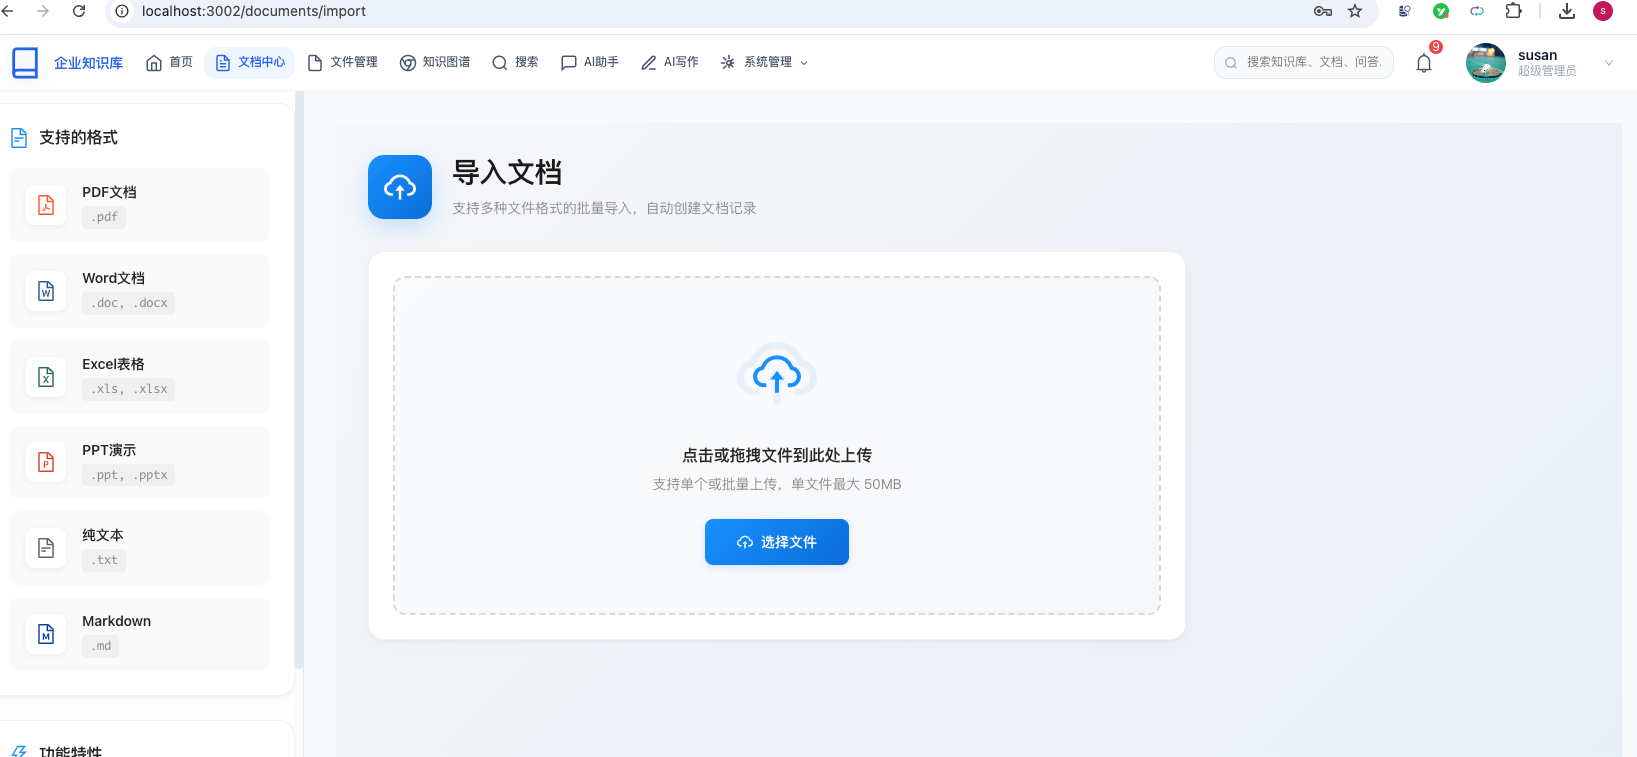
在该页面导入word文件内容如下:
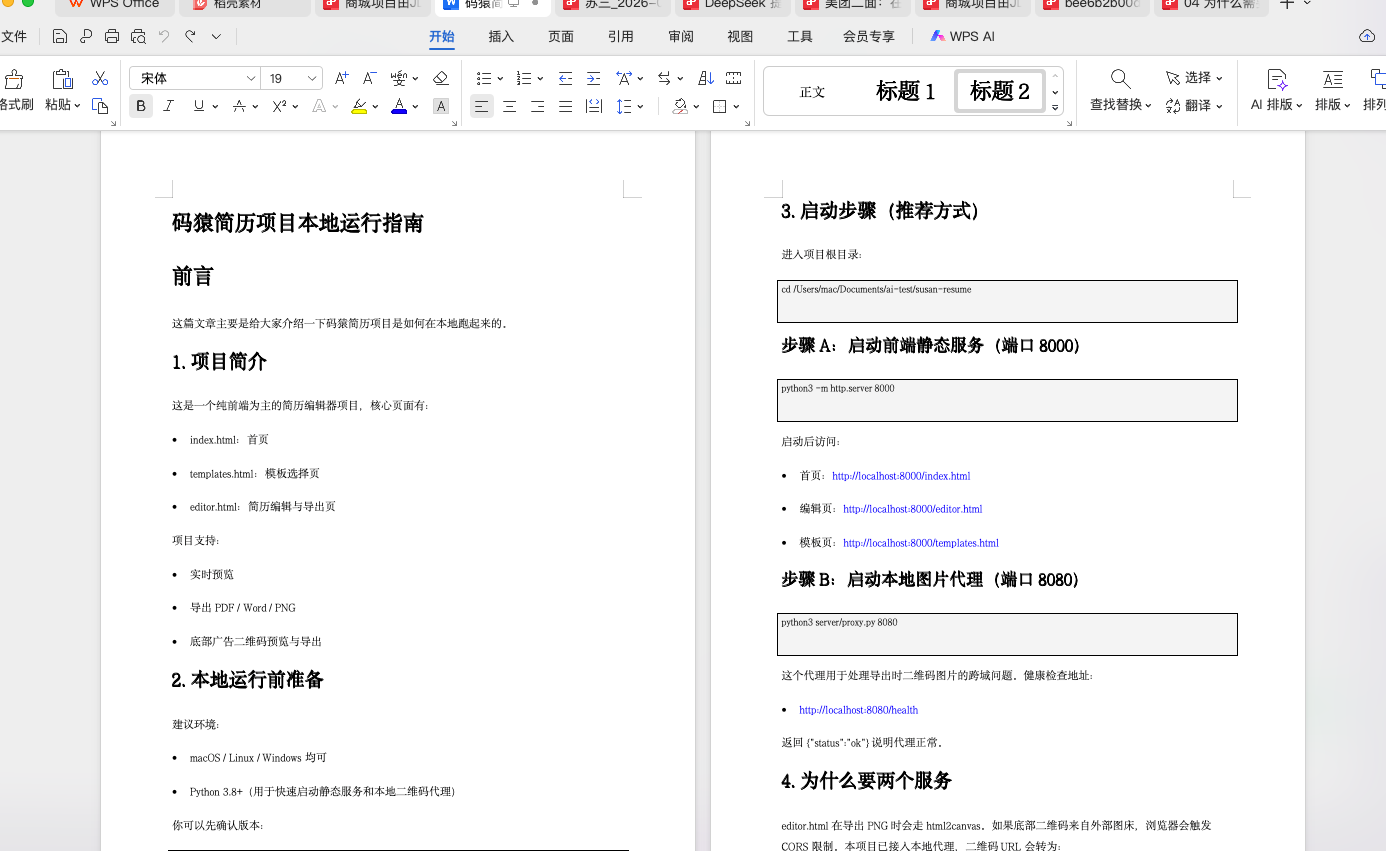
导入成功之后,文档详情如下:
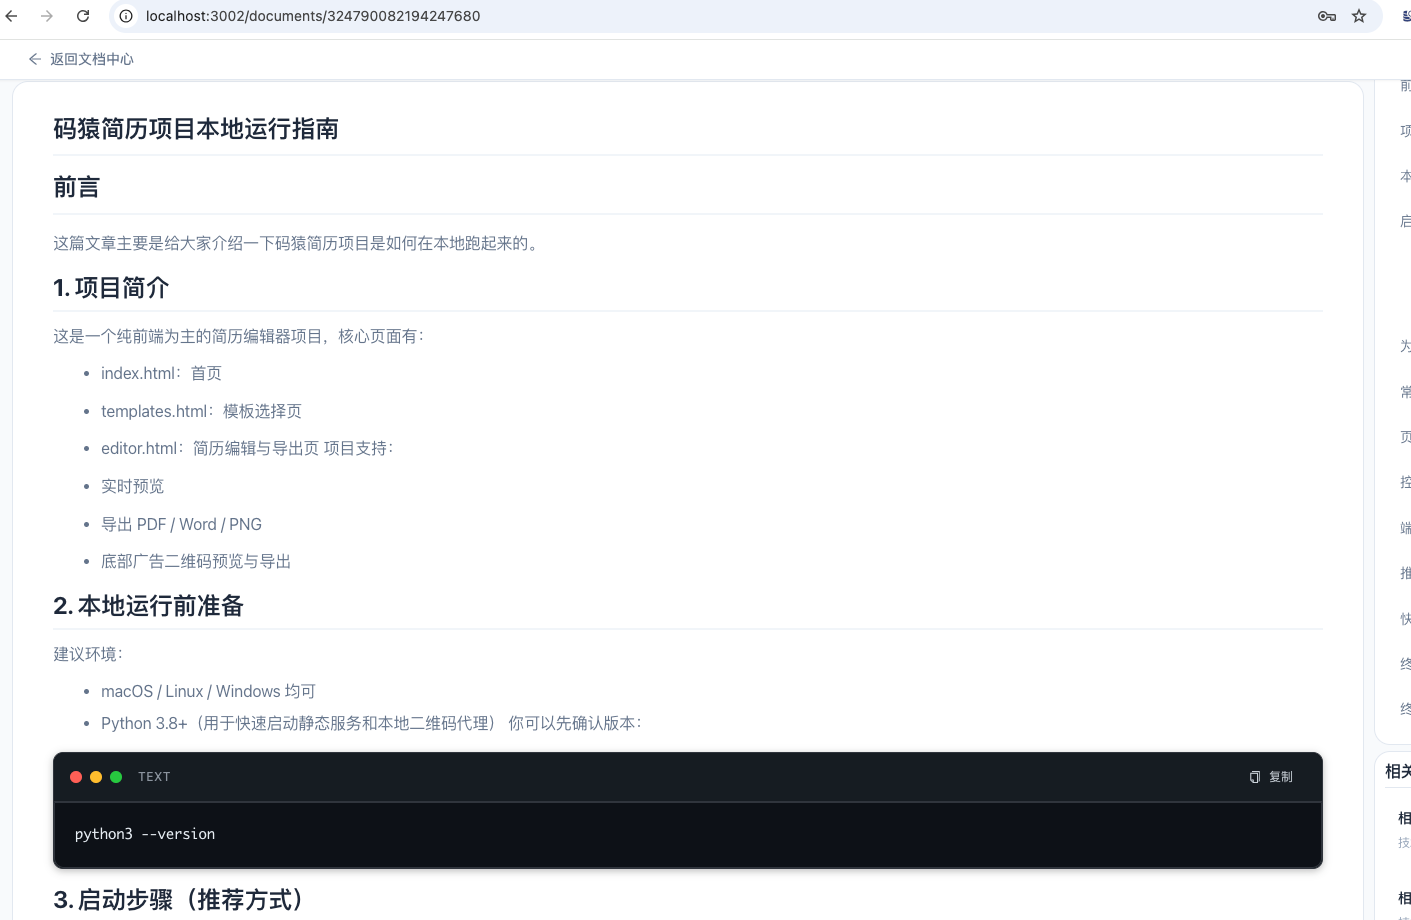
我们看到word中的内容,自动转化成好看的markdown格式的内容.
再导入PDF文件,内容如下:
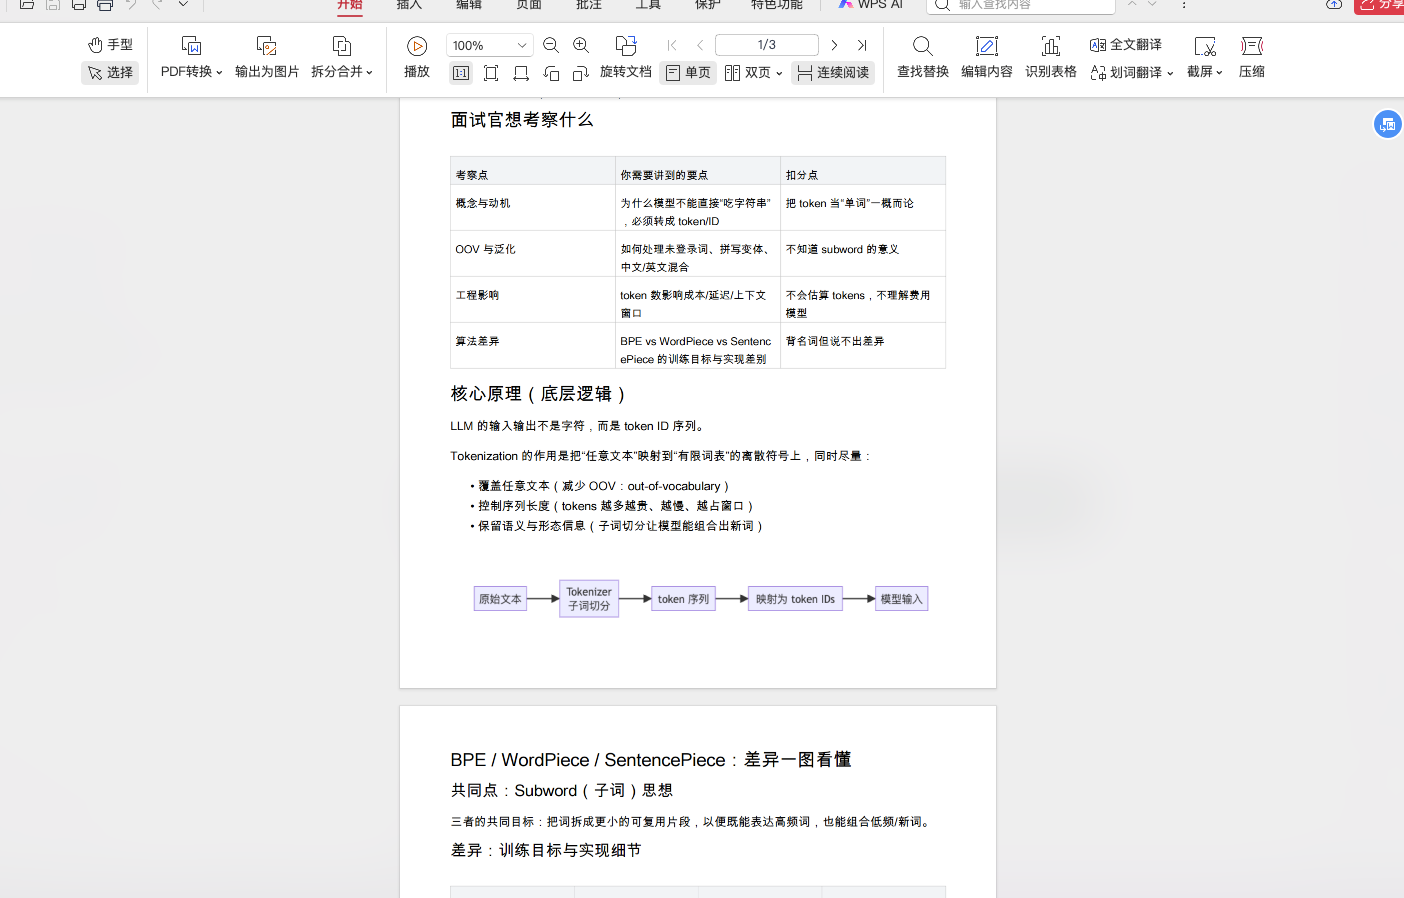
导入成功之后,文档详情如下:
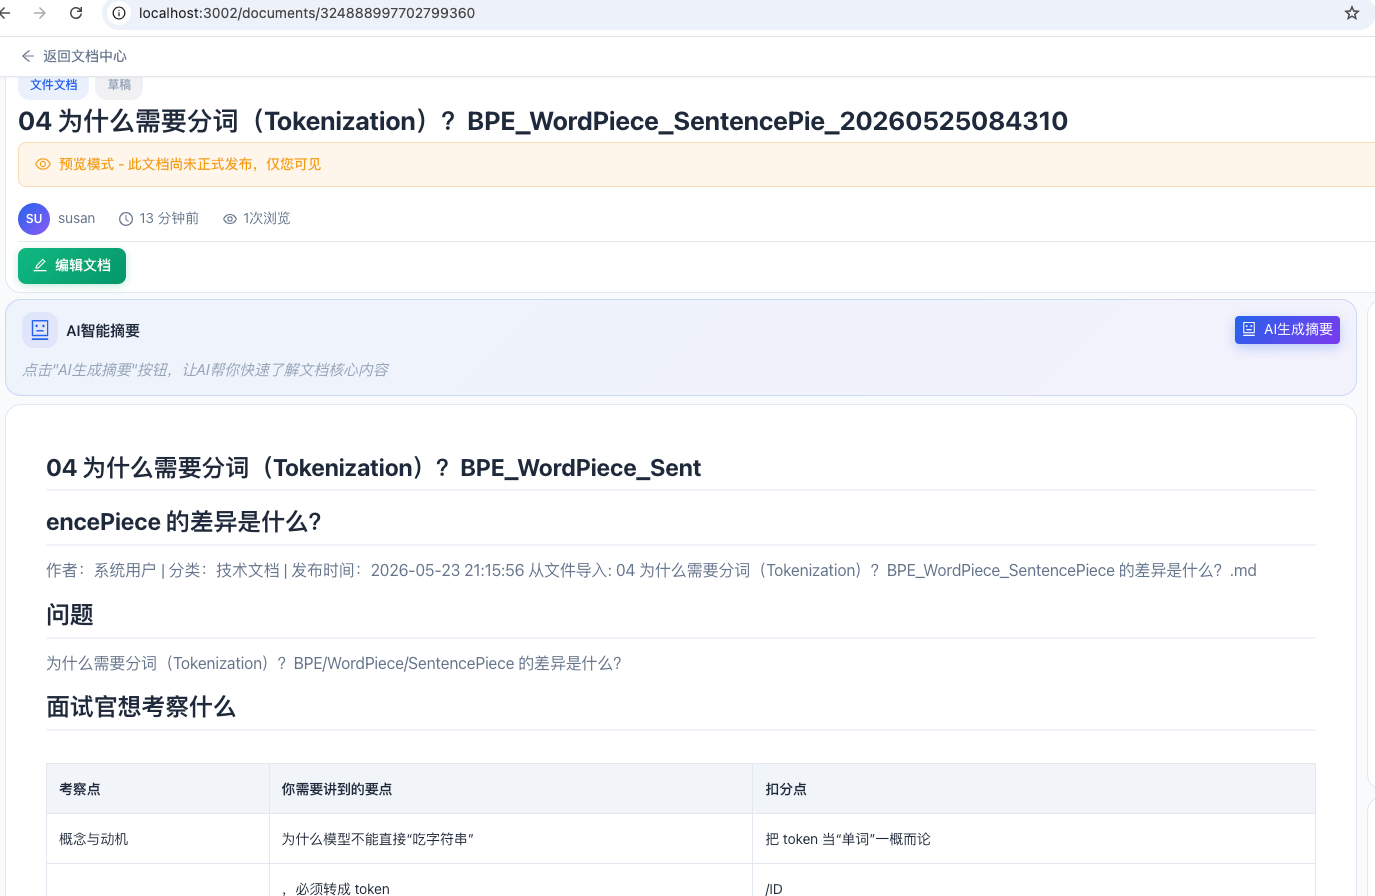
也转换成了markdown格式的文档.
总结
已完成功能总览
| 功能 | 实现方式 | 核心技术 |
|---|---|---|
| PDF 文本提取 | PDFBox CollectingPDFStripper | writeString 累积 + flushCurrentLine |
| PDF 表格识别 | X 坐标间隙分析 + 模板重分配 | detectTableColumns + applyColumnTemplate |
| PDF 图片提取 | 递归 Form XObject 搜索 | collectImageXObjects + findImagePositions |
| PDF 段落检测 | Y 间距分析 + 文本特征 | 指数移动平均 + 标点符号检测 |
| PDF 代码块 | 等宽字体 + 关键词 + 缩进分析 | looksLikeCodeLine + guessCodeLanguage |
| Word 解析 | Apache POI XWPF | 段落/表格逐元素处理 |
| Excel 解析 | Apache POI XSSF | Sheet → Markdown 表格 |
| PPT 解析 | Apache POI XSLF | 形状递归 + 占位符标题 |
| 纯文本解析 | UTF-8 字节读取 | new String(bytes, UTF-8) |
| 统一上传入口 | uploadAndCreateDocument | 解析→上传→入库→发布 一体 |
技术要点
- 行累积机制:PDFBox 逐词调用 writeString,需在 writeLineSeparator 触发时累积 flush,才能做整行的列检测和段落分析
- 三重段落检测:Y 间距(指数移动平均)+ 文本特征(中文标点/章节关键词)+ 短独立行识别
- 两层表格识别:基本 X 间隙检测(>12pt)+ 模板列重分配(处理逗号和空单元格)
- 递归图片提取:直接 XObject + Form XObject 子树遍历,覆盖大多数 PDF 生成器的图片嵌套方式
- 解析优先于上传:避免 Feign 消费 InputStream 导致解析失败
- 渐进式标题推断:基于字号比例而非绝对字号,适配不同 PDF 的排版差异
通过本文的学习,你应当能够掌握:
- 如何使用 Apache PDFBox 构建自定义 PDF 文本提取器
- 如何通过 X 坐标间隙分析实现 PDF 表格识别
- 如何使用模板列重分配修复逗号和空单元格导致的表格识别失败
- 如何通过内容流解析追踪图片位置
- 如何递归搜索 Form XObject 获取嵌套图片
- 如何使用 Apache POI 解析 Word/Excel/PPT 文档
- 如何设计统一的文件解析管道并集成到 Spring Boot 服务中
- 如何在解析后自动触发 RAG、KAG 和搜索引擎索引
祝你开发顺利!
