这篇文章介绍如何为代码审查 AI Agent 增加一套"AST 切片 + Map-Reduce"的大文件处理能力,用于突破大模型 Token 限制,实现对超大文件的智能代码审查。
读完后你将完成:
- 新增大文件配置属性,控制触发阈值和行为参数
- 实现 Token 估算服务,判断哪些文件需要切片
- 实现 AST 代码切片器(三级切片策略:方法级 → 语句级 → 行级回退)
- 实现切片数据模型
- 实现 Map-Reduce 审查服务(并行切片审查 → 去重 → 排序)
- 集成到现有审查流程中,自动触发
一、为什么需要 AST 切片 + Map-Reduce
大语言模型有上下文窗口限制。当一段代码太长(例如一个 3000 行的 Java 文件),直接送入大模型会被截断,导致:
- 后面的代码完全丢失,AI 看不到完整逻辑
- 即使勉强塞进去,模型对长上下文的注意力也会衰减
- API 报错或产生幻觉
最粗暴的做法是按字符数硬切(比如每 2000 字符切一段),但这样会破坏代码结构:
// ❌ 错误做法:这样切出来的代码 AI 根本无法理解
切片1: public class UserService { public User findById(Long id) { return
切片2:  userRepository.findById(id).orElse(null); } public void createUser(Us
AST 切片 + Map-Reduce 的策略是:
- 按方法粒度切片(AST 解析),每个切片都是语义完整的代码块
- Map 阶段:并行调用 AI 对每个切片局部审查
- Reduce 阶段:汇总所有结果,去重并按重要性排序
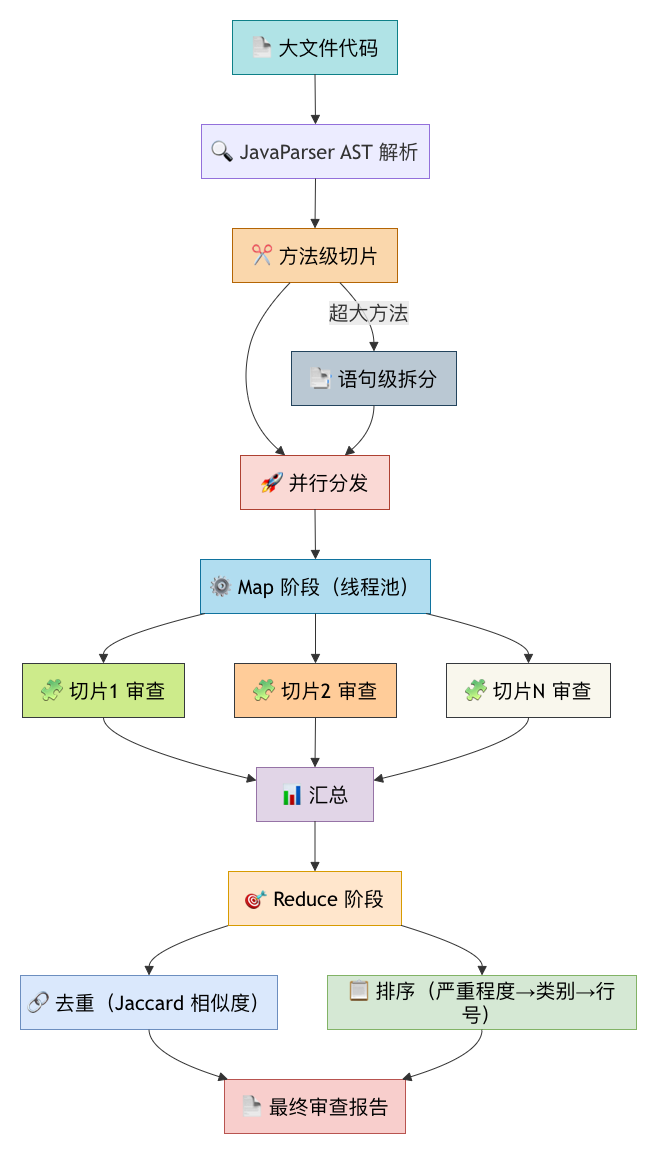
二、核心设计
2.1 三级切片策略
| 级别 | 名称 | 触发条件 | 说明 |
|---|---|---|---|
| L1 | 方法级切片 | 默认首选 | 以 Java 方法/构造器为粒度,附带包声明 + import + 类骨架作为上下文 |
| L2 | 语句级切片 | 单个方法超过 maxSliceChars(6000 字符) | 进一步将方法体按语句分组拆分 |
| L3 | 行级回退切片 | 非 Java 文件或语法解析失败 | 按固定行数(80 行)切割,保留上下文重叠区(10 行) |
2.2 方法级切片上下文
每个方法切片包含完整的上下文信息,确保 AI 能理解代码的完整背景:
package com.example;

import java.util.List;

public class UserService {
    private UserRepository userRepository;

    // === 以下是本次审查的目标代码 ===
    public User findById(Long id) {
        return userRepository.findById(id).orElse(null);
    }
}
2.3 Map-Reduce 数据处理
Map 阶段:
- 使用固定大小线程池并行审查每个切片
- 每个切片调用
AIModelService.reviewCode()独立审查 - 切片内的行号偏移量调整回原始文件行号
Reduce 阶段:
- 去重:标题 Jaccard 相似度 >= 0.7 且行号差距 <= 3 行 → 视为同一问题,保留描述更详细的一条
- 排序:严重程度 > 类别优先级(SECURITY > BUG > PERFORMANCE > MAINTAINABILITY > CODE\_STYLE)> 行号
三、后端实现(一步步)
3.1 增加配置属性 - LargeFileConfigProperties.java
创建文件: src/main/java/com/codeguardian/config/LargeFileConfigProperties.java
package com.codeguardian.config;

import lombok.Data;
import org.springframework.boot.context.properties.ConfigurationProperties;
import org.springframework.context.annotation.Configuration;

/**
 * 大文件处理配置属性
 *
 * <p>控制AST切片 + Map-Reduce审查的触发阈值和行为参数</p>
 */
@Configuration
@ConfigurationProperties(prefix = "app.large-file")
@Data
public class LargeFileConfigProperties {

    /** 单次调用允许的最大代码Token数(超过此值触发Map-Reduce) */
    private int maxTokens = 2500;

    /** 单次调用允许的最大代码字符数(直接阈值,零表示不限制,由maxTokens计算) */
    private int maxCodeChars = 0;

    /** 单个AST切片的最大字符数(超过则进行语句级拆分) */
    private int maxSliceChars = 6000;

    /** 行级回退切片的行数 */
    private int chunkLines = 80;

    /** 行级切片上下文重叠行数 */
    private int overlapLines = 10;

    /** Map阶段最大并行切片数 */
    private int mapParallelism = 5;

    /** Reduce阶段去重标题相似度阈值(0.0 ~ 1.0) */
    private double dedupTitleSimilarity = 0.7;

    /** Reduce阶段去重的最大行号差距 */
    private int dedupLineProximity = 3;

    /** 是否启用大文件自动切片(关闭时超大文件将报错而非切片) */
    private boolean enabled = true;
}关键设计说明:
maxTokens = 2500:单次审查最大 Token 数。为什么不是模型的上限(如 16384)?因为需要预留 Prompt 模板开销(~150 tokens)和输出空间(~1024 tokens),同时保留安全系数(0.85)。所以实际可用输入 Token =模型最大上下文 × 0.85 - 150 - 1024。maxCodeChars = 0:为 0 时使用maxTokens计算,按 3.5 字符 ≈ 1 token 折算。你也可以直接设置字符数阈值,更直观。maxSliceChars = 6000:单个方法超过 6000 字符会被语句级二次拆分。这是为了应对某个方法体特别大的场景(比如某个 controller 方法写了 500 行)。dedupTitleSimilarity = 0.7+dedupLineProximity = 3:去重阈值。为什么是 0.7?因为不同切片审查同一个问题,AI 给出的标题会略有差异(如"SQL注入漏洞" vs "存在SQL注入风险"),Jaccard 相似度 0.7 已经能很好地区分"相同"与"不同"。
3.2 增加 application.yml 配置项
在 src/main/resources/application.yml 中添加:
app:
  # 大文件Map-Reduce审查配置
  large-file:
    enabled: true
    max-tokens: 2500               # 单次审查最大Token数(超过触发切片)
    max-code-chars: 0              # 直接字符数阈值(0=使用max-tokens计算)
    max-slice-chars: 6000          # 单个切片最大字符数
    chunk-lines: 80                # 回退行级切片行数
    overlap-lines: 10              # 切片上下文重叠行数
    map-parallelism: 5             # Map阶段并行度
    dedup-title-similarity: 0.7    # 去重标题相似度阈值
    dedup-line-proximity: 3        # 去重行号接近阈值
3.3 创建切片数据模型 - CodeSlice.java
创建文件: src/main/java/com/codeguardian/model/CodeSlice.java
package com.codeguardian.model;

import lombok.AllArgsConstructor;
import lombok.Builder;
import lombok.Data;
import lombok.NoArgsConstructor;

/**
 * 代码切片模型
 *
 * <p>表示经过AST解析后按方法/语句粒度切分的代码片段,
 * 用于大文件的Map-Reduce并行审查</p>
 */
@Data
@Builder
@NoArgsConstructor
@AllArgsConstructor
public class CodeSlice {

    /** 切片在原始文件中的索引(从0开始) */
    private int sliceIndex;

    /** 切片名称(方法签名或类名,用于日志追踪) */
    private String sliceName;

    /** 切片代码内容(包含必要的上下文:imports + 类声明) */
    private String codeContent;

    /** 切片代码在原始文件中的起始行号(1-based) */
    private int startLine;

    /** 切片代码在原始文件中的结束行号(1-based) */
    private int endLine;

    /** 原始文件路径或标识 */
    private String originalFilePath;

    /** 切片类型:METHOD / STATEMENT / CHUNK(回退方式) */
    private String sliceType;
}
3.4 实现 Token 估算服务 - TokenEstimationService.java
创建文件: src/main/java/com/codeguardian/service/review/TokenEstimationService.java
package com.codeguardian.service.review;

import com.codeguardian.config.AIConfigProperties;
import com.codeguardian.config.LargeFileConfigProperties;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.stereotype.Service;

import java.util.HashMap;
import java.util.Map;

/**
 * Token估算服务
 *
 * <p>负责估算代码片段在送入大模型时会占用的Token数,
 * 以及判断文件是否需要触发AST切片+Map-Reduce审查</p>
 *
 * <h3>估算策略</h3>
 * <ul>
 *   <li>代码文本:约 3.5 个字符 ≈ 1 token(保守估计,代码空格/缩进较多)</li>
 *   <li>提示词模板开销:约 600 字符 ≈ 150 tokens</li>
 *   <li>输出预留:取模型 max-tokens 配置值或默认1024</li>
 *   <li>安全系数:0.85,避免边界情况导致截断</li>
 * </ul>
 */
@Service
@RequiredArgsConstructor
@Slf4j
public class TokenEstimationService {

    /** 1个Token大约对应多少个字符(代码场景约3.5,比英文文本的4更保守) */
    private static final double CHARS_PER_TOKEN = 3.5;

    /** prompt模板固定开销估算(token数) */
    private static final int PROMPT_OVERHEAD_TOKENS = 150;

    /** 安全系数:实际可用上下文 = 模型最大上下文 × SAFETY_FACTOR */
    private static final double SAFETY_FACTOR = 0.85;

    /** 默认模型最大Token数映射 */
    private static final Map<String, Integer> DEFAULT_MODEL_MAX_TOKENS = new HashMap<>();
    static {
        DEFAULT_MODEL_MAX_TOKENS.put("gpt-3.5-turbo", 4096);
        DEFAULT_MODEL_MAX_TOKENS.put("gpt-4", 8192);
        DEFAULT_MODEL_MAX_TOKENS.put("gpt-4-turbo", 128000);
        DEFAULT_MODEL_MAX_TOKENS.put("gpt-4o", 128000);
        DEFAULT_MODEL_MAX_TOKENS.put("qwen-turbo", 8192);
        DEFAULT_MODEL_MAX_TOKENS.put("qwen-plus", 32768);
        DEFAULT_MODEL_MAX_TOKENS.put("qwen-max", 32768);
        DEFAULT_MODEL_MAX_TOKENS.put("qwen3-max", 32768);
        DEFAULT_MODEL_MAX_TOKENS.put("deepseek-r1:8b", 16384);
        DEFAULT_MODEL_MAX_TOKENS.put("deepseek-r1", 32768);
        DEFAULT_MODEL_MAX_TOKENS.put("deepseek-chat", 65536);
        DEFAULT_MODEL_MAX_TOKENS.put("deepseek-coder", 16384);
    }

    /** 兜底最大Token数 */
    private static final int FALLBACK_MAX_TOKENS = 4096;

    private final AIConfigProperties aiConfigProperties;
    private final LargeFileConfigProperties largeFileConfig;

    /**
     * 估算代码内容的Token数
     */
    public int estimateTokens(String codeContent) {
        if (codeContent == null || codeContent.isEmpty()) {
            return 0;
        }
        return (int) Math.ceil(codeContent.length() / CHARS_PER_TOKEN);
    }

    /**
     * 获取指定模型的可用Token上限(用于输入代码)
     *
     * <p>可用Token = 模型最大上下文 × 安全系数 - 提示词开销 - 输出预留</p>
     */
    public int getAvailableInputTokens(String modelName) {
        int maxTokens = DEFAULT_MODEL_MAX_TOKENS.getOrDefault(
                modelName != null ? modelName.toLowerCase() : "",
                FALLBACK_MAX_TOKENS
        );

        int outputTokens = 1024;
        int available = (int) ((maxTokens) * SAFETY_FACTOR)
                - PROMPT_OVERHEAD_TOKENS - outputTokens;
        return Math.max(available, 500);
    }

    /**
     * 获取可用输入Token转字符的上限
     */
    public int getAvailableInputChars(String modelName) {
        return (int) (getAvailableInputTokens(modelName) * CHARS_PER_TOKEN);
    }

    /**
     * 判断代码是否超过Token限制,需要触发Map-Reduce审查
     */
    public boolean isLargeFile(String codeContent, String modelName) {
        if (codeContent == null || codeContent.isEmpty()) {
            return false;
        }
        if (!largeFileConfig.isEnabled()) {
            return false;
        }
        // 优先使用直接字符数阈值
        if (largeFileConfig.getMaxCodeChars() > 0) {
            boolean isLarge = codeContent.length() > largeFileConfig.getMaxCodeChars();
            if (isLarge) {
                log.info("检测到大文件: 代码长度={}, 配置阈值={}字符",
                        codeContent.length(), largeFileConfig.getMaxCodeChars());
            }
            return isLarge;
        }
        // 使用Token估算
        int estimatedTokens = estimateTokens(codeContent);
        int configThreshold = largeFileConfig.getMaxTokens();
        int availableTokens = Math.min(configThreshold, getAvailableInputTokens(modelName));
        boolean isLarge = estimatedTokens > availableTokens;
        if (isLarge) {
            log.info("检测到大文件: 估算Token={}, 可用Token={}, 代码长度={}字符, 模型={}",
                    estimatedTokens, availableTokens, codeContent.length(), modelName);
        }
        return isLarge;
    }

    /**
     * 判断单个代码块是否本身也过大,需要进一步切分
     */
    public boolean isSingleSliceTooLarge(String sliceContent) {
        return sliceContent != null && sliceContent.length() > largeFileConfig.getMaxSliceChars();
    }
}
为什么用 3.5 而不是 4?
英文文本大约是 4 个字符 = 1 token。但代码中有大量空格、缩进、括号等符号,这些更接近"字符密集"类型。实测经验表明 3.5 字符/token 更贴近实际编码场景(尤其在 Java 这种"又长又啰嗦"的语言中)。
3000 行 Java 文件大约多少 token?
假设每行平均 40 个字符(含缩进),3000 × 40 = 120,000 字符 ÷ 3.5 ≈ 34,285 tokens。对于 qwen3-max(32768 上下文),已经接近上限。对于 DeepSeek-R1 8B 本地模型(16384),远远超过。所以这个文件必定触发切片。
3.5 实现 AST 代码切片器 - ASTCodeSlicer.java
这是整个功能的核心。创建文件: src/main/java/com/codeguardian/service/review/ASTCodeSlicer.java
package com.codeguardian.service.review;

import com.codeguardian.model.CodeSlice;
import com.codeguardian.config.LargeFileConfigProperties;
import com.github.javaparser.JavaParser;
import com.github.javaparser.ParseResult;
import com.github.javaparser.ParserConfiguration;
import com.github.javaparser.ast.CompilationUnit;
import com.github.javaparser.ast.Node;
import com.github.javaparser.ast.body.*;
import com.github.javaparser.ast.expr.AnnotationExpr;
import com.github.javaparser.ast.nodeTypes.NodeWithRange;
import com.github.javaparser.ast.stmt.Statement;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.stereotype.Service;

import java.util.*;
import java.util.stream.Collectors;

/**
 * AST代码切片器
 *
 * <p>核心功能:利用JavaParser以"方法"为粒度对代码进行AST切片,
 * 避免简单的按字符截断,保证每个切片都是语义完整的代码块。</p>
 *
 * <h3>切片策略(三级)</h3>
 * <ol>
 *   <li><b>方法级切片(首选)</b>:解析CompilationUnit,提取每个方法作为独立切片</li>
 *   <li><b>语句级切片(超大方法回退)</b>:对超过阈值的方法进一步按语句拆分</li>
 *   <li><b>行级切片(非Java语言回退)</b>:按固定行数切割,保留上下文重叠区</li>
 * </ol>
 */
@Service
@RequiredArgsConstructor
@Slf4j
public class ASTCodeSlicer {

    private static final String JAVA_EXT = ".java";
    private static final String SLICE_TYPE_METHOD = "METHOD";
    private static final String SLICE_TYPE_STATEMENT = "STATEMENT";
    private static final String SLICE_TYPE_CHUNK = "CHUNK";

    private final TokenEstimationService tokenEstimationService;
    private final LargeFileConfigProperties largeFileConfig;

    /**
     * 对代码文件进行AST切片
     */
    public List<CodeSlice> slice(String codeContent, String filePath) {
        return slice(codeContent, filePath, null);
    }

    public List<CodeSlice> slice(String codeContent, String filePath, String language) {
        if (codeContent == null || codeContent.trim().isEmpty()) {
            return Collections.emptyList();
        }

        if (isJavaFile(filePath, language)) {
            return sliceJava(codeContent, filePath);
        }
        return fallbackLineChunking(codeContent, filePath);
    }

    private boolean isJavaFile(String filePath, String language) {
        if (filePath != null && filePath.toLowerCase().endsWith(JAVA_EXT)) {
            return true;
        }
        if (language != null) {
            return language.equalsIgnoreCase("java");
        }
        return false;
    }

    // ==================== Java AST 切片 ====================

    private List<CodeSlice> sliceJava(String codeContent, String filePath) {
        List<CodeSlice> slices = new ArrayList<>();
        try {
            ParserConfiguration config = new ParserConfiguration();
            config.setLanguageLevel(ParserConfiguration.LanguageLevel.JAVA_17);
            JavaParser parser = new JavaParser(config);

            ParseResult<CompilationUnit> result = parser.parse(codeContent);
            if (!result.isSuccessful() || result.getResult().isEmpty()) {
                log.warn("Java代码解析失败,回退到行级切片: {}", filePath);
                return fallbackLineChunking(codeContent, filePath);
            }

            CompilationUnit cu = result.getResult().get();
            String packageAndImports = extractPackageAndImports(cu, codeContent);

            List<TypeDeclaration<?>> types = findAllTypeDeclarations(cu);
            for (TypeDeclaration<?> type : types) {
                String classContext = buildClassContext(type);
                List<BodyDeclaration<?>> members = type.getMembers();
                if (members == null || members.isEmpty()) continue;

                for (BodyDeclaration<?> member : members) {
                    if (member instanceof MethodDeclaration method) {
                        slices.addAll(sliceMethod(packageAndImports, classContext,
                                method, codeContent, filePath, slices.size()));
                    } else if (member instanceof ConstructorDeclaration ctor) {
                        slices.addAll(sliceConstructor(packageAndImports, classContext,
                                ctor, codeContent, filePath, slices.size()));
                    }
                }
            }

            if (slices.isEmpty()) {
                return fallbackLineChunking(codeContent, filePath);
            }

            log.info("Java AST切片完成: 文件={}, 切片数={}", filePath, slices.size());
        } catch (Exception e) {
            log.error("AST切片异常,回退到行级切片: {}", filePath, e);
            return fallbackLineChunking(codeContent, filePath);
        }
        return slices;
    }

    /**
     * 对单个方法进行切片
     */
    private List<CodeSlice> sliceMethod(String packageAndImports, String classContext,
                                         MethodDeclaration method, String originalCode,
                                         String filePath, int baseIndex) {
        List<CodeSlice> slices = new ArrayList<>();
        String methodBody = extractNodeSource(method, originalCode);
        int startLine = method.getBegin().map(p -> p.line).orElse(1);
        int endLine = method.getEnd().map(p -> p.line).orElse(startLine);
        String methodSignature = method.getDeclarationAsString(false, false, true);

        if (tokenEstimationService.isSingleSliceTooLarge(methodBody)) {
            // 超大方法 → 语句级拆分
            slices.addAll(sliceLargeMethod(packageAndImports, classContext, method,
                    methodBody, originalCode, filePath, baseIndex));
        } else {
            // 正常大小的方法 → 直接作为一个切片
            String sliceCode = buildSliceCode(packageAndImports, classContext, methodBody);
            slices.add(CodeSlice.builder()
                    .sliceIndex(baseIndex)
                    .sliceName(methodSignature)
                    .codeContent(sliceCode)
                    .startLine(startLine)
                    .endLine(endLine)
                    .originalFilePath(filePath)
                    .sliceType(SLICE_TYPE_METHOD)
                    .build());
        }
        return slices;
    }

    /**
     * 对构造器进行切片
     */
    private List<CodeSlice> sliceConstructor(String packageAndImports, String classContext,
                                              ConstructorDeclaration ctor, String originalCode,
                                              String filePath, int baseIndex) {
        List<CodeSlice> slices = new ArrayList<>();
        String ctorBody = extractNodeSource(ctor, originalCode);
        int startLine = ctor.getBegin().map(p -> p.line).orElse(1);
        int endLine = ctor.getEnd().map(p -> p.line).orElse(startLine);
        String signature = ctor.getDeclarationAsString(false, false, true);

        String sliceCode = buildSliceCode(packageAndImports, classContext, ctorBody);
        slices.add(CodeSlice.builder()
                .sliceIndex(baseIndex)
                .sliceName(signature)
                .codeContent(sliceCode)
                .startLine(startLine)
                .endLine(endLine)
                .originalFilePath(filePath)
                .sliceType(SLICE_TYPE_METHOD)
                .build());
        return slices;
    }

    // ==================== 语句级二次拆分 ====================

    private List<CodeSlice> sliceLargeMethod(String packageAndImports, String classContext,
                                              MethodDeclaration method, String methodBody,
                                              String originalCode, String filePath, int baseIndex) {
        List<CodeSlice> slices = new ArrayList<>();
        int methodStartLine = method.getBegin().map(p -> p.line).orElse(1);

        method.getBody().ifPresent(body -> {
            List<Statement> statements = body.getStatements();
            if (statements.isEmpty()) return;

            List<List<Statement>> groups = groupStatements(statements);

            for (int i = 0; i < groups.size(); i++) {
                List<Statement> group = groups.get(i);
                int groupStartLine = group.get(0).getBegin()
                        .map(p -> p.line).orElse(methodStartLine + 1);
                int groupEndLine = group.get(group.size() - 1).getEnd()
                        .map(p -> p.line).orElse(groupStartLine);

                StringBuilder stmtCode = new StringBuilder();
                stmtCode.append(method.getDeclarationAsString(false, false, true))
                        .append(" {\n");
                for (Statement stmt : group) {
                    stmtCode.append(extractNodeSource(stmt, originalCode)).append("\n");
                }
                stmtCode.append("}\n");

                String sliceCode = buildSliceCode(packageAndImports, classContext, stmtCode.toString());
                slices.add(CodeSlice.builder()
                        .sliceIndex(baseIndex + i)
                        .sliceName(method.getNameAsString() + " (语句组" + (i + 1) + ")")
                        .codeContent(sliceCode)
                        .startLine(groupStartLine)
                        .endLine(groupEndLine)
                        .originalFilePath(filePath)
                        .sliceType(SLICE_TYPE_STATEMENT)
                        .build());
            }
        });
        return slices;
    }

    /**
     * 将语句按大小分组
     */
    private List<List<Statement>> groupStatements(List<Statement> statements) {
        List<List<Statement>> groups = new ArrayList<>();
        List<Statement> currentGroup = new ArrayList<>();
        int currentSize = 0;

        for (Statement stmt : statements) {
            int stmtSize = estimateStatementSize(stmt);
            if (currentSize + stmtSize > largeFileConfig.getMaxSliceChars() / 2
                    && !currentGroup.isEmpty()) {
                groups.add(currentGroup);
                currentGroup = new ArrayList<>();
                currentSize = 0;
            }
            currentGroup.add(stmt);
            currentSize += stmtSize;
        }
        if (!currentGroup.isEmpty()) {
            groups.add(currentGroup);
        }
        return groups;
    }

    private int estimateStatementSize(Statement stmt) {
        return stmt.getEnd().map(p -> p.column).orElse(0)
                - stmt.getBegin().map(p -> p.column).orElse(0) + 1;
    }

    // ==================== 行级回退切片 ====================

    /**
     * 对非Java代码或语法解析失败时的行级回退切片
     */
    private List<CodeSlice> fallbackLineChunking(String codeContent, String filePath) {
        List<CodeSlice> slices = new ArrayList<>();
        String[] lines = codeContent.split("\r?\n", -1);

        if (lines.length <= largeFileConfig.getChunkLines()) {
            slices.add(CodeSlice.builder()
                    .sliceIndex(0)
                    .sliceName("完整文件")
                    .codeContent(codeContent)
                    .startLine(1)
                    .endLine(lines.length)
                    .originalFilePath(filePath)
                    .sliceType(SLICE_TYPE_CHUNK)
                    .build());
            return slices;
        }

        int chunkIndex = 0;
        int currentLine = 0;
        while (currentLine < lines.length) {
            int chunkStart = currentLine;
            int chunkEnd = Math.min(currentLine + largeFileConfig.getChunkLines(), lines.length);
            int actualStartLine = chunkStart + 1;
            int actualEndLine = chunkEnd;

            StringBuilder chunkBuilder = new StringBuilder();
            // 添加上文重叠区(帮助AI理解上下文)
            if (chunkStart > 0) {
                chunkBuilder.append("// === 上文(来自行")
                        .append(Math.max(1, chunkStart - largeFileConfig.getOverlapLines() + 1))
                        .append("-").append(chunkStart)
                        .append(") ===\n");
                for (int i = Math.max(0, chunkStart - largeFileConfig.getOverlapLines());
                        i < chunkStart; i++) {
                    chunkBuilder.append(lines[i]).append("\n");
                }
            }

            for (int i = chunkStart; i < chunkEnd; i++) {
                chunkBuilder.append(lines[i]).append("\n");
            }

            slices.add(CodeSlice.builder()
                    .sliceIndex(chunkIndex)
                    .sliceName("切片" + (chunkIndex + 1)
                            + " (行" + actualStartLine + "-" + actualEndLine + ")")
                    .codeContent(chunkBuilder.toString())
                    .startLine(actualStartLine)
                    .endLine(actualEndLine)
                    .originalFilePath(filePath)
                    .sliceType(SLICE_TYPE_CHUNK)
                    .build());

            chunkIndex++;
            currentLine += largeFileConfig.getChunkLines();
        }

        log.info("行级回退切片完成: 文件={}, 行数={}, 切片数={}",
                filePath, lines.length, slices.size());
        return slices;
    }

    // ==================== 辅助方法 ====================

    /**
     * 提取包声明和import语句(所有切片的公共上下文)
     */
    private String extractPackageAndImports(CompilationUnit cu, String originalCode) {
        StringBuilder sb = new StringBuilder();
        cu.getPackageDeclaration().ifPresent(pkg -> {
            sb.append(extractNodeSource(pkg, originalCode));
            if (!sb.toString().endsWith("\n")) sb.append("\n");
        });
        if (!cu.getImports().isEmpty()) {
            if (sb.length() > 0) sb.append("\n");
            for (var imp : cu.getImports()) {
                sb.append(extractNodeSource(imp, originalCode));
                if (!sb.toString().endsWith("\n")) sb.append("\n");
            }
        }
        return sb.toString();
    }

    /**
     * 构建类的上下文骨架(类声明 + 注解 + 字段)
     */
    private String buildClassContext(TypeDeclaration<?> type) {
        StringBuilder sb = new StringBuilder();
        for (AnnotationExpr ann : type.getAnnotations()) {
            sb.append(ann.toString()).append("\n");
        }

        String modifiers = type.getModifiers().stream()
                .map(mod -> mod.getKeyword().asString())
                .collect(Collectors.joining(" "));
        if (!modifiers.isEmpty()) sb.append(modifiers).append(" ");

        if (type instanceof ClassOrInterfaceDeclaration ci) {
            if (ci.isInterface()) sb.append("interface ");
            else sb.append("class ");
            sb.append(ci.getNameAsString());
            ci.getTypeParameters().ifNonEmpty(params ->
                    sb.append("<").append(params.stream()
                            .map(Object::toString)
                            .collect(Collectors.joining(", "))).append(">"));
        } else if (type instanceof EnumDeclaration) {
            sb.append("enum ").append(type.getNameAsString());
        } else {
            sb.append(type.getNameAsString());
        }

        sb.append(" {\n");

        // 字段声明作为上下文保留
        for (FieldDeclaration field : type.getFields()) {
            sb.append("    ").append(field.toString()).append("\n");
        }
        sb.append("\n");
        return sb.toString();
    }

    /**
     * 组合完整的切片代码:包导入 + 类上下文 + 方法体
     */
    private String buildSliceCode(String packageAndImports, String classContext,
                                   String memberBody) {
        StringBuilder sb = new StringBuilder();
        sb.append(packageAndImports);
        if (sb.length() > 0 && !sb.toString().endsWith("\n\n")) {
            sb.append("\n");
        }
        sb.append(classContext);
        sb.append("    // === 以下是本次审查的目标代码 ===\n");
        sb.append("    ").append(memberBody);
        sb.append("}\n");
        return sb.toString();
    }

    /**
     * 安全查找所有TypeDeclaration(避免泛型类型推断问题)
     */
    @SuppressWarnings("unchecked")
    private List<TypeDeclaration<?>> findAllTypeDeclarations(CompilationUnit cu) {
        return cu.findAll(Node.class).stream()
                .filter(node -> node instanceof TypeDeclaration)
                .map(node -> (TypeDeclaration<?>) node)
                .collect(Collectors.toList());
    }

    /**
     * 从原始代码中根据AST节点位置精确提取源码文本
     */
    private String extractNodeSource(Node node, String originalCode) {
        if (node instanceof NodeWithRange) {
            return node.getRange()
                    .map(range -> {
                        String[] lines = originalCode.split("\r?\n", -1);
                        int startLine = range.begin.line - 1;
                        int endLine = range.end.line - 1;
                        int startCol = range.begin.column - 1;
                        int endCol = range.end.column - 1;

                        StringBuilder sb = new StringBuilder();
                        for (int i = startLine; i <= endLine && i < lines.length; i++) {
                            String line = lines[i];
                            if (i == startLine && i == endLine) {
                                sb.append(line, startCol, Math.min(endCol, line.length()));
                            } else if (i == startLine) {
                                sb.append(line.substring(startCol));
                            } else if (i == endLine) {
                                sb.append(line, 0, Math.min(endCol, line.length()));
                            } else {
                                sb.append(line);
                            }
                            if (i < endLine) sb.append("\n");
                        }
                        return sb.toString();
                    })
                    .orElse(node.toString());
        }
        return node.toString();
    }
}extractNodeSource** 为什么不用 **node.toString()**?**
JavaParser 的 toString() 会用自己的格式器重新格式化代码,导致缩进、换行等与原始代码不一致。而 extractNodeSource 直接从原始代码字符串中根据 AST 节点的行号/列号范围截取文本,保留了原始的代码格式和风格。这对于后续的行号映射至关重要。
3.6 实现 Map-Reduce 审查服务 - MapReduceReviewService.java
创建文件: src/main/java/com/codeguardian/service/review/MapReduceReviewService.java
package com.codeguardian.service.review;

import com.codeguardian.entity.Finding;
import com.codeguardian.enums.SeverityEnum;
import com.codeguardian.config.LargeFileConfigProperties;
import com.codeguardian.model.CodeSlice;
import com.codeguardian.service.AIModelService;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.stereotype.Service;

import java.util.*;
import java.util.concurrent.*;

/**
 * Map-Reduce大文件审查服务
 *
 * <p>采用AST切片 + Map-Reduce策略处理超过Token限制的大文件代码审查。</p>
 *
 * <h3>处理流程</h3>
 * <ol>
 *   <li><b>检测+切片</b>:TokenEstimationService检测大文件,ASTCodeSlicer按方法粒度切片</li>
 *   <li><b>Map阶段</b>:并行调用AI对每个切片进行局部审查</li>
 *   <li><b>Reduce阶段</b>:汇总结果,去重,按重要性排序,生成最终报告</li>
 * </ol>
 */
@Service
@RequiredArgsConstructor
@Slf4j
public class MapReduceReviewService {

    private final AIModelService aiModelService;
    private final ASTCodeSlicer astCodeSlicer;
    private final LargeFileConfigProperties largeFileConfig;

    /** 类别排序权重(值越小越优先) */
    private static final Map<String, Integer> CATEGORY_PRIORITY = new LinkedHashMap<>();
    static {
        CATEGORY_PRIORITY.put("SECURITY", 0);
        CATEGORY_PRIORITY.put("BUG", 1);
        CATEGORY_PRIORITY.put("PERFORMANCE", 2);
        CATEGORY_PRIORITY.put("MAINTAINABILITY", 3);
        CATEGORY_PRIORITY.put("CODE_STYLE", 4);
    }

    /** 切片审查专用线程池 */
    private ExecutorService sliceReviewExecutor;

    @jakarta.annotation.PostConstruct
    public void init() {
        int parallelism = Math.max(1, Math.min(largeFileConfig.getMapParallelism(),
                Runtime.getRuntime().availableProcessors() * 2));
        this.sliceReviewExecutor = Executors.newFixedThreadPool(parallelism, r -> {
            Thread t = new Thread(r, "slice-review-");
            t.setDaemon(true);
            return t;
        });
        log.info("切片审查线程池初始化: 并行度={}", parallelism);
    }

    @jakarta.annotation.PreDestroy
    public void destroy() {
        log.info("关闭切片审查线程池...");
        sliceReviewExecutor.shutdown();
    }

    /**
     * 执行Map-Reduce审查(核心入口)
     */
    public List<Finding> reviewLargeFile(String codeContent, String language,
                                          String modelProvider, boolean enableRag,
                                          String filePath, List<Finding> existingFindings) {
        log.info("========== Map-Reduce大文件审查开始 ==========");
        log.info("文件: {}, 语言: {}, 代码长度: {} 字符",
                filePath, language, codeContent.length());

        long startTime = System.currentTimeMillis();

        // Step 1: AST切片
        List<CodeSlice> slices = astCodeSlicer.slice(codeContent, filePath);
        log.info("[切片完成] 共 {} 个切片", slices.size());

        if (slices.isEmpty()) {
            log.warn("切片结果为空,回退到原始审查");
            return aiModelService.reviewCode(codeContent, language,
                    modelProvider, enableRag, existingFindings);
        }

        // Step 2: Map阶段 - 并行审查每个切片
        List<Finding> allFindings = mapPhase(slices, language,
                modelProvider, enableRag, existingFindings);
        log.info("[Map阶段完成] 共发现 {} 个原始问题", allFindings.size());

        // Step 3: Reduce阶段 - 去重 + 排序
        List<Finding> finalFindings = reducePhase(allFindings);

        long totalTime = System.currentTimeMillis() - startTime;
        log.info("========== Map-Reduce审查完成: 总耗时{}ms, 原始{}→最终{} ==========",
                totalTime, allFindings.size(), finalFindings.size());

        return finalFindings;
    }

    // ==================== Map 阶段 ====================

    private List<Finding> mapPhase(List<CodeSlice> slices, String language,
                                    String modelProvider, boolean enableRag,
                                    List<Finding> existingFindings) {
        List<CompletableFuture<List<Finding>>> futures = new ArrayList<>();

        for (CodeSlice slice : slices) {
            CompletableFuture<List<Finding>> future = CompletableFuture.supplyAsync(() -> {
                try {
                    log.info("[Map] 审查切片 [{}/{}]: {} (行{}-{})",
                            slice.getSliceIndex() + 1, slices.size(),
                            slice.getSliceName(),
                            slice.getStartLine(), slice.getEndLine());
                    return reviewSlice(slice, language, modelProvider, enableRag);
                } catch (Exception e) {
                    log.error("[Map] 切片审查失败: {} (行{}-{})",
                            slice.getSliceName(),
                            slice.getStartLine(), slice.getEndLine(), e);
                    return new ArrayList<Finding>();
                }
            }, sliceReviewExecutor);
            futures.add(future);
        }

        // 等待所有切片审查完成(120秒超时)
        List<Finding> allFindings = new ArrayList<>();
        for (int i = 0; i < futures.size(); i++) {
            try {
                List<Finding> sliceFindings = futures.get(i).get(120, TimeUnit.SECONDS);
                if (sliceFindings != null) {
                    // 关键步骤:将切片内的行号偏移量调整回原始文件行号
                    int lineOffset = slices.get(i).getStartLine() - 1;
                    for (Finding f : sliceFindings) {
                        adjustLineNumbers(f, lineOffset);
                    }
                    allFindings.addAll(sliceFindings);
                }
            } catch (TimeoutException e) {
                log.error("[Map] 切片[{}] 审查超时", i);
            } catch (Exception e) {
                log.error("[Map] 获取切片[{}] 审查结果失败", i, e);
            }
        }
        return allFindings;
    }

    private List<Finding> reviewSlice(CodeSlice slice, String language,
                                       String modelProvider, boolean enableRag) {
        long start = System.currentTimeMillis();
        List<Finding> findings = aiModelService.reviewCode(
                slice.getCodeContent(), language, modelProvider, enableRag, null
        );
        for (Finding f : findings) {
            f.setSource("AI-MapReduce");
            if (f.getLocation() == null || f.getLocation().isBlank()) {
                f.setLocation(slice.getOriginalFilePath() + ":" + slice.getStartLine());
            }
        }
        log.debug("[Map] 切片 {} 审查完成, 耗时{}ms, 发现{}个问题",
                slice.getSliceName(),
                System.currentTimeMillis() - start, findings.size());
        return findings;
    }

    /**
     * 调整Finding行号:从切片内行号(以1开始) → 原始文件行号
     */
    private void adjustLineNumbers(Finding finding, int lineOffset) {
        if (finding.getStartLine() != null) {
            finding.setStartLine(finding.getStartLine() + lineOffset);
        }
        if (finding.getEndLine() != null) {
            finding.setEndLine(finding.getEndLine() + lineOffset);
        }
    }

    // ==================== Reduce 阶段 ====================

    private List<Finding> reducePhase(List<Finding> rawFindings) {
        if (rawFindings == null || rawFindings.isEmpty()) {
            return new ArrayList<>();
        }

        // Step 1: 去重
        List<Finding> deduped = deduplicateFindings(rawFindings);
        log.info("[Reduce-去重] {} → {}(去重后)", rawFindings.size(), deduped.size());

        // Step 2: 排序
        deduped.sort(this::compareFindings);
        log.info("[Reduce-排序] 按严重程度和类别优先级完成排序");

        return deduped;
    }

    /**
     * 去重:标题Jaccard相似度 > 0.7 且 位置接近(≤ 3行)→ 视为同一问题
     */
    List<Finding> deduplicateFindings(List<Finding> findings) {
        if (findings.size() <= 1) {
            return new ArrayList<>(findings);
        }

        List<Finding> result = new ArrayList<>();
        boolean[] merged = new boolean[findings.size()];

        for (int i = 0; i < findings.size(); i++) {
            if (merged[i]) continue;
            Finding current = findings.get(i);
            Finding best = current;

            for (int j = i + 1; j < findings.size(); j++) {
                if (merged[j]) continue;
                Finding other = findings.get(j);
                double titleSim = computeTitleSimilarity(
                        current.getTitle(), other.getTitle());
                boolean linesClose = areLinesClose(current, other);

                if (titleSim >= largeFileConfig.getDedupTitleSimilarity()
                        && linesClose) {
                    merged[j] = true;
                    best = mergeTwoFindings(best, other);
                }
            }
            result.add(best);
            merged[i] = true;
        }
        return result;
    }

    /**
     * 计算Jaccard相似度(bigram分词,适合中英文混合)
     */
    private double computeTitleSimilarity(String title1, String title2) {
        if (title1 == null || title2 == null) return 0.0;
        if (title1.equals(title2)) return 1.0;

        Set<String> words1 = tokenize(title1);
        Set<String> words2 = tokenize(title2);

        if (words1.isEmpty() && words2.isEmpty()) return 1.0;
        if (words1.isEmpty() || words2.isEmpty()) return 0.0;

        Set<String> union = new HashSet<>(words1);
        union.addAll(words2);

        Set<String> intersection = new HashSet<>(words1);
        intersection.retainAll(words2);

        return (double) intersection.size() / union.size();
    }

    private Set<String> tokenize(String text) {
        Set<String> tokens = new HashSet<>();
        text = text.toLowerCase().trim();
        // bigram
        for (int i = 0; i < text.length() - 1; i++) {
            tokens.add(text.substring(i, i + 2));
        }
        // unigram
        for (char c : text.toCharArray()) {
            if (Character.isLetterOrDigit(c)) {
                tokens.add(String.valueOf(c));
            }
        }
        return tokens;
    }

    private boolean areLinesClose(Finding f1, Finding f2) {
        Integer s1 = f1.getStartLine();
        Integer s2 = f2.getStartLine();
        if (s1 == null || s2 == null) return false;
        return Math.abs(s1 - s2) <= largeFileConfig.getDedupLineProximity();
    }

    /**
     * 合并两个相似Finding,保留描述更详细的一条
     */
    private Finding mergeTwoFindings(Finding f1, Finding f2) {
        int len1 = (f1.getDescription() != null ? f1.getDescription().length() : 0)
                + (f1.getSuggestion() != null ? f1.getSuggestion().length() : 0);
        int len2 = (f2.getDescription() != null ? f2.getDescription().length() : 0)
                + (f2.getSuggestion() != null ? f2.getSuggestion().length() : 0);

        Finding primary = len1 >= len2 ? f1 : f2;
        Finding secondary = len1 >= len2 ? f2 : f1;

        if (secondary.getDescription() != null
                && !secondary.getDescription().isBlank()
                && !primary.getDescription().contains(secondary.getDescription())) {
            primary.setDescription(primary.getDescription()
                    + "\n(补充: " + secondary.getDescription() + ")");
        }
        return primary;
    }

    /**
     * 排序比较器:严重程度 > 类别优先级 > 行号
     */
    private int compareFindings(Finding f1, Finding f2) {
        int sev1 = f1.getSeverity() != null ? f1.getSeverity() : Integer.MAX_VALUE;
        int sev2 = f2.getSeverity() != null ? f2.getSeverity() : Integer.MAX_VALUE;
        if (sev1 != sev2) return Integer.compare(sev1, sev2);

        int cat1 = getCategoryPriority(f1.getCategory());
        int cat2 = getCategoryPriority(f2.getCategory());
        if (cat1 != cat2) return Integer.compare(cat1, cat2);

        int line1 = f1.getStartLine() != null ? f1.getStartLine() : Integer.MAX_VALUE;
        int line2 = f2.getStartLine() != null ? f2.getStartLine() : Integer.MAX_VALUE;
        return Integer.compare(line1, line2);
    }

    private int getCategoryPriority(String category) {
        if (category == null) return 99;
        return CATEGORY_PRIORITY.getOrDefault(category.toUpperCase(), 99);
    }
}
3.7 在 ReviewService 中集成大文件检测
修改 ReviewService.java,在 executeReviewStrategy() 方法中添加大文件检测逻辑:
// 注入 TokenEstimationService 和 MapReduceReviewService
private final TokenEstimationService tokenEstimationService;
private final MapReduceReviewService mapReduceReviewService;

// ... 在 executeReviewStrategy 方法中,找到 AI 审查的分支:
if (resolvedProvider == null) {
    // ... 获取可用提供商
}

final ModelProviderEnum provider = resolvedProvider;
final String providerNameForAi = provider != null ? provider.name() : requestedProvider;
final int blockStartLine = 1;

// 大文件检测:代码超过Token限制时自动转入 AST切片 + Map-Reduce 审查
boolean isLargeFile = false;
try {
    isLargeFile = tokenEstimationService.isLargeFile(codeContent, providerNameForAi);
} catch (Exception e) {
    log.warn("大文件检测失败,继续常规审查流程: {}", e.getMessage());
}

if (isLargeFile) {
    log.info("检测到大文件(超过Token限制),转入 AST切片 + Map-Reduce 审查流程");
    findings = mapReduceReviewService.reviewLargeFile(
            codeContent, language, providerNameForAi, enableRag, null, null);
} else {
    // 正常大小的文件走原来的语义指纹缓存 + AI 审查流程
    findings = fingerprintCacheService
            .tryGetCachedFindings(codeContent, language, provider, enableRag, blockStartLine)
            .orElseGet(() -> {
                List<Finding> fresh = aiModelService.reviewCode(
                        codeContent, language, providerNameForAi, enableRag);
                fingerprintCacheService.storeFindings(
                        codeContent, language, provider, enableRag, blockStartLine, fresh);
                return fresh;
            });
}关键点:
- 大文件检测放在缓存检查之前。大文件不经过语义指纹缓存,因为每次切片结果可能不同。
isLargeFile由TokenEstimationService判断逻辑决定。- 如果切片失败(比如解析异常),Map-Reduce 内部会回退到原始 AI 审查。
3.8 添加 Maven 依赖
在 pom.xml 中添加 JavaParser 依赖(用于 AST 解析):
<dependency>
    <groupId>com.github.javaparser</groupId>
    <artifactId>javaparser-core</artifactId>
    <version>3.26.0</version>
</dependency>
四、完整数据流
让我们用一个 500 行的 Java 文件作为例子,追踪完整流程:
原始文件(500行,约15000字符)
        │
        ▼
TokenEstimationService.isLargeFile()
        │ 估算 Token: 15000 / 3.5 ≈ 4286
        │ 可用 Token: min(2500配置, 32768模型) = 2500
        │ 4286 > 2500 → true! 触发切片
        ▼
ASTCodeSlicer.slice()
        │ JavaParser 解析 AST
        │ 发现 8 个方法 + 2 个构造器 + 1 个内部类
        │ 排除字段声明(作为上下文保留在类骨架中)
        ▼
生成 10 个方法级切片(每个切片包含 import + 类声明 + 字段 + 目标方法)
        │
        ▼
Map 阶段(线程池,并行度=5)
        │ 第一批:5 个切片同时审查(5秒)
        │ 第二批:5 个切片同时审查(5秒)
        │ 共发现 32 个原始问题
        ▼
Reduce 阶段
        │ 去重:32 → 23(9个重复问题被合并)
        │ 排序:
        │   CRITICAL: 2 (安全漏洞)
        │   HIGH: 5 (性能问题)
        │   MEDIUM: 8 (可维护性问题)
        │   LOW: 8 (代码风格)
        ▼
最终报告:23 个问题
为什么 10 个切片用 parallelism=5?
同时发送 10 个请求到同一个大模型 API 可能导致限流。使用并行度 5 的线程池,每批处理 5 个切片,剩余 5 个排队等待。
这是"控制并发、保护后端"的常见做法。
五、验证方式
- 准备测试文件:创建一个超过 2500 token 的 Java 文件(大约 9000 字符以上)
- 启动应用:确保大模型可用(DeepSeek 或 Qwen)
- 发起审查:在审查页面选择"单个文件",上传测试文件
- 查看日志:确认以下日志出现:
检测到大文件(超过Token限制),转入 AST切片 + Map-Reduce 审查流程
Java AST切片完成: 文件=xxx.java, 切片数=N
[切片完成] 共 N 个切片
[Map] 审查切片 [1/N]: xxx (行x-y)
[Map阶段完成] 共发现 M 个原始问题
[Reduce-去重] 原始 → 最终
[Reduce-排序] 按严重程度和类别优先级完成排序
========== Map-Reduce审查完成 ==========- 验证结果:审查结果应该覆盖文件所有部分,且不同方法的问题会合并去重
六、常见问题
Q: 所有文件都走切片了怎么办?
检查配置 app.large-file.enabled: true 和 max-tokens 是否设置合理。默认 2500 tokens 大约对应 9000 字符(约 300 行 Java 代码)。将 max-tokens 调高可以让更多小文件走常规审查。
Q: 某些方法切片后AI审查结果不准怎么办?
方法级切片的问题在于"缺少完整上下文"——切片中的方法看不到其他方法的实现。可以尝试:
- 增大
max-slice-chars让切片包含更多上下文 - 在
buildSliceCode中添加类的完整字段+其他方法签名(仅签名不包含实现),帮助 AI 理解类结构 - 回退到非切片模式直接审查小文件
Q: 多个切片产生重复问题?
这是预期行为。Reduce 阶段的去重逻辑(Jaccard 相似度 + 行号接近)会合并重复。如果发现去重不足(重复问题仍然出现),调高 dedup-title-similarity(如 0.8)或调低 dedup-line-proximity(如 2)。
如果发现去重过度(不同问题被合并),调低 dedup-title-similarity(如 0.6)或调低 dedup-line-proximity。
