一、概述
导出数据功能是知识库系统的重要组成部分,支持用户将文档内容导出为 PDF 或 Markdown 格式。
本文详细介绍如何在 kb-document 服务中实现完整的文档导出功能,包括单文档导出和批量导出。
1.1 功能定位
导出数据功能提供以下核心能力:
| 功能模块 | 说明 | 使用场景 |
|---|---|---|
| 单文档导出PDF | 将文档内容转换为PDF并返回下载链接 | 文档阅读、分享 |
| 单文档下载PDF | 直接将PDF文件流输出到浏览器 | 快速下载 |
| 批量导出PDF | 多文档打包为PDF格式的ZIP压缩包 | 批量归档 |
| 批量导出Markdown | 多文档打包为Markdown格式的ZIP压缩包 | 内容迁移 |
| 文档筛选 | 按标题、状态筛选要导出的文档 | 精确选择 |
1.2 技术架构
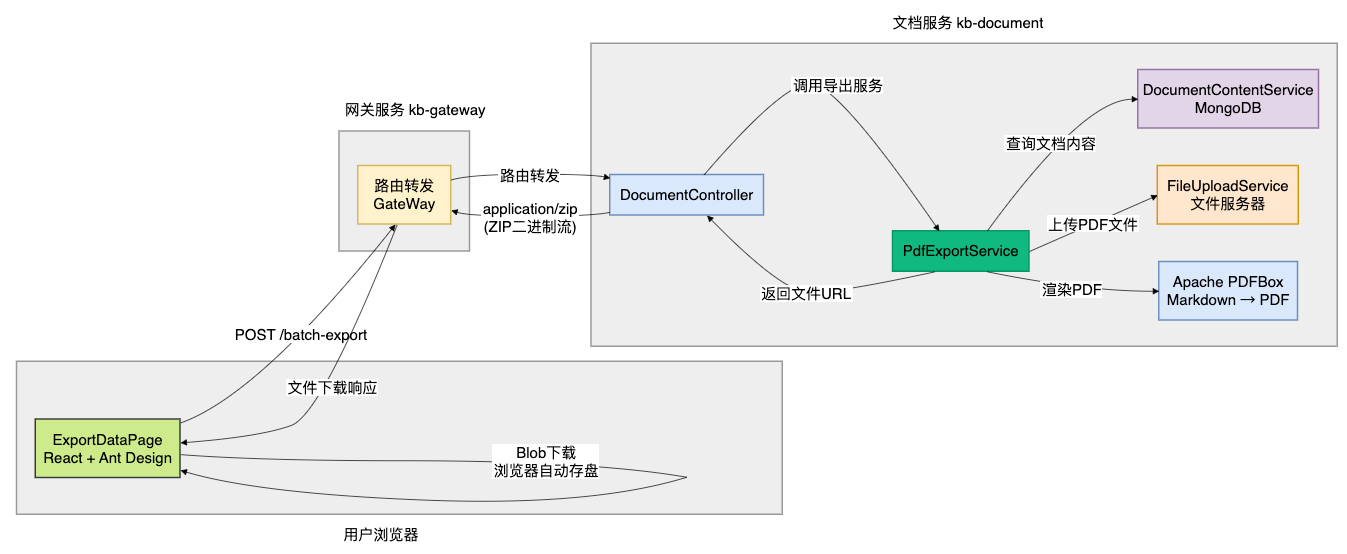
1.3 技术实现
- PDF生成:使用 Apache PDFBox 将 Markdown 内容渲染为 PDF
- 中文字体支持:多级回退策略,优先从classpath加载,再尝试系统字体
- Markdown解析:支持标题、代码块、表格、图片、列表、粗体/斜体等格式
- 批量打包:使用 Java ZipOutputStream 将多个文件打包为 ZIP
- 文件下载:通过 Content-Disposition 响应头触发浏览器下载
- Blob处理:前端使用 Blob + URL.createObjectURL 处理二进制响应
二、DTO 设计
2.1 创建 BatchExportRequest
导出功能只需一个请求 DTO,用于接收批量导出的请求参数。
创建 kb-document/src/main/java/com/knowledge/base/document/dto/BatchExportRequest.java:
package com.knowledge.base.document.dto;

import jakarta.validation.constraints.NotEmpty;
import jakarta.validation.constraints.NotNull;
import lombok.AllArgsConstructor;
import lombok.Data;
import lombok.NoArgsConstructor;

import java.util.List;

/**
 * 批量导出请求DTO
 *
 * @author 苏三
 * @since 1.0.0
 */
@Data
@NoArgsConstructor
@AllArgsConstructor
public class BatchExportRequest {

    /** 文档ID列表(使用String避免JavaScript精度丢失) */
    @NotEmpty(message = "文档ID列表不能为空")
    private List<String> documentIds;

    /** 导出格式:pdf / markdown */
    @NotNull(message = "导出格式不能为空")
    private String format;
}
2.2 设计说明
为什么使用 String 类型的 ID?
JavaScript 的 Number 类型只能安全表示 -(253 - 1) 到 (253 - 1) 范围内的整数。知识库系统使用 Snowflake 雪花算法生成的 64 位长整型 ID,超出了 JavaScript 的安全范围,直接从 JSON 反序列化会导致精度丢失。
因此,导出请求中的 documentIds 使用 List<String> 类型:
- 前端将选中的文档ID以字符串形式传递
- 后端接到请求后,使用
Long.parseLong()转换为 Long 类型 - 避免了跨语言数据传递中的精度丢失问题
三、业务逻辑层
3.1 创建 PdfExportService 接口
创建 kb-document/src/main/java/com/knowledge/base/document/service/PdfExportService.java:
package com.knowledge.base.document.service;

import java.util.List;

/**
 * PDF导出服务接口
 *
 * @author 苏三
 * @since 1.0.0
 */
public interface PdfExportService {

    /**
     * 导出文档为PDF
     *
     * @param documentId 文档ID
     * @return PDF下载URL
     */
    String exportDocumentToPdf(Long documentId);

    /**
     * 导出文档为PDF(直接返回字节数组)
     *
     * @param documentId 文档ID
     * @return PDF文件字节数组
     */
    byte[] exportDocumentToPdfBytes(Long documentId);

    /**
     * 生成PDF文件名
     *
     * @param documentId 文档ID
     * @param title 文档标题
     * @return 文件名
     */
    String generatePdfFileName(Long documentId, String title);

    /**
     * 批量导出文档
     *
     * @param documentIds 文档ID列表(String类型,避免JavaScript精度丢失)
     * @param format 导出格式(pdf / markdown)
     * @return ZIP文件字节数组
     */
    byte[] batchExportDocuments(List<String> documentIds, String format);
}
接口提供两种导出模式:
- 单文档导出:返回 PDF URL(文件上传到文件服务器)或直接返回字节数组
- 批量导出:返回 ZIP 文件字节数组,由 Controller 直接写入 HTTP 响应流
3.2 创建 PdfExportServiceImpl 实现类
创建 kb-document/src/main/java/com/knowledge/base/document/service/impl/PdfExportServiceImpl.java:
package com.knowledge.base.document.service.impl;

import cn.hutool.core.io.FileUtil;
import com.knowledge.base.common.exception.BusinessException;
import com.knowledge.base.document.entity.Category;
import com.knowledge.base.document.entity.Document;
import com.knowledge.base.document.entity.mongodb.DocumentContent;
import com.knowledge.base.document.mapper.CategoryMapper;
import com.knowledge.base.document.service.DocumentContentService;
import com.knowledge.base.document.service.DocumentService;
import com.knowledge.base.document.service.FileUploadService;
import com.knowledge.base.document.service.PdfExportService;
import jakarta.annotation.Resource;
import lombok.extern.slf4j.Slf4j;
import org.apache.pdfbox.pdmodel.PDDocument;
import org.apache.pdfbox.pdmodel.PDPage;
import org.apache.pdfbox.pdmodel.PDPageContentStream;
import org.apache.pdfbox.pdmodel.common.PDRectangle;
import org.apache.pdfbox.pdmodel.font.PDType0Font;
import org.apache.pdfbox.pdmodel.font.PDType1Font;
import org.apache.pdfbox.pdmodel.graphics.image.PDImageXObject;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.stereotype.Service;

import javax.imageio.ImageIO;
import java.awt.Color;
import java.awt.image.BufferedImage;
import java.io.ByteArrayOutputStream;
import java.io.IOException;
import java.io.InputStream;
import java.net.URL;
import java.nio.charset.StandardCharsets;
import java.nio.file.Files;
import java.nio.file.Path;
import java.nio.file.Paths;
import java.time.LocalDateTime;
import java.time.format.DateTimeFormatter;
import java.util.ArrayList;
import java.util.List;
import java.util.regex.Matcher;
import java.util.regex.Pattern;
import java.util.stream.Collectors;
import java.util.zip.ZipEntry;
import java.util.zip.ZipOutputStream;

/**
 * PDF导出服务实现类
 *
 * <p>使用Apache PDFBox将文档内容转换为PDF格式</p>
 *
 * @author 苏三
 * @since 1.0.0
 */
@Slf4j
@Service
public class PdfExportServiceImpl implements PdfExportService {

    @Resource
    private DocumentService documentService;

    @Resource
    private DocumentContentService documentContentService;

    @Resource
    private FileUploadService fileUploadService;

    @Resource
    private CategoryMapper categoryMapper;

    @Value("${file.upload.path:/data/knowledge-base/uploads}")
    private String uploadPath;

    // ======================== 布局常量 ========================

    private static final float MARGIN = 50;
    private static final float LINE_HEIGHT = 20;
    private static final float FONT_SIZE = 12;
    private static final float TITLE_FONT_SIZE = 18;
    private static final float SUBTITLE_FONT_SIZE = 10;
    private static final float CODE_FONT_SIZE = 9;
    private static final float CODE_LINE_HEIGHT = 14;

    // One Dark Pro 代码编辑器配色
    private static final Color CODE_BG = new Color(40, 44, 52);
    private static final Color CODE_BORDER = new Color(62, 68, 81);
    private static final Color CODE_HEADER_BG = new Color(33, 37, 43);
    private static final Color CODE_TEXT = new Color(171, 178, 191);
    private static final Color TABLE_HEADER_BG = new Color(240, 242, 245);
    private static final Color TABLE_BORDER = new Color(200, 200, 200);

    // ======================== Markdown 正则匹配 ========================

    private static final Pattern MARKDOWN_HEADING = Pattern.compile("^(#{1,6})\\s+(.+)$");
    private static final Pattern MARKDOWN_CODE = Pattern.compile("^```(\\w*)\\s*$");
    private static final Pattern MARKDOWN_BOLD = Pattern.compile("\\*\\*(.+?)\\*\\*");
    private static final Pattern MARKDOWN_ITALIC = Pattern.compile("\\*(.+?)\\*");
    private static final Pattern MARKDOWN_LINK = Pattern.compile("\\[(.+?)\\]\\((.+?)\\)");
    private static final Pattern MARKDOWN_LIST = Pattern.compile("^[-*+]\\s+(.+)$");
    private static final Pattern MARKDOWN_NUMBER_LIST = Pattern.compile("^\\d+\\.\\s+(.+)$");
    private static final Pattern MARKDOWN_IMAGE = Pattern.compile("!\\[([^\\]]*)\\]\\(([^)]+)\\)");

    // ======================== 中文字体路径 ========================

    /**
     * 系统中文字体路径(按优先级排序)
     */
    private static final String[] CHINESE_FONT_PATHS = {
            "/System/Library/Fonts/Supplemental/Arial Unicode.ttf",  // macOS
            "/Library/Fonts/Arial Unicode.ttf",
            "/usr/share/fonts/wqy/wqy-zenhei.ttc",   // Linux 文泉驿正黑
            "C:\\Windows\\Fonts\\simsun.ttc",          // Windows 宋体
    };

    // ======================== 单文档导出 ========================

    @Override
    public String exportDocumentToPdf(Long documentId) {
        log.info("导出文档为PDF:documentId={}", documentId);

        // 1. 获取文档信息
        Document document = documentService.getById(documentId);
        if (document == null) {
            throw new BusinessException("文档不存在");
        }

        // 2. 从MongoDB获取文档内容
        DocumentContent documentContent = documentContentService.getContentById(document.getContentId());
        String content = documentContent != null ? documentContent.getContent() : "";
        if (content == null || content.isEmpty()) {
            content = "";
        }

        // 3. 获取分类名称
        String categoryName = resolveCategoryName(document.getCategoryId());

        // 4. 生成PDF
        byte[] pdfBytes = generatePdf(document.getTitle(), content,
                document.getAuthorName(), categoryName,
                document.getSummary(), document.getPublishTime());

        // 5. 生成文件名并上传到文件服务器
        String fileName = generatePdfFileName(documentId, document.getTitle());
        String pdfUrl = fileUploadService.uploadBytes(pdfBytes, fileName, "application/pdf");

        log.info("PDF导出成功:documentId={}, pdfUrl={}", documentId, pdfUrl);
        return pdfUrl;
    }

    @Override
    public byte[] exportDocumentToPdfBytes(Long documentId) {
        log.info("导出文档为PDF字节数组:documentId={}", documentId);

        Document document = documentService.getById(documentId);
        if (document == null) {
            throw new BusinessException("文档不存在");
        }

        DocumentContent documentContent = documentContentService.getContentById(document.getContentId());
        String content = documentContent != null ? documentContent.getContent() : "";
        if (content == null || content.isEmpty()) {
            content = "";
        }

        String categoryName = resolveCategoryName(document.getCategoryId());
        return generatePdf(document.getTitle(), content,
                document.getAuthorName(), categoryName,
                document.getSummary(), document.getPublishTime());
    }

    @Override
    public String generatePdfFileName(Long documentId, String title) {
        String safeTitle = FileUtil.mainName(FileUtil.cleanInvalid(title));
        if (safeTitle == null || safeTitle.isEmpty()) {
            safeTitle = "document";
        }
        if (safeTitle.length() > 50) {
            safeTitle = safeTitle.substring(0, 50);
        }

        String timestamp = LocalDateTime.now().format(DateTimeFormatter.ofPattern("yyyyMMddHHmmss"));
        return String.format("%s_%s.pdf", safeTitle, timestamp);
    }

    // ======================== 批量导出 ========================

    @Override
    public byte[] batchExportDocuments(List<String> documentIds, String format) {
        log.info("批量导出文档:documentIds={}, format={}", documentIds, format);

        // 将String ID转为Long,避免JavaScript精度丢失
        List<Long> longIds = documentIds.stream()
                .map(Long::parseLong)
                .collect(Collectors.toList());

        ByteArrayOutputStream baos = new ByteArrayOutputStream();
        try (ZipOutputStream zos = new ZipOutputStream(baos)) {

            List<Document> documents = documentService.listByIds(longIds);
            log.info("查询到{}个文档(请求{}个)", documents.size(), documentIds.size());

            for (Document document : documents) {
                DocumentContent documentContent = documentContentService.getContentById(document.getContentId());
                String content = documentContent != null ? documentContent.getContent() : "";
                if (content == null) content = "";

                String fileName;
                byte[] fileBytes;

                if ("markdown".equalsIgnoreCase(format)) {
                    // Markdown格式:直接导出原始Markdown内容
                    fileName = sanitizeFileName(document.getTitle()) + ".md";
                    fileBytes = content.getBytes(StandardCharsets.UTF_8);
                } else {
                    // PDF格式:渲染为PDF
                    String categoryName = resolveCategoryName(document.getCategoryId());
                    byte[] pdfBytes = generatePdf(document.getTitle(), content,
                            document.getAuthorName(), categoryName,
                            document.getSummary(), document.getPublishTime());
                    fileName = generatePdfFileName(document.getId(), document.getTitle());
                    fileBytes = pdfBytes;
                }

                ZipEntry entry = new ZipEntry(fileName);
                zos.putNextEntry(entry);
                zos.write(fileBytes);
                zos.closeEntry();
            }

            zos.finish();
        } catch (IOException e) {
            log.error("批量导出失败", e);
            throw new RuntimeException("批量导出失败:" + e.getMessage());
        }

        log.info("批量导出成功:共{}个文档", documentIds.size());
        return baos.toByteArray();
    }

    private String sanitizeFileName(String title) {
        if (title == null || title.isEmpty()) {
            return "untitled";
        }
        return title.replaceAll("[\\\\/:*?\"<>|]", "_").trim();
    }
}
3.3 PDF 渲染引擎
PDF渲染是导出功能的核心,负责将 Markdown 内容转换为可视化页面。
3.3.1 页面布局
使用 A4 纸张大小(210mm × 297mm),设置上下左右各 50 点的页边距:
PDPage page = new PDPage(PDRectangle.A4);
float yPosition = page.getMediaBox().getHeight() - MARGIN;
float pageWidth = page.getMediaBox().getWidth() - 2 * MARGIN;
3.3.2 中文字体加载
采用多级回退策略,确保在不同操作系统上都能正确渲染中文:
- 优先 classpath 资源:
/fonts/Arial Unicode.ttf(部署到服务器后保证可用) - 备用 classpath:
/fonts/simsun.ttc - 系统字体路径:macOS / Linux / Windows 按优先级尝试
private PDType0Font loadChineseFont(PDDocument document) throws IOException {
    // 优先从classpath资源文件加载
    try (InputStream is = getClass().getResourceAsStream("/fonts/Arial Unicode.ttf")) {
        if (is != null) {
            log.info("从classpath资源加载中文字体:Arial Unicode.ttf");
            return PDType0Font.load(document, is);
        }
    }
    // 备用:尝试其他classpath资源
    try (InputStream is = getClass().getResourceAsStream("/fonts/simsun.ttc")) {
        if (is != null) {
            return PDType0Font.load(document, is);
        }
    }
    // 回退:尝试从系统字体路径加载
    for (String fontPath : CHINESE_FONT_PATHS) {
        Path path = Paths.get(fontPath);
        if (Files.exists(path)) {
            return PDType0Font.load(document, path.toFile());
        }
    }
    throw new IOException("未找到可用的中文字体");
}
3.3.3 Markdown 内容渲染
PDF引擎按行解析 Markdown 内容,根据不同格式调用对应的渲染方法:
| 内容类型 | 检测方式 | 渲染效果 |
|---|---|---|
| 标题 (H1-H6) | ^#{1,6}\s+(.+)$ | 不同字号 + 加粗,H1=18pt,每降一级减2pt |
| 代码块 | ^```(\w*)\s*$ | One Dark Pro 深色主题背景 + 行号 + 等宽字体 |
| 表格 | \` | ... |
| 图片 |  | 从URL下载 + 嵌入PDF + 自适应缩放(最大400x300) |
| 列表 | ^[-*+]\s+(.+)$ | 缩进20pt + 项目符号 |
| 有序列表 | ^\d+\.\s+(.+)$ | 缩进20pt + 数字序号 |
| 粗体 | \*\*(.+?)\*\* | 提取纯文本 |
| 斜体 | \*(.+?)\* | 提取纯文本 |
| 链接 | \[(.+?)\]\((.+?)\) | 提取链接文本 |
| 空行 | 空字符串 | 垂直间距缩小一半 |
3.3.4 代码块渲染
代码块采用程序员友好的深色主题效果:
// 绘制代码块背景
float codeBlockHeight = codeLines.size() * CODE_LINE_HEIGHT + 16;
contentStream.setNonStrokingColor(CODE_BG);
contentStream.addRect(MARGIN, yPosition - codeBlockHeight,
        pageWidth, codeBlockHeight);
contentStream.fill();

// 绘制顶部语言标签栏
contentStream.setNonStrokingColor(CODE_HEADER_BG);
contentStream.addRect(MARGIN, yPosition - 20, pageWidth, 20);
contentStream.fill();

// 绘制代码行号和内容
for (int j = 0; j < codeLines.size(); j++) {
    contentStream.beginText();
    contentStream.setFont(chineseFont, CODE_FONT_SIZE);
    contentStream.setNonStrokingColor(CODE_TEXT);
    contentStream.newLineAtOffset(MARGIN + 8, yPosition - 20 - (j + 1) * CODE_LINE_HEIGHT);
    contentStream.showText(String.format("%3d | %s", j + 1, codeLines.get(j)));
    contentStream.endText();
}
3.3.5 表格渲染
使用 Java 浮点运算绘制带对齐功能的完整表格:
private RenderResult renderTable(PDPageContentStream contentStream,
        PDDocument document, PDPage page, List<String[]> tableData,
        PDType0Font font, float yPosition, float pageWidth, float margin) {

    int colCount = tableData.get(0).length;

    // 计算列宽(平均分配)
    float tableWidth = pageWidth;
    float colWidth = tableWidth / colCount;
    float rowHeight = LINE_HEIGHT + 6;

    // 绘制表头
    for (int row = 0; row < tableData.size(); row++) {
        // 表头背景色
        if (row == 0) {
            contentStream.setNonStrokingColor(TABLE_HEADER_BG);
            contentStream.addRect(margin, yPosition - rowHeight, tableWidth, rowHeight);
            contentStream.fill();
        }

        // 绘制每列内容
        for (int col = 0; col < colCount; col++) {
            String cellText = tableData.get(row)[col].trim();
            contentStream.beginText();
            contentStream.setFont(font, FONT_SIZE);
            contentStream.setNonStrokingColor(Color.BLACK);
            contentStream.newLineAtOffset(margin + col * colWidth + 4,
                    yPosition - rowHeight + 4);
            contentStream.showText(cellText);
            contentStream.endText();
        }
        yPosition -= rowHeight;
    }

    return new RenderResult(contentStream, page, yPosition);
}
3.3.6 图片渲染
从远程 URL 下载图片并嵌入 PDF:
private RenderResult renderImage(PDPageContentStream contentStream,
        PDDocument document, PDPage page, String imageUrl, String imageAlt,
        float yPosition, float pageWidth, float margin) {
    try {
        // 从URL下载图片
        BufferedImage bufferedImage = ImageIO.read(new URL(imageUrl));
        float imageWidth = bufferedImage.getWidth();
        float imageHeight = bufferedImage.getHeight();

        // 缩放到合适大小(最大宽度=pageWidth,最大高度=400)
        float maxWidth = Math.min(pageWidth, 450);
        float maxHeight = 400;
        float scale = Math.min(maxWidth / imageWidth, maxHeight / imageHeight);
        float displayWidth = imageWidth * scale;
        float displayHeight = imageHeight * scale;

        // 嵌入图片到PDF
        PDImageXObject pdImage = PDImageXObject.createFromByteArray(
                document, /* image bytes */, "image");
        contentStream.drawImage(pdImage,
                margin + (pageWidth - displayWidth) / 2,
                yPosition - displayHeight,
                displayWidth, displayHeight);

        yPosition -= (displayHeight + 12);
    } catch (IOException e) {
        log.warn("无法加载图片:{}", imageUrl);
        // 图片加载失败时显示替代文本
    }

    return new RenderResult(contentStream, page, yPosition);
}
3.3.7 自动分页
当内容超出当前页面底部时,自动创建新页面:
if (yPosition < MARGIN + LINE_HEIGHT) {
    contentStream.close();
    page = new PDPage(PDRectangle.A4);
    document.addPage(page);
    contentStream = new PDPageContentStream(document, page,
            PDPageContentStream.AppendMode.OVERWRITE, true, true);
    yPosition = page.getMediaBox().getHeight() - MARGIN;
}
3.3.8 文本宽度测量和自动换行
精确测量每个字符在指定字体和字号下的宽度,超出页面宽度时自动换行:
private List<String> wrapTextByWidth(String text, float maxWidth,
        PDType0Font font, float fontSize) {
    List<String> result = new ArrayList<>();
    StringBuilder currentLine = new StringBuilder();
    float currentWidth = 0;

    for (char ch : text.toCharArray()) {
        float charWidth = getCharWidth(ch, font, fontSize);
        if (currentWidth + charWidth > maxWidth) {
            result.add(currentLine.toString());
            currentLine = new StringBuilder();
            currentWidth = 0;
        }
        currentLine.append(ch);
        currentWidth += charWidth;
    }

    if (currentLine.length() > 0) {
        result.add(currentLine.toString());
    }

    return result;
}

private float getCharWidth(char ch, PDType0Font font, float fontSize) {
    try {
        if (ch < 256) {
            return font.getStringWidth(String.valueOf(ch)) * fontSize / 1000f;
        }
        // CJK字符宽度 = 字号
        return fontSize;
    } catch (Exception e) {
        return fontSize;
    }
}
3.4 核心设计要点
1. 导出格式差异处理
| 格式 | 处理方式 | 说明 |
|---|---|---|
| 通过 Apache PDFBox 渲染为可视化页面 | 支持标题、代码、表格、图片等格式 | |
| Markdown | 直接输出原始 UTF-8 字节 | 保留完整的 Markdown 语法 |
2. 文件命名规范
- PDF文件:
{标题}_{yyyyMMddHHmmss}.pdf,标题清理掉非法字符(\ / : * ? " < > |),截断为50字符 - ZIP文件:
documents_export_{yyyyMMddHHmmss}.zip - Markdown文件:
{标题}.md
3. 错误处理策略
- 文档不存在 → 抛出 BusinessException
- 文档内容为空 → 允许导出(生成空白或只含标题的PDF)
- 图片加载失败 → 跳过该图片,不影响其他内容导出
- 字体加载失败 → 降级使用默认字体(无中文支持时仍有基本排版)
四、控制器层
4.1 添加导出接口到 DocumentController
在 kb-document/src/main/java/com/knowledge/base/document/controller/DocumentController.java 中添加三个导出相关接口:
/**
 * 导出文档为PDF
 *
 * @param documentId 文档ID
 * @return PDF下载URL
 */
@GetMapping("/{documentId}/export-pdf")
@Operation(summary = "导出PDF", description = "导出文档为PDF并返回下载链接")
public Result<String> exportDocumentToPdf(
    @Parameter(description = "文档ID", required = true)
    @PathVariable Long documentId) {
    log.info("导出PDF请求:documentId={}", documentId);

    String pdfUrl = pdfExportService.exportDocumentToPdf(documentId);
    return Result.success("PDF导出成功", pdfUrl);
}

/**
 * 下载文档PDF(直接返回文件流)
 *
 * @param documentId 文档ID
 * @param response HTTP响应
 */
@GetMapping("/{documentId}/download-pdf")
@Operation(summary = "下载PDF", description = "直接下载文档PDF文件")
public void downloadDocumentPdf(
    @Parameter(description = "文档ID", required = true)
    @PathVariable Long documentId,
    HttpServletResponse response) {
    log.info("下载PDF请求:documentId={}", documentId);

    try {
        byte[] pdfBytes = pdfExportService.exportDocumentToPdfBytes(documentId);

        DocumentVO document = documentService.getDocumentById(documentId);
        String fileName = pdfExportService.generatePdfFileName(documentId, document.getTitle());

        response.setContentType("application/pdf");

        // UTF-8 编码文件名,兼容各浏览器
        String encodedFileName = URLEncoder.encode(fileName, StandardCharsets.UTF_8)
                .replace("+", "%20");
        response.setHeader("Content-Disposition",
                "attachment; filename*=UTF-8''" + encodedFileName);
        response.setContentLength(pdfBytes.length);

        response.getOutputStream().write(pdfBytes);
        response.getOutputStream().flush();

        log.info("PDF下载成功:documentId={}", documentId);
    } catch (IOException e) {
        log.error("PDF下载失败:documentId={}", documentId, e);
        throw new RuntimeException("PDF下载失败:" + e.getMessage());
    }
}

/**
 * 批量导出文档
 *
 * @param request 批量导出请求
 * @param response HTTP响应
 */
@PostMapping("/batch-export")
@Operation(summary = "批量导出", description = "批量导出选中文档为PDF或Markdown格式的ZIP文件")
public void batchExportDocuments(
    @Parameter(description = "批量导出请求", required = true)
    @Valid @RequestBody BatchExportRequest request,
    HttpServletResponse response) {
    log.info("批量导出请求:documentIds={}, format={}",
            request.getDocumentIds(), request.getFormat());

    try {
        byte[] zipBytes = pdfExportService.batchExportDocuments(
                request.getDocumentIds(), request.getFormat());

        String fileName = "documents_export_" +
                LocalDateTime.now().format(DateTimeFormatter.ofPattern("yyyyMMddHHmmss")) + ".zip";

        response.setContentType("application/zip");
        String encodedFileName = URLEncoder.encode(fileName, StandardCharsets.UTF_8)
                .replace("+", "%20");
        response.setHeader("Content-Disposition",
                "attachment; filename*=UTF-8''" + encodedFileName);
        response.setContentLength(zipBytes.length);

        response.getOutputStream().write(zipBytes);
        response.getOutputStream().flush();

        log.info("批量导出成功:共{}个文档", request.getDocumentIds().size());
    } catch (IOException e) {
        log.error("批量导出失败", e);
        throw new RuntimeException("批量导出失败:" + e.getMessage());
    }
}
4.2 API 端点设计
| 方法 | 路径 | 说明 | 请求参数 | 响应类型 |
|---|---|---|---|---|
| GET | /documents/{id}/export-pdf | 导出单文档为PDF | documentId (路径参数) | JSON (PDF URL) |
| GET | /documents/{id}/download-pdf | 直接下载PDF文件 | documentId (路径参数) | application/pdf (二进制流) |
| POST | /documents/batch-export | 批量导出为ZIP | BatchExportRequest (JSON请求体) | application/zip (二进制流) |
4.3 接口设计说明
两种单文档导出模式的区别:
| 模式 | 请求路径 | 返回内容 | 适用场景 |
|---|---|---|---|
| 导出URL | export-pdf | JSON格式的PDF下载链接 | 前端展示下载地址,用户决定是否下载 |
| 直接下载 | download-pdf | 二进制PDF流(浏览器直接下载) | 一键下载,减少一次HTTP请求 |
批量导出使用 POST 方法的原因:
文档ID列表可能较长(上百个),GET方法的URL长度有限制(不同浏览器和服务器限值在2KB~8KB之间)。使用POST方法将ID列表放在请求体中,突破了URL长度限制。
Content-Disposition 文件名编码:
使用 filename*=UTF-8''{URL编码的文件名} 格式,这是 RFC 5987 标准,支持所有浏览器正确处理中文文件名。
五、前端实现
5.1 HTTP 请求扩展 - 下载模式
在 src/services/request.ts 中,Axios 配置需要扩展以支持文件下载场景:
// 扩展 Axios请求配置
interface CustomAxiosRequestConfig extends AxiosRequestConfig {
  skipAuth?: boolean;
  skipErrorToast?: boolean;
  showLoading?: boolean;
  // 下载模式:返回完整 AxiosResponse 以便读取 Content-Disposition 等响应头
  _download?: boolean;
}
当 _download: true 时,响应拦截器直接返回原始的 AxiosResponse(跳过标准的数据解包逻辑),这样才能获取 Content-Disposition 响应头中的文件名:
// 响应拦截器
request.interceptors.response.use((response) => {
    const customConfig = response.config as CustomAxiosRequestConfig;

    // 下载请求:直接返回完整的 AxiosResponse
    if (customConfig._download) {
      return response;
    }

    // 标准请求:解包数据
    const data = response.data;
    // ... 标准处理逻辑
});
同时提供通用的下载辅助函数:
/**
 * 下载文件
 */
download: (url: string, filename?: string): Promise<void> => {
    return request.get(url, {
      responseType: 'blob',
      _download: true,
    } as any).then((response: AxiosResponse) => {
      // 从 Content-Disposition 响应头中提取文件名
      let finalFilename = filename || 'download';
      const contentDisposition = response.headers?.['content-disposition'] || '';
      const match = contentDisposition.match(/filename\*=UTF-8''([^"';]+)/);
      if (match) {
        try {
          finalFilename = decodeURIComponent(match[1]);
        } catch {
          finalFilename = match[1];
        }
      }

      // 创建Blob并触发下载
      const blob = new Blob([response.data], { type: 'application/octet-stream' });
      const link = document.createElement('a');
      link.href = URL.createObjectURL(blob);
      link.download = finalFilename;
      document.body.appendChild(link);
      link.click();
      document.body.removeChild(link);
      URL.revokeObjectURL(link.href);
    });
},
5.2 前端 API 服务
在 src/services/document.service.ts 中添加三个导出接口方法:
// 导出文档为PDF(获取下载链接)
exportDocumentToPdf: (documentId: string) => {
    return http.get<string>(`/document/documents/${documentId}/export-pdf`);
},

// 下载文档PDF(直接下载)
downloadDocumentPdf: (documentId: string) => {
    return (http as any).download(`/document/documents/${documentId}/download-pdf`);
},

// 批量导出文档
batchExportDocuments: async (documentIds: string[], format: 'pdf' | 'markdown') => {
    // 使用 _download 模式获取完整响应(包括 headers)
    const response: any = await request.post('/document/documents/batch-export',
        { documentIds, format }, {
        responseType: 'blob',
        _download: true,
    } as any);

    // 检查响应是否为 JSON 错误(而非 ZIP 文件)
    const contentType = response.headers?.['content-type'] || '';
    if (contentType.includes('application/json')) {
        // 读取错误信息
        const text = await response.data.text();
        const errorData = JSON.parse(text);
        throw new Error(errorData.message || '导出失败');
    }

    // 从 Content-Disposition 中提取文件名
    const contentDisposition = response.headers?.['content-disposition'] || '';
    let filename = `documents_export_${new Date().toISOString().slice(0, 10)}.zip`;
    const match = contentDisposition.match(/filename\*=UTF-8''([^"';]+)/);
    if (match) {
        try {
            filename = decodeURIComponent(match[1]);
        } catch {
            filename = match[1];
        }
    }

    // 创建 Blob 并触发浏览器下载
    const blob = new Blob([response.data], { type: 'application/zip' });
    const link = document.createElement('a');
    link.href = URL.createObjectURL(blob);
    link.download = filename;
    document.body.appendChild(link);
    link.click();
    document.body.removeChild(link);
    URL.revokeObjectURL(link.href);
},
5.3 前端页面 - ExportDataPage
创建 src/pages/ExportDataPage.tsx:
import React, { useState, useEffect, useCallback } from 'react';
import {
  Card,
  Table,
  Button,
  Space,
  Input,
  Select,
  Radio,
  Row,
  Col,
  Typography,
  Alert,
  Tag,
} from 'antd';
import { App } from 'antd';
import {
  FileTextOutlined,
  FilePdfOutlined,
  FileMarkdownOutlined,
  SearchOutlined,
  ReloadOutlined,
  DownloadOutlined,
  ClearOutlined,
} from '@ant-design/icons';
import type { ColumnsType } from 'antd/es/table';
import dayjs from 'dayjs';
import { documentService } from '@/services';
import { Document } from '@/types';

const { Title, Text } = Typography;

const ExportDataPage: React.FC = () => {
  const { message } = App.useApp();
  const [loading, setLoading] = useState(false);
  const [exporting, setExporting] = useState(false);
  const [documents, setDocuments] = useState<Document[]>([]);
  const [total, setTotal] = useState(0);
  const [selectedRowKeys, setSelectedRowKeys] = useState<React.Key[]>([]);
  const [exportFormat, setExportFormat] = useState<'pdf' | 'markdown'>('pdf');
  const [keyword, setKeyword] = useState('');
  const [statusFilter, setStatusFilter] = useState<number | undefined>(undefined);
  const [pagination, setPagination] = useState({ current: 1, pageSize: 10 });

  // 获取文档列表
  const fetchDocuments = useCallback(async () => {
    setLoading(true);
    try {
      const result = await documentService.getDocuments({
        keyword: keyword || undefined,
        status: statusFilter,
        page: pagination.current,
        pageSize: pagination.pageSize,
        sortBy: 'updateTime',
        sortOrder: 'desc',
      });
      setDocuments(result.list);
      setTotal(result.total);
    } catch {
      message.error('获取文档列表失败');
    } finally {
      setLoading(false);
    }
  }, [keyword, statusFilter, pagination.current, pagination.pageSize, message]);

  useEffect(() => {
    fetchDocuments();
  }, [fetchDocuments]);

  // 批量导出处理
  const handleExport = async () => {
    if (selectedRowKeys.length === 0) {
      message.warning('请先选择要导出的文档');
      return;
    }
    setExporting(true);
    try {
      const ids = selectedRowKeys.map(String);
      await documentService.batchExportDocuments(ids, exportFormat);
      message.success(`成功导出 ${ids.length} 个文档`);
    } catch {
      message.error('导出失败,请重试');
    } finally {
      setExporting(false);
    }
  };

  // 表格列定义
  const columns: ColumnsType<Document> = [
    {
      title: '文档标题',
      dataIndex: 'title',
      key: 'title',
      ellipsis: true,
      render: (text: string) => (
        <Space>
          <FileTextOutlined style={{ color: '#2563eb' }} />
          <Text ellipsis={{ tooltip: text }} style={{ maxWidth: 300 }}>
            {text}
          </Text>
        </Space>
      ),
    },
    {
      title: '作者',
      dataIndex: 'authorName',
      key: 'authorName',
      width: 120,
    },
    {
      title: '状态',
      dataIndex: 'status',
      key: 'status',
      width: 100,
      render: (status: number) => {
        const statusMap: Record<number, { label: string; color: string }> = {
          0: { label: '草稿', color: 'default' },
          1: { label: '已发布', color: 'green' },
          2: { label: '已归档', color: 'orange' },
        };
        const info = statusMap[status] || { label: '未知', color: 'default' };
        return <Tag color={info.color}>{info.label}</Tag>;
      },
    },
    {
      title: '更新时间',
      dataIndex: 'updateTime',
      key: 'updateTime',
      width: 180,
      render: (time: string) => time ? dayjs(time).format('YYYY-MM-DD HH:mm:ss') : '-',
      sorter: true,
    },
  ];

  const hasSelected = selectedRowKeys.length > 0;

  return (
    <div style={{ padding: '16px 16px 32px 16px', minHeight: '100vh', background: '#f8fafc' }}>
      {/* 页面头部 */}
      <div style={{ display: 'flex', justifyContent: 'space-between', alignItems: 'flex-start', marginBottom: 24 }}>
        <div>
          <Title level={1} style={{ fontSize: 32, fontWeight: 700, color: '#0f172a', marginBottom: 8 }}>
            导出数据
          </Title>
          <Text style={{ fontSize: 16, color: '#475569' }}>
            选择文档并导出为 PDF 或 Markdown 格式的 ZIP 压缩包
          </Text>
        </div>
      </div>
      {/* 筛选栏 */}
      <Card style={{ borderRadius: 12, marginBottom: 16 }} variant="borderless">
        <Row gutter={[16, 16]} align="middle">
          <Col xs={24} sm={8} lg={6}>
            <Input
              placeholder="搜索文档标题"
              allowClear
              prefix={<SearchOutlined />}
              value={keyword}
              onChange={(e) => {
                setKeyword(e.target.value);
                setPagination((prev) => ({ ...prev, current: 1 }));
              }}
            />
          </Col>
          <Col xs={24} sm={6} lg={4}>
            <Select
              placeholder="文档状态"
              allowClear
              style={{ width: '100%' }}
              value={statusFilter}
              onChange={(val) => {
                setStatusFilter(val === 'all' ? undefined : val);
                setPagination((prev) => ({ ...prev, current: 1 }));
              }}
            >
              <Select.Option value="all">全部状态</Select.Option>
              <Select.Option value={0}>草稿</Select.Option>
              <Select.Option value={1}>已发布</Select.Option>
              <Select.Option value={2}>已归档</Select.Option>
            </Select>
          </Col>
          <Col xs={24} sm={10} lg={14}>
            <Space>
              <Button icon={<ReloadOutlined />} onClick={fetchDocuments}>刷新</Button>
              {hasSelected && (
                <Button icon={<ClearOutlined />} onClick={() => setSelectedRowKeys([])}>
                  取消选择
                </Button>
              )}
            </Space>
          </Col>
        </Row>
      </Card>
      {/* 导出配置栏 */}
      <Card style={{ borderRadius: 12, marginBottom: 16 }} variant="borderless">
        <Row gutter={[24, 16]} align="middle">
          <Col xs={24} md={14}>
            <Space size="middle">
              <Text strong>导出格式:</Text>
              <Radio.Group value={exportFormat} onChange={(e) => setExportFormat(e.target.value)}>
                <Radio.Button value="pdf">
                  <Space>
                    <FilePdfOutlined />
                    PDF
                  </Space>
                </Radio.Button>
                <Radio.Button value="markdown">
                  <Space>
                    <FileMarkdownOutlined />
                    Markdown
                  </Space>
                </Radio.Button>
              </Radio.Group>
            </Space>
          </Col>
          <Col xs={24} md={10}>
            <Space style={{ float: 'right' }}>
              {hasSelected && (
                <Text style={{ color: '#2563eb', fontWeight: 500 }}>
                  已选择 <Text strong style={{ fontSize: 18 }}>{selectedRowKeys.length}</Text> 个文档
                </Text>
              )}
              <Button
                type="primary"
                icon={<DownloadOutlined />}
                onClick={handleExport}
                loading={exporting}
                disabled={!hasSelected}
                size="large"
              >
                导出选中文档
              </Button>
            </Space>
          </Col>
        </Row>
        {selectedRowKeys.length > 0 && (
          <Alert
            message={`将导出 ${selectedRowKeys.length} 个文档为 ${exportFormat.toUpperCase()} 格式的 ZIP 压缩包`}
            type="info"
            showIcon
            style={{ marginTop: 12 }}
          />
        )}
      </Card>
      {/* 文档表格 */}
      <Card style={{ borderRadius: 12 }} variant="borderless">
        <Table
          rowKey="id"
          columns={columns}
          dataSource={documents}
          loading={loading}
          rowSelection={{
            selectedRowKeys,
            onChange: (keys) => setSelectedRowKeys(keys),
          }}
          onChange={(pag: any) => {
            setPagination({ current: pag.current, pageSize: pag.pageSize });
          }}
          pagination={{
            ...pagination,
            total,
            showSizeChanger: true,
            showQuickJumper: true,
            showTotal: (t: number) => `共 ${t} 条`,
          }}
          scroll={{ x: 600 }}
        />
      </Card>
    </div>
  );
};

export default ExportDataPage;
5.4 前端设计说明
1. 状态管理
| 状态 | 类型 | 用途 |
|---|---|---|
| loading | boolean | 文档列表加载中 |
| exporting | boolean | 导出进行中 |
| documents | Document[] | 当前页文档列表 |
| total | number | 文档总数 |
| selectedRowKeys | React.Key[] | 表格勾选的行 |
| exportFormat | 'pdf' | 'markdown' |
| keyword | string | 搜索关键词 |
| statusFilter | number | undefined |
| pagination | {current, pageSize} | 分页参数 |
2. 筛选条件组合
前端发送请求时,undefined 的筛选参数不发送给后端,后端会忽略这些参数:
const result = await documentService.getDocuments({
    keyword: keyword || undefined,      // 空字符串转为 undefined
    status: statusFilter,               // undefined 时不传该参数
    page: pagination.current,
    pageSize: pagination.pageSize,
});
状态筛选支持"全部状态"选项(value="all"),选中时转为 undefined 表示不过滤状态。
3. 错误处理
// 检查响应是否为 JSON 错误(而非 ZIP 文件)
const contentType = response.headers?.['content-type'] || '';
if (contentType.includes('application/json')) {
    const text = await response.data.text();
    const errorData = JSON.parse(text);
    throw new Error(errorData.message || '导出失败');
}
当后端返回 JSON 错误信息(而非预期的 ZIP 文件流)时,前端能正确解读错误信息并给出提示,避免用户下载到一个包含错误消息的无效文件。
4. 文件名提取
从 HTTP 响应头的 Content-Disposition 中提取文件名的正则:
const match = contentDisposition.match(/filename\*=UTF-8''([^"';]+)/);匹配的是 RFC 5987 编码格式的文件名,支持中文等非ASCII字符。
六、路由注册
6.1 添加导出页面路由
在 src/router/index.tsx 中注册导出页面路由:
// 1. 在文件顶部添加 lazy import
const ExportDataPage = lazy(() => import('@/pages/ExportDataPage'));

// 2. 在 MainLayout 路由下添加子路由
{
    path: 'documents/export',
    element: (
      <Suspense fallback={<LoadingFallback />}>
        <ExportDataPage />
      </Suspense>
    ),
},
完整路由路径为 /documents/export,需要用户登录后才能访问(受 ProtectedRoute 保护)。
6.2 访问方式
用户可以通过以下方式进入导出页面:
- 直接在浏览器地址栏输入
http://localhost:3002/documents/export - 后续可以添加到侧边导航栏作为菜单项
七、项目依赖配置
7.1 Maven 依赖
PDF导出功能需要添加 Apache PDFBox 依赖到 kb-document/pom.xml:
<!-- Apache PDFBox - PDF生成 -->
<dependency>
    <groupId>org.apache.pdfbox</groupId>
    <artifactId>pdfbox</artifactId>
    <version>3.0.1</version>
</dependency>
7.2 字体资源
在 kb-document/src/main/resources/fonts/ 目录下放置中文字体文件:
Arial Unicode.ttf— 推荐使用(支持CJK字符集,文件较小)
字体文件用于 PDF 渲染中文内容。部署到服务器后,classpath资源会自动被加载,无需额外配置系统字体。
测试
按顺序启动下面这些微服务:
kb-gateway
kb-auth
kb-document
启动前端
cd knowledge-base-frontend
npm run dev
浏览器访问导出数据页面:
http://localhost:3002/documents/export
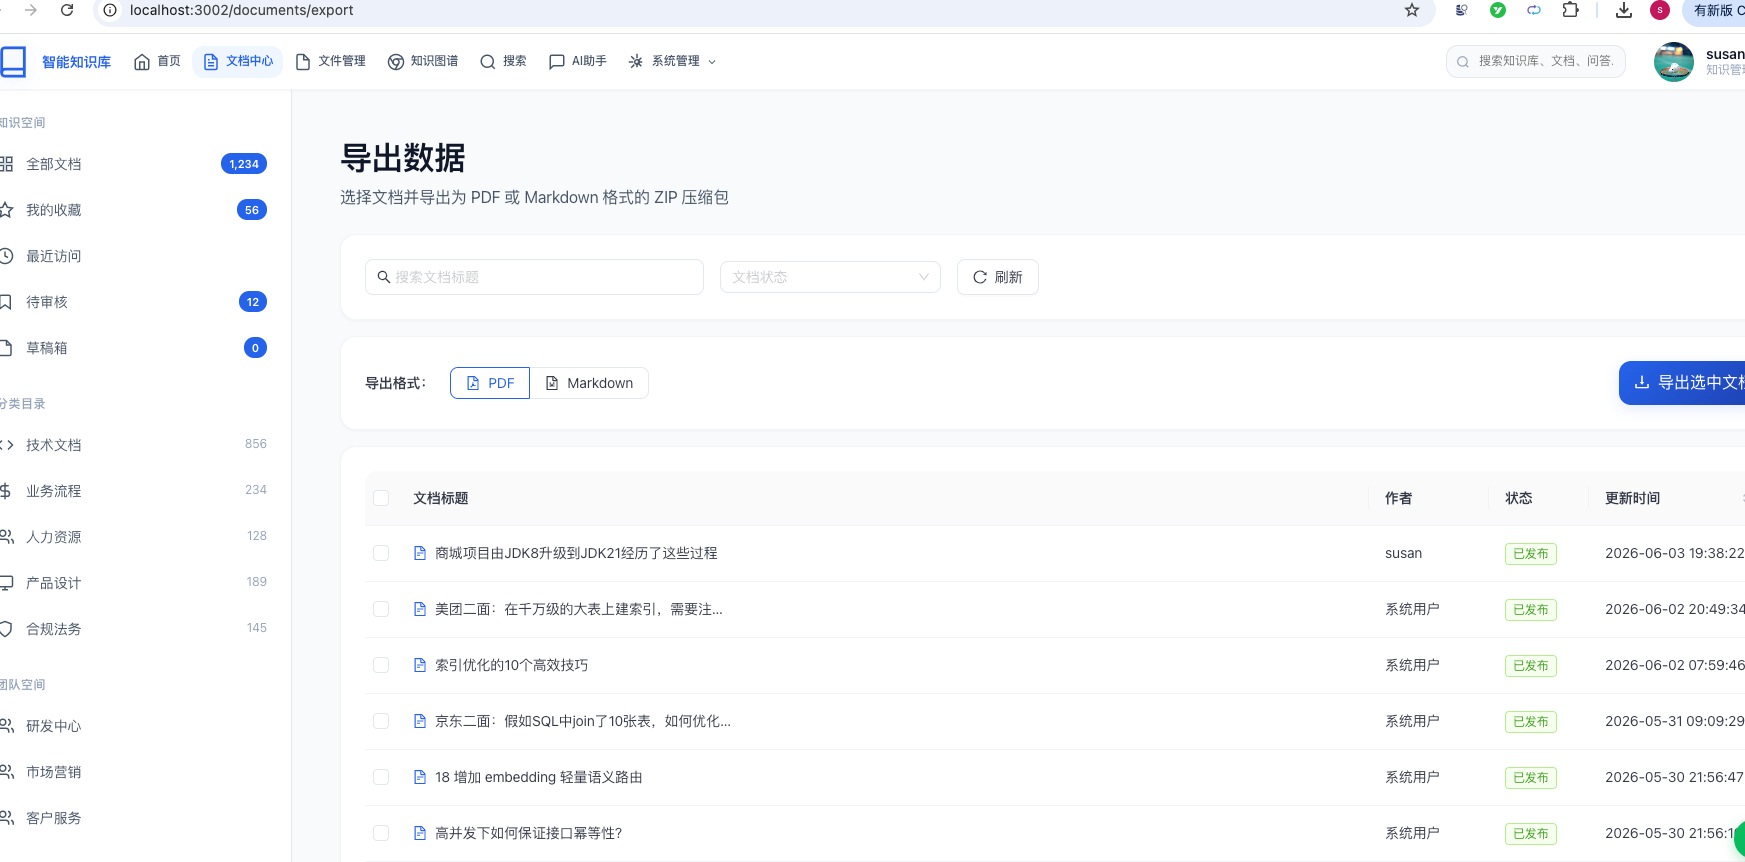
选择需要导出的文档,导出PDF格式的文件:
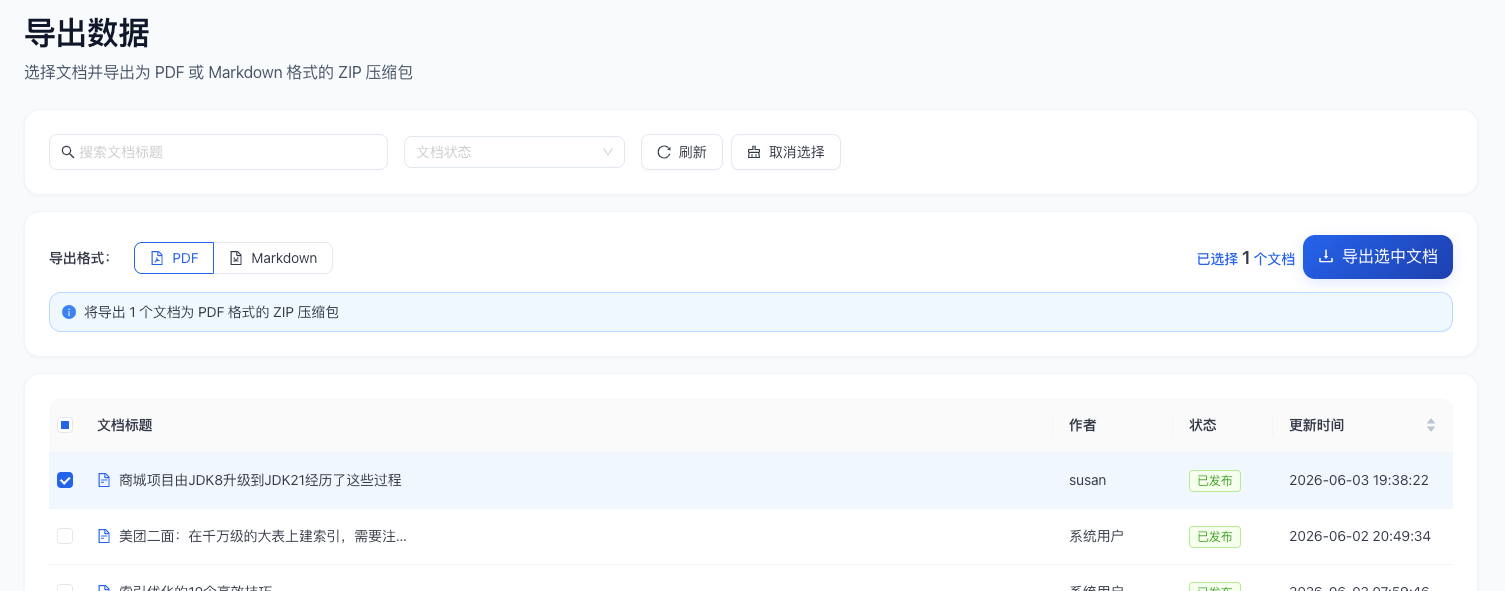
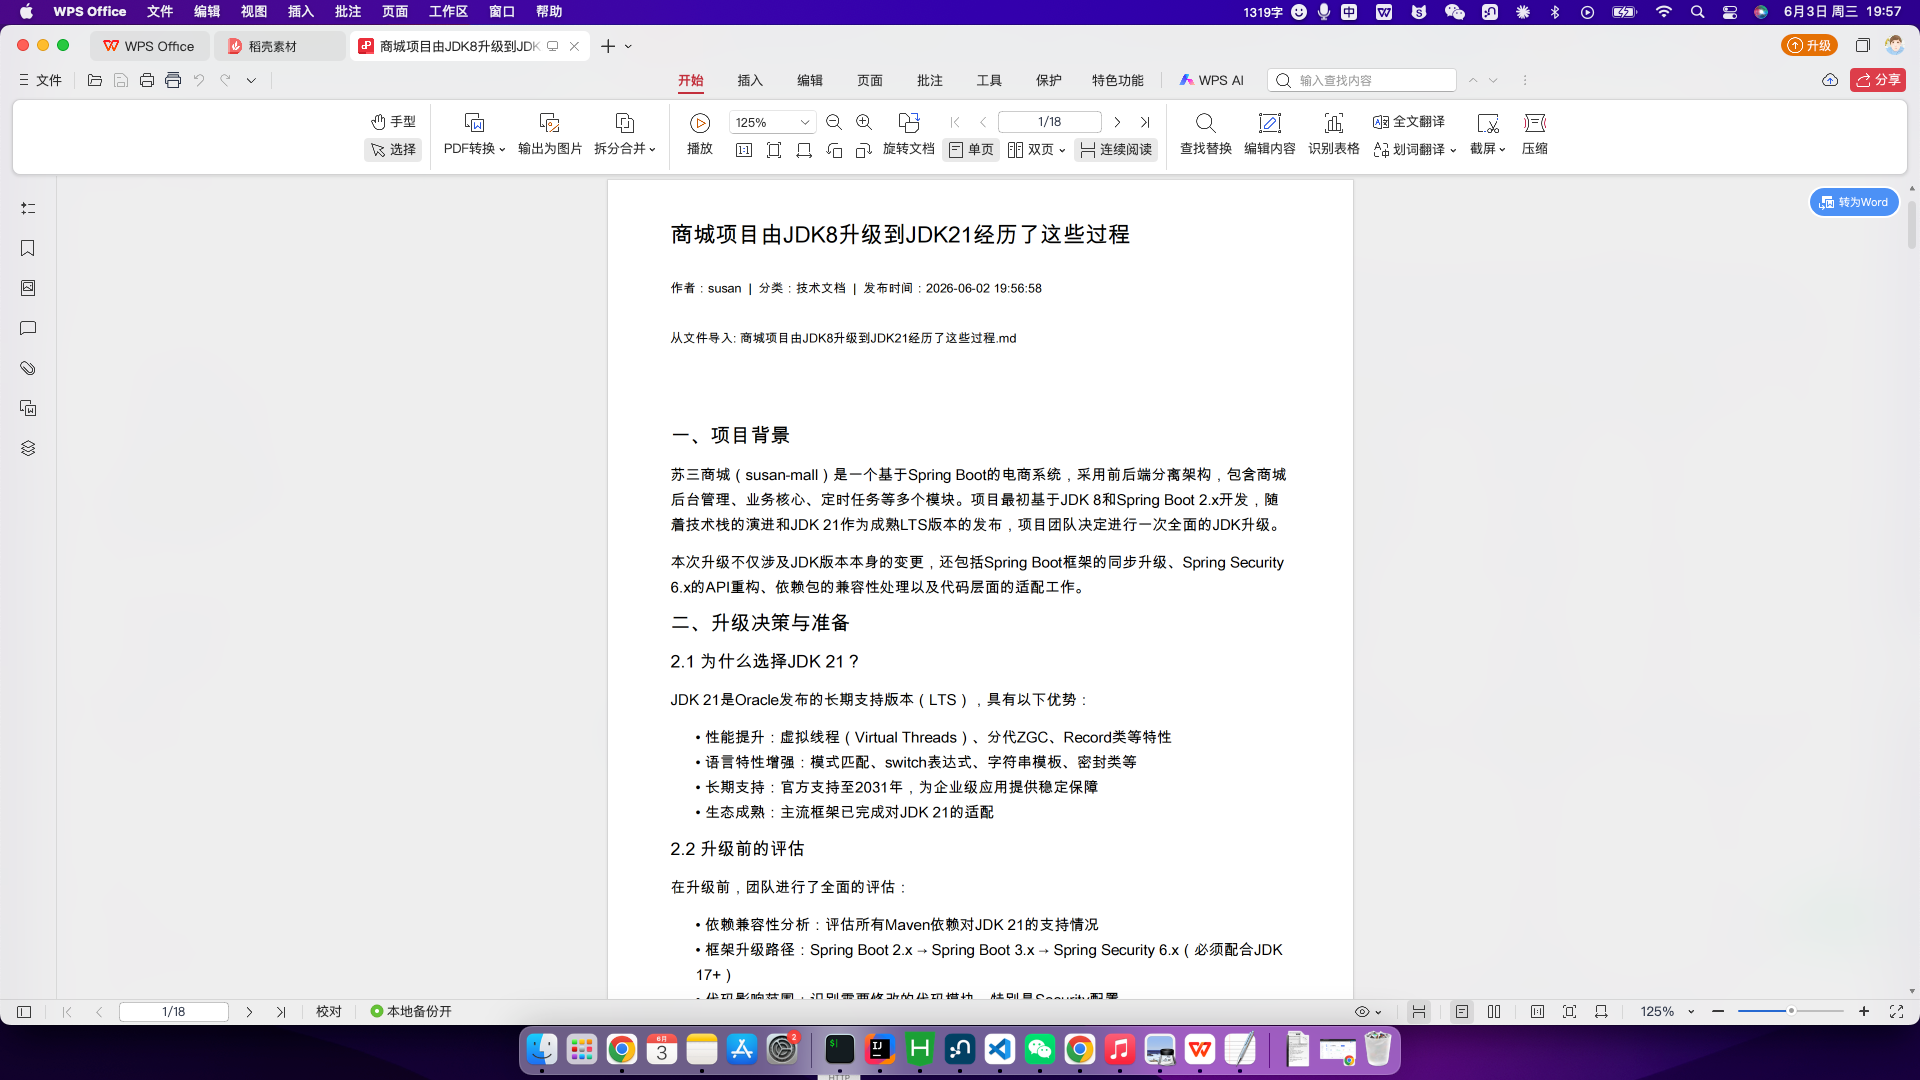
点击导出选中文档按钮,会导出一个zip压缩文件,解压之后有一个PDF文件:

打开该PDF文件,里面的文档内容能够正常显示:
然后回到数据导出页面,选择Markdown格式,再导出那篇文章:
里面能够看到markdown格式的文档。
总结
本文详细介绍了文档导出数据功能的完整实现,涵盖了以下核心内容:
已完成功能
| 功能 | 实现方式 | 说明 |
|---|---|---|
| 单文档导出PDF | Apache PDFBox | 获取下载链接 |
| 单文档下载PDF | HTTP文件流 | 浏览器直接下载 |
| 批量导出PDF | ZIP打包 | 选中文档打包下载 |
| 批量导出Markdown | ZIP打包 | 原始MD内容打包 |
| Markdown渲染 | 正则解析 + PDFBox | 标题/代码/表格/图片/列表 |
| 中日文字体 | 多级回退策略 | 跨平台兼容 |
| 前端导出页面 | React + Ant Design | 搜索/筛选/多选/导出 |
技术要点
- Markdown到PDF转换:逐行解析Markdown语法,分别处理标题、代码块、表格、图片、列表等格式
- 中文字体处理:优先从classpath加载,再回退到系统路径,确保跨平台部署
- 自动分页:内容超出页面底部时自动创建新页面,代码块和表格也支持跨页
- JavaScript精度安全:使用String类型传递长整型ID,避免JSON序列化时的精度丢失
- Blob下载:前端通过Blob + URL.createObjectURL 实现浏览器下载,不跳转页面
- 文件名编码:使用RFC 5987标准的
filename*=UTF-8''{编码后的文件名}格式
通过本文的学习,你应该能够掌握:
- Apache PDFBox 的使用方法和 PDF 生成流程
- Markdown 正则解析的技术方案
- Spring Boot 文件下载接口的设计规范
- 前端 Blob 文件下载的实现原理
- 跨语言数据传输中精度丢失问题的解决方案
- 批量文件打包(ZIP)的技术实现
祝你开发顺利!
