一、概述
之前咱们的AI助手存在两个问题:
- 响应太慢:后端使用阻塞式
ChatLanguageModel.generate()调用大模型,必须等待完整回复生成完毕后才一次性返回给前端,用户需要等待数十秒才能看到任何内容 - 没有记忆:每次对话只发送当前问题给大模型,AI 无法理解对话上下文,导致用户连续提问时回答脱节
本文将详细介绍如何将 AI 对话改造为 专业的流式输出(Token-by-Token SSE) 效果,同时引入 对话记忆功能,让 AI 能够记住对话历史。
改造完成后,AI 回复像 ChatGPT 一样逐字输出,体验流畅;连续对话时 AI 能理解上文,回答连贯。
1.1 功能对比
| 维度 | 改造前 | 改造后 |
|---|---|---|
| 回复方式 | 阻塞式,等待完整回复后一次性返回 | 流式 StreamingChatLanguageModel,token-by-token SSE 推送 |
| 首字延迟 | 数十秒 | 几百毫秒 |
| 用户体验 | 长时间白屏等待 | 逐字打字效果,即时可见 |
| 对话记忆 | 无,每次提问彼此独立 | 每次发送最近 20 条历史消息作为上下文 |
| 记忆存储 | 无 | MySQL conversation + message 表持久化 |
1.2 技术架构
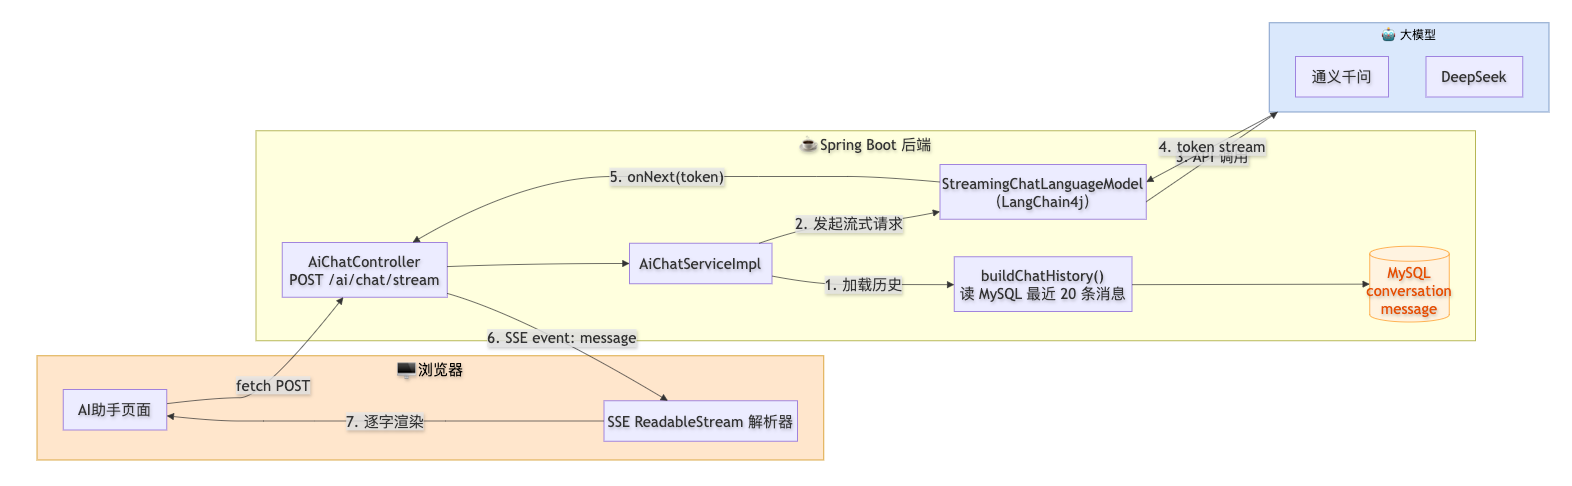
1.3 数据模型
对话记忆功能依赖两张 MySQL 表存储对话和消息:
Conversation(对话)
├── id: 对话ID(雪花ID)
├── title: 对话标题
├── user_id: 用户ID
├── model: 使用的模型
├── tokens_used: Token 消耗量
├── status: 0-进行中, 1-已结束
└── created_at / updated_at

Message(消息)
├── id: 消息ID(雪花ID)
├── conversation_id: 所属对话ID
├── role: user / assistant
├── content: 消息内容
├── tokens: 估算的 Token 数
└── created_at
1.4 核心改造点
| 改造层级 | 文件 | 改造内容 |
|---|---|---|
| 模型层 | ModelProvider.java | 新增 StreamingChatLanguageModel 支持 |
| 服务层 | AiChatServiceImpl.java | 替换阻塞调用为流式调用,新增 buildChatHistory() |
| 服务层 | RagChatServiceImpl.java | RAG 路径同步改造流式输出 |
| 接口层 | AiChatService.java | 新增 chatStream() 方法 |
| 前端服务 | ai.service.ts | 实现 SSE ReadableStream 解析 + token 批处理 |
| 前端状态 | ai.store.ts | 流式消息累积更新 |
| 前端页面 | AIAssistantPage.tsx | ReactMarkdown 渲染 + 滚动优化 |
二、后端改造:流式输出
2.1 ModelProvider:新增流式模型实例
LangChain4j 的 OpenAiStreamingChatModel 与 OpenAiChatModel 使用**相同的 API 参数**(baseUrl、apiKey、modelName、maxTokens、temperature),区别在于 OpenAiStreamingChatModel 返回的是流式响应,通过 StreamingResponseHandler 回调接口逐 token 推送。
编辑 kb-ai/src/main/java/com/knowledge/base/ai/config/ModelProvider.java,新增以下内容:
(1)新增导入
import dev.langchain4j.model.chat.StreamingChatLanguageModel;
import dev.langchain4j.model.openai.OpenAiStreamingChatModel;
(2)新增流式模型缓存
/** 流式模型实例缓存(懒加载) */
private final Map<String, StreamingChatLanguageModel> streamingInstanceCache = new ConcurrentHashMap<>();
(3)新增流式模型构建方法
/**
 * 懒加载构建 StreamingChatLanguageModel 实例(流式输出)
 */
private StreamingChatLanguageModel buildStreamingModel(String modelName) {
    switch (modelName) {
        case "qwen":
            return OpenAiStreamingChatModel.builder()
                    .baseUrl(qwenBaseUrl)
                    .apiKey(qwenApiKey)
                    .modelName(qwenModel)
                    .maxTokens(qwenMaxTokens)
                    .temperature(qwenTemperature)
                    .build();
        case "deepseek":
            return OpenAiStreamingChatModel.builder()
                    .baseUrl(deepseekBaseUrl)
                    .apiKey(deepseekApiKey)
                    .modelName(deepseekModel)
                    .maxTokens(deepseekMaxTokens)
                    .temperature(deepseekTemperature)
                    .build();
        default:
            throw new IllegalStateException("未知模型:" + modelName);
    }
}
(4)新增获取流式模型的公开方法
/**
 * 根据模型名称获取 StreamingChatLanguageModel 实例(流式输出,懒加载)
 *
 * @param modelName 模型名称(qwen | deepseek)
 * @return StreamingChatLanguageModel 实例
 * @throws IllegalStateException 如果请求的模型未配置API Key
 */
public StreamingChatLanguageModel getStreamingModel(String modelName) {
    String key = resolveModelKey(modelName);
    if (!modelAvailable.containsKey(key) || !modelAvailable.get(key)) {
        throw new IllegalStateException(
                "模型 '" + key + "' 未配置API Key,无法使用。请设置环境变量后重启服务。");
    }
    return streamingInstanceCache.computeIfAbsent(key, k -> {
        log.info("🔄 首次调用,构建 StreamingChatLanguageModel:{}", k);
        return buildStreamingModel(k);
    });
}注意:流式模型和阻塞式模型共用同一套 API Key 和参数配置(qwen.*/deepseek.*),配置项无需更改。buildStreamingModel的参数与buildModel完全一致,仅类型不同。
2.2 AiChatService 接口:新增流式方法
编辑 kb-ai/src/main/java/com/knowledge/base/ai/service/AiChatService.java,新增流式对话方法声明:
/**
 * AI对话(流式)
 *
 * @param requestDTO 对话请求
 * @param userId     用户ID
 * @return SSE事件发射器
 */
SseEmitter chatStream(ChatRequestDTO requestDTO, Long userId);
2.3 AiChatServiceImpl:核心流式逻辑
这是最核心的改造。编辑 kb-ai/src/main/java/com/knowledge/base/ai/service/impl/AiChatServiceImpl.java。
2.3.1 流式 SSE 实现原理
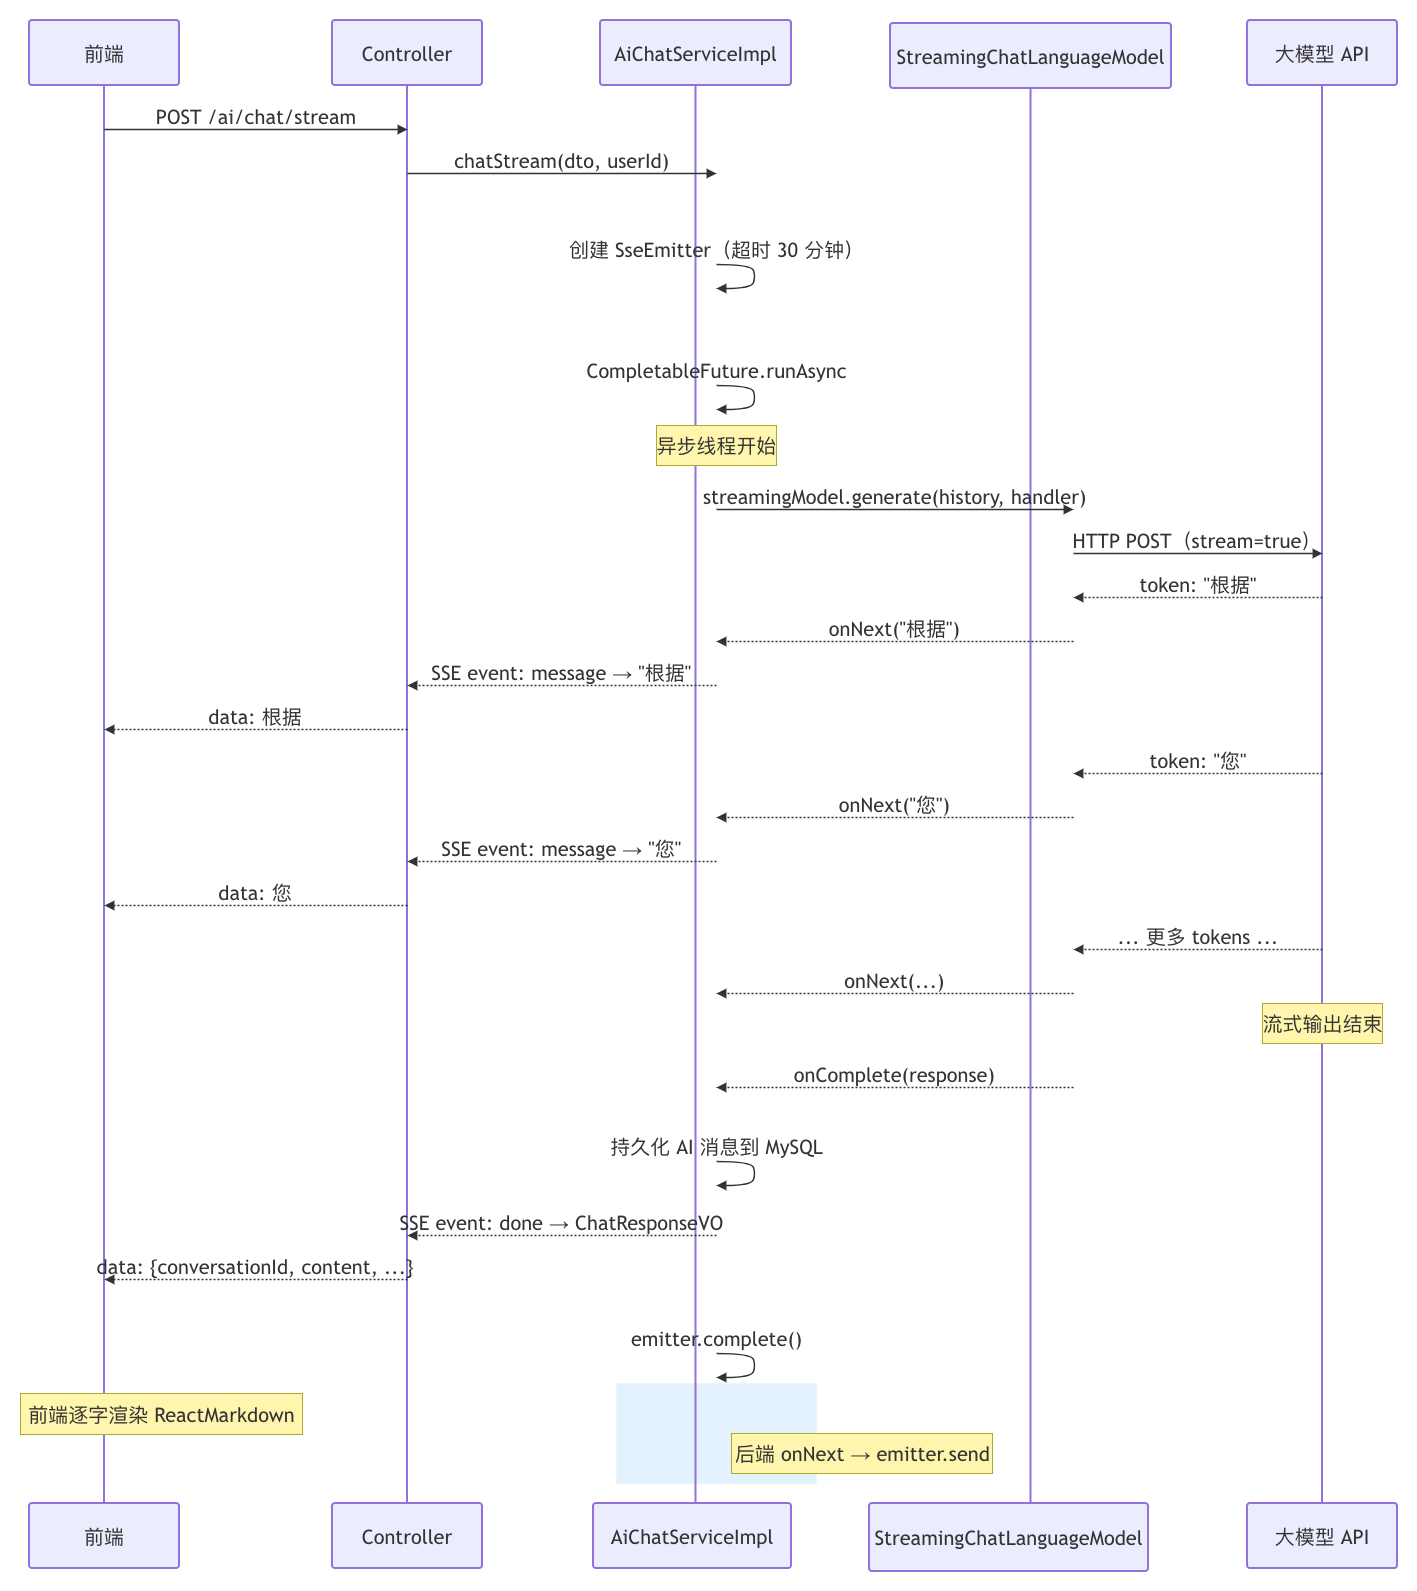
关键组件说明:
| 组件 | 说明 |
|---|---|
SseEmitter | Spring MVC 提供的 SSE 发射器,支持服务器向客户端推送事件流 |
StreamingChatLanguageModel | LangChain4j 流式接口,内部由 OkHttp 实现 HTTP 流式请求 |
StreamingResponseHandler | 回调接口:onNext(token) / onComplete() / onError() |
CompletableFuture.runAsync | 异步执行 LLM 调用,避免阻塞 Tomcat 线程 |
2.3.2 完整流式实现代码
@Override
public SseEmitter chatStream(ChatRequestDTO requestDTO, Long userId) {
    // RAG路由:如果启用了知识库检索增强且RAG服务可用
    if (requestDTO.isEnableRag() && ragChatService != null) {
        try {
            return ragChatService.chatWithContextStream(requestDTO, userId);
        } catch (Exception e) {
            log.warn("RAG流式对话失败,降级为普通LLM流式对话:{}", e.getMessage());
        }
    }

    SseEmitter emitter = new SseEmitter(30 * 60 * 1000L);  // 30分钟超时

    try {
        // 1. 创建或验证对话
        Long conversationId = requestDTO.getConversationId();
        if (conversationId == null) {
            conversationId = conversationService.createConversation(requestDTO, userId);
        } else {
            Conversation existingConv = conversationService.getById(conversationId);
            if (existingConv == null || !existingConv.getUserId().equals(userId)) {
                conversationId = conversationService.createConversation(requestDTO, userId);
            }
        }
        final Long finalConversationId = conversationId;
        final String modelName = requestDTO.getModel() != null
                ? requestDTO.getModel() : modelProvider.getDefaultModelName();

        // 2. 异步执行流式 LLM 调用
        CompletableFuture.runAsync(() -> {
            try {
                StreamingChatLanguageModel streamingModel =
                        modelProvider.getStreamingModel(modelName);

                // 3. 构建对话上下文(历史消息),实现记忆功能 ← 见第三节
                List<ChatMessage> chatMessages = buildChatHistory(finalConversationId);

                // 4. 持久化用户消息
                Message userMsgEntity = Message.builder()
                        .conversationId(finalConversationId)
                        .role("user")
                        .content(requestDTO.getContent())
                        .tokens(estimateTokens(requestDTO.getContent()))
                        .build();
                messageMapper.insert(userMsgEntity);

                // 5. 将当前用户消息加入上下文
                chatMessages.add(UserMessage.from(requestDTO.getContent()));

                // 6. 累积完整响应用于持久化
                StringBuilder fullResponseBuilder = new StringBuilder();

                // 7. 流式调用大模型
                streamingModel.generate(chatMessages,
                        new StreamingResponseHandler<AiMessage>() {

                    @Override
                    public void onNext(String token) {
                        fullResponseBuilder.append(token);
                        try {
                            emitter.send(SseEmitter.event()
                                    .name("message")
                                    .data(token));
                        } catch (IOException e) {
                            log.warn("发送流式token失败(客户端可能已断开): {}",
                                    e.getMessage());
                        }
                    }

                    @Override
                    public void onComplete(Response<AiMessage> response) {
                        try {
                            String fullResponse = fullResponseBuilder.toString();

                            // 持久化 AI 消息
                            Message aiMsgEntity = Message.builder()
                                    .conversationId(finalConversationId)
                                    .role("assistant")
                                    .content(fullResponse)
                                    .tokens(estimateTokens(fullResponse))
                                    .build();
                            messageMapper.insert(aiMsgEntity);

                            // 更新 Token 统计
                            AtomicInteger totalTokens =
                                    new AtomicInteger(userMsgEntity.getTokens());
                            totalTokens.addAndGet(aiMsgEntity.getTokens());
                            conversationService.updateTokens(
                                    finalConversationId, totalTokens.get());

                            // 发送完成事件
                            emitter.send(SseEmitter.event()
                                    .name("done")
                                    .data(ChatResponseVO.builder()
                                            .conversationId(finalConversationId)
                                            .messageId(aiMsgEntity.getId())
                                            .content(fullResponse)
                                            .tokens(totalTokens.get())
                                            .build()));
                            emitter.complete();
                        } catch (IOException e) {
                            log.warn("发送完成事件失败: {}", e.getMessage());
                        }
                    }

                    @Override
                    public void onError(Throwable error) {
                        log.error("流式对话失败: {}", error.getMessage(), error);
                        try {
                            emitter.send(SseEmitter.event()
                                    .name("error")
                                    .data(error.getMessage()));
                            emitter.complete();
                        } catch (IOException e) {
                            log.error("发送错误事件失败: {}", e.getMessage());
                        }
                    }
                });

            } catch (Exception e) {
                // 错误处理:提取 HTTP 状态码,给出友好提示
                // ... 省略详细错误处理代码 ...
                emitter.send(SseEmitter.event().name("error").data(errorMsg));
                emitter.complete();
            }
        }, asyncTaskExecutor);

    } catch (Exception e) {
        log.error("创建SSE发射器失败: {}", e.getMessage(), e);
        emitter.completeWithError(e);
    }

    return emitter;
}
2.3.3 与改造前的对比
改造前(阻塞式):
// 阻塞等待完整响应,用户体验差
ChatLanguageModel chatModel = modelProvider.getModel(modelName);
Response<AiMessage> response = chatModel.generate(chatMessages);
String responseContent = response.content().text();  // 需要等待数十秒
改造后(流式):
// 逐 token 推送,即时可见
StreamingChatLanguageModel streamingModel =
        modelProvider.getStreamingModel(modelName);
streamingModel.generate(chatMessages, new StreamingResponseHandler<AiMessage>() {
    @Override
    public void onNext(String token) {
        emitter.send(SseEmitter.event().name("message").data(token));
    }
    // ...
});
三、后端改造:对话记忆功能
3.1 记忆原理
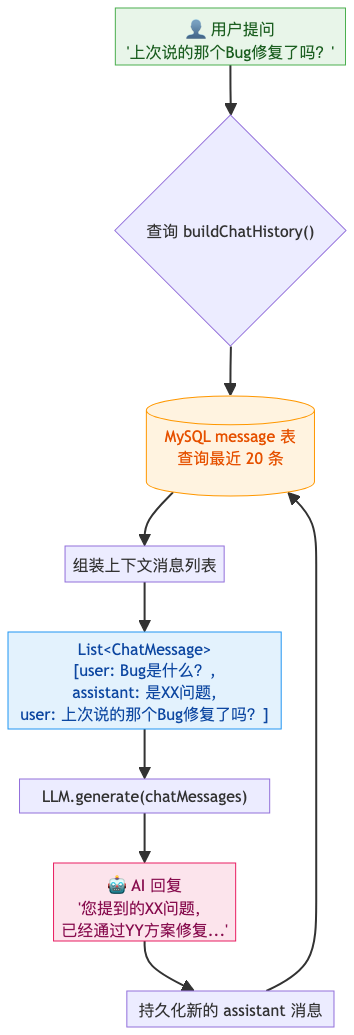
每次用户提问时,系统会从 MySQL 的 message 表中加载该对话最近 20 条消息,组装成 LangChain4j 的 List<ChatMessage> 格式,与当前问题一起发送给大模型。这样大模型就能"看到"之前的对话内容,给出连贯的回答。
为什么是 20 条? 这是一个经验值:足够覆盖常规多轮对话需求,同时避免上下文过长导致 Token 消耗过高、响应变慢。
3.2 buildChatHistory 实现
编辑 AiChatServiceImpl.java,新增 buildChatHistory() 方法:
/**
 * 从 MySQL 中加载最近 N 条对话记录,构建 LangChain4j 消息上下文
 * <p>实现对话记忆功能,让 AI 能理解本轮对话的历史(最多保留最近 20 条消息)</p>
 */
private List<ChatMessage> buildChatHistory(Long conversationId) {
    LambdaQueryWrapper<Message> queryWrapper = new LambdaQueryWrapper<>();
    queryWrapper.eq(Message::getConversationId, conversationId)
            .orderByDesc(Message::getCreatedAt)
            .last("LIMIT 20");
    List<Message> historyMessages = messageMapper.selectList(queryWrapper);
    // 按时间正序排列(最早的在前面)
    Collections.reverse(historyMessages);

    List<ChatMessage> chatMessages = new ArrayList<>();
    for (Message msg : historyMessages) {
        if ("user".equals(msg.getRole())) {
            chatMessages.add(UserMessage.from(msg.getContent()));
        } else if ("assistant".equals(msg.getRole())) {
            chatMessages.add(AiMessage.from(msg.getContent()));
        }
    }
    return chatMessages;
}
关键设计决策:
| 决策 | 说明 |
|---|---|
| LIMIT 20 | 保留最近 20 条消息作为上下文窗口 |
orderByDesc + reverse | 先倒序取最新 N 条,再反转为正序(时间顺序) |
| 仅加载 user + assistant | 系统消息(如 system prompt)不参与历史对话 |
| 每次提问都重新加载 | 保证历史是最新的,不依赖内存缓存 |
3.3 在 chat() 非流式方法中也加入记忆
非流式 chat() 方法同样需要记忆功能,改造方式完全一致:
// chat() 方法中加入 buildChatHistory
List<ChatMessage> chatMessages = buildChatHistory(conversationId);
// ... 保存用户消息 ...
chatMessages.add(UserMessage.from(requestDTO.getContent()));
Response<AiMessage> response = chatModel.generate(chatMessages);
3.4 RAG 路径同步改造
RagChatServiceImpl 中的 chatWithContextStream() 和 chatWithContext() 也同步加入流式输出和 buildChatHistory() 记忆功能。RAG 路径的区别仅在于 RAG Prompt 包含了检索到的知识库文档作为参考上下文,但记忆机制完全相同。
四、前端改造:SSE 流解析与渲染
4.1 SSE 协议解析
后端通过 SSE(Server-Sent Events)推送事件,格式如下:
event: message
data: 根据

event: message
data: 您

event: message
data: 提供

event: done
data: {"conversationId":123,"content":"...","tokens":500}
前端使用 fetch + ReadableStream API 逐行解析 SSE 事件流。
4.2 ai.service.ts:流式请求 + Token 批处理
编辑 src/services/ai.service.ts。
4.2.1 Token 批处理回调
逐 token 更新 Zustand store 会导致页面频繁刷新、产生明显跳动。解决方案是 批处理缓冲:每 80ms 将缓冲区中的 tokens 合并为一批,一次性更新 UI。
/**
 * 流式输出批处理回调
 *
 * <p>每隔 flushInterval ms 将缓冲区中的 token 批量发送给 onMessage,
 * 而非每个 token 都触发一次回调,减少状态更新频率,避免页面跳动。</p>
 */
function createBatchedCallback(
  onMessage: (chunk: string) => void,
  flushInterval: number = 80,
): { addToken: (token: string) => void; flush: () => void } {
  let buffer: string[] = [];
  let timer: ReturnType<typeof setInterval> | null = null;

  const startTimer = () => {
    if (timer) return;
    timer = setInterval(() => {
      if (buffer.length > 0) {
        const batch = buffer.join('');
        buffer = [];
        onMessage(batch);
      }
    }, flushInterval);
  };

  return {
    addToken: (token: string) => {
      buffer.push(token);
      startTimer();
    },
    flush: () => {
      if (timer) {
        clearInterval(timer);
        timer = null;
      }
      if (buffer.length > 0) {
        const batch = buffer.join('');
        buffer = [];
        onMessage(batch);
      }
    },
  };
}
4.2.2 askStream 方法:SSE 流式对话
askStream: (
  data: AIRequest,
  onMessage: (message: string) => void,
  onDone?: (result: { conversationId: number | string;
      messageId: number | string; content: string; tokens: number }) => void,
  onError?: (error: string) => void,
) => {
  // 创建批处理回调:每 80ms 批量输出一次
  const { addToken, flush } = createBatchedCallback(onMessage, 80);

  return fetch(`${import.meta.env.VITE_API_BASE_URL}/ai/chat/stream`, {
    method: 'POST',
    headers: {
      'Content-Type': 'application/json',
      'Authorization': tokenStorage.getAuthorizationHeader(),
    },
    body: JSON.stringify({
      content: data.question,
      conversationId: data.conversationId,
      model: data.model,
      enableRag: data.context?.knowledgeBase === true,
    }),
  }).then(async (response) => {
    if (!response.ok) {
      throw new Error(`HTTP ${response.status}: ${response.statusText}`);
    }
    const reader = response.body?.getReader();
    const decoder = new TextDecoder();
    if (!reader) throw new Error('无法读取响应流');

    let buffer = '';
    let currentEvent = '';
    let messageLines: string[] = [];

    while (true) {
      const { done, value } = await reader.read();
      if (done) break;

      buffer += decoder.decode(value, { stream: true });
      const lines = buffer.split('\n');
      buffer = lines.pop() || '';  // 保留不完整的最后一行

      for (const line of lines) {
        // 解析 event: 行
        if (line.startsWith('event:')) {
          if (messageLines.length > 0) {
            addToken(messageLines.join('\n'));
            messageLines = [];
          }
          currentEvent = line.slice(6).trim();
          continue;
        }

        // 解析 data: 行
        if (line.startsWith('data:')) {
          const data = line.startsWith('data: ')
              ? line.slice(6) : line.slice(5);

          if (currentEvent === 'error') {
            flush();
            onError?.(data);
            continue;
          }

          if (currentEvent === 'done') {
            flush();
            try {
              const parsed = JSON.parse(data);
              onDone?.(parsed);
            } catch { /* done 事件数据非 JSON,忽略 */ }
            continue;
          }

          // message 事件:累积 data 行
          messageLines.push(data);
          continue;
        }

        // 空行 = SSE 事件边界
        if (line === '') {
          if (messageLines.length > 0) {
            addToken(messageLines.join('\n'));
            messageLines = [];
          }
          currentEvent = '';
        }
      }
    }

    // 流结束时发送残留数据
    if (messageLines.length > 0) {
      addToken(messageLines.join('\n'));
    }
    flush();
  });
},
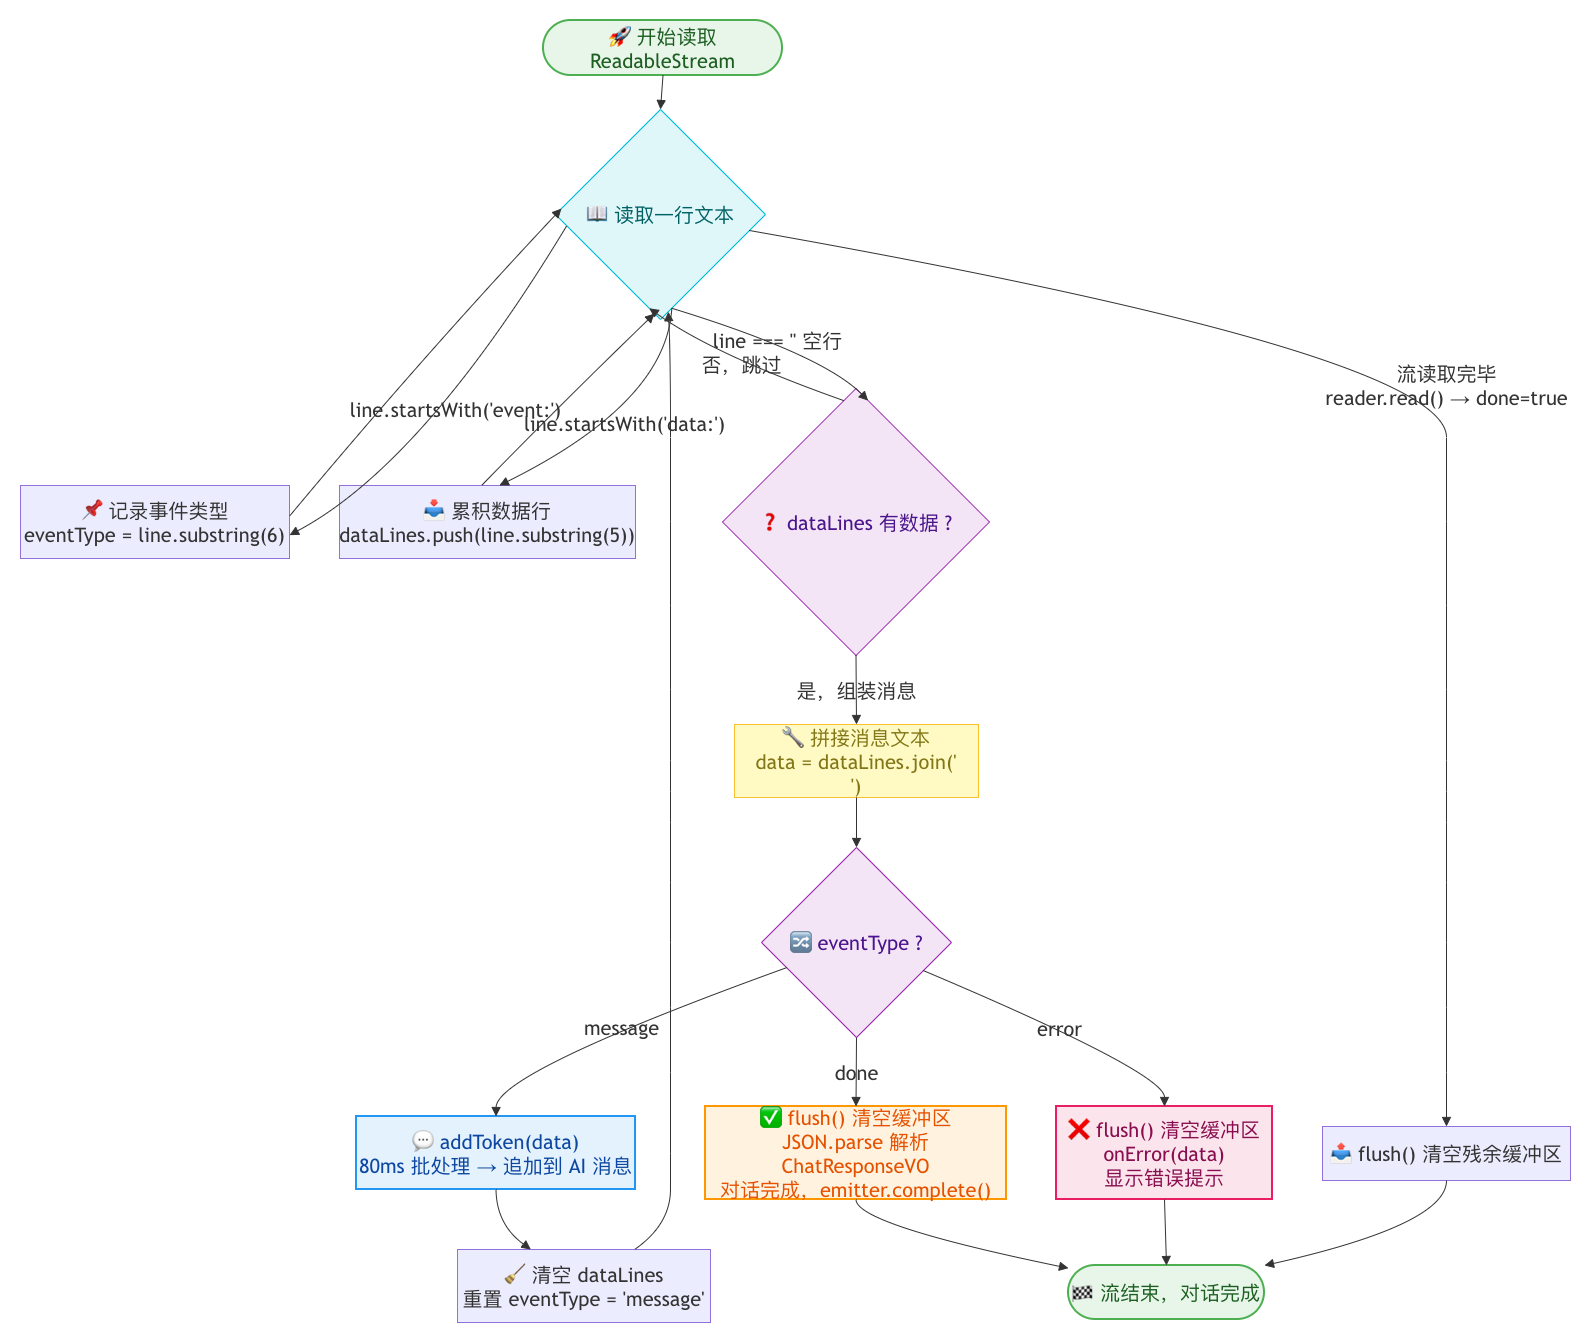
4.3 SSE 解析状态机
4.4 AIAssistantPage:滚动优化
流式输出时内容持续增长,如果每次新增内容都用 smooth 滚动(~300ms 动画),动画会被频繁打断产生剧烈跳动。解决方案是流式输出期间用 behavior: 'auto' 瞬时滚动,流结束后才用 smooth。
const scrollToBottom = () => {
  messagesEndRef.current?.scrollIntoView({
    behavior: isStreaming ? 'auto' : 'smooth',
  });
};
五、记忆功能的数据库表设计
对话记忆功能基于两张已有的 MySQL 表:
5.1 Conversation 表
CREATE TABLE `conversation` (
  `id` BIGINT NOT NULL COMMENT '对话ID',
  `title` VARCHAR(100) NOT NULL DEFAULT '新对话' COMMENT '对话标题',
  `user_id` BIGINT NOT NULL COMMENT '用户ID',
  `model` VARCHAR(50) DEFAULT NULL COMMENT '使用的模型名称',
  `system_prompt` TEXT COMMENT '系统提示词',
  `tokens_used` INT NOT NULL DEFAULT 0 COMMENT 'Token使用量',
  `message_count` INT NOT NULL DEFAULT 0 COMMENT '消息数量',
  `status` TINYINT NOT NULL DEFAULT 0 COMMENT '状态(0-进行中,1-已结束)',
  `created_at` DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,
  `updated_at` DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,
  `deleted` TINYINT NOT NULL DEFAULT 0 COMMENT '逻辑删除',
  PRIMARY KEY (`id`),
  KEY `idx_user_id` (`user_id`),
  KEY `idx_created_at` (`created_at`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='AI对话表';
5.2 Message 表
CREATE TABLE `message` (
  `id` BIGINT NOT NULL COMMENT '消息ID',
  `conversation_id` BIGINT NOT NULL COMMENT '所属对话ID',
  `role` VARCHAR(20) NOT NULL COMMENT '角色(user/assistant/system)',
  `content` LONGTEXT NOT NULL COMMENT '消息内容',
  `tokens` INT NOT NULL DEFAULT 0 COMMENT '估算Token数',
  `created_at` DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,
  `deleted` TINYINT NOT NULL DEFAULT 0 COMMENT '逻辑删除',
  PRIMARY KEY (`id`),
  KEY `idx_conversation_id` (`conversation_id`),
  KEY `idx_created_at` (`created_at`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='AI消息表';
5.3 ORM 实体类
Conversation 实体(kb-ai/.../entity/Conversation.java):
@Data
@Builder
@NoArgsConstructor
@AllArgsConstructor
@TableName("conversation")
public class Conversation {
    @TableId(value = "id", type = IdType.ASSIGN_ID)
    private Long id;
    @TableField("title")
    private String title;
    @TableField("user_id")
    private Long userId;
    @TableField("model")
    private String model;
    @TableField("system_prompt")
    private String systemPrompt;
    @TableField("tokens_used")
    private Integer tokensUsed;
    @TableField("message_count")
    private Integer messageCount;
    @TableField("status")
    private Integer status;
    @TableField(value = "created_at", fill = FieldFill.INSERT)
    private LocalDateTime createdAt;
    @TableField(value = "updated_at", fill = FieldFill.INSERT_UPDATE)
    private LocalDateTime updatedAt;
    @TableLogic
    @TableField("deleted")
    private Integer deleted;
}
Message 实体(kb-ai/.../entity/Message.java):
@Data
@Builder
@NoArgsConstructor
@AllArgsConstructor
@TableName("message")
public class Message {
    @TableId(value = "id", type = IdType.ASSIGN_ID)
    private Long id;
    @TableField("conversation_id")
    private Long conversationId;
    @TableField("role")
    private String role;       // user / assistant
    @TableField("content")
    private String content;
    @TableField("tokens")
    private Integer tokens;
    @TableField(value = "created_at", fill = FieldFill.INSERT)
    private LocalDateTime createdAt;
    @TableLogic
    @TableField("deleted")
    private Integer deleted;
}
六、测试
按顺序启动下面这些微服务:
kb-auth-user
kb-ai
kb-gateway
启动前端
cd knowledge-base-frontend
npm run dev
浏览器访问AI对话页面:
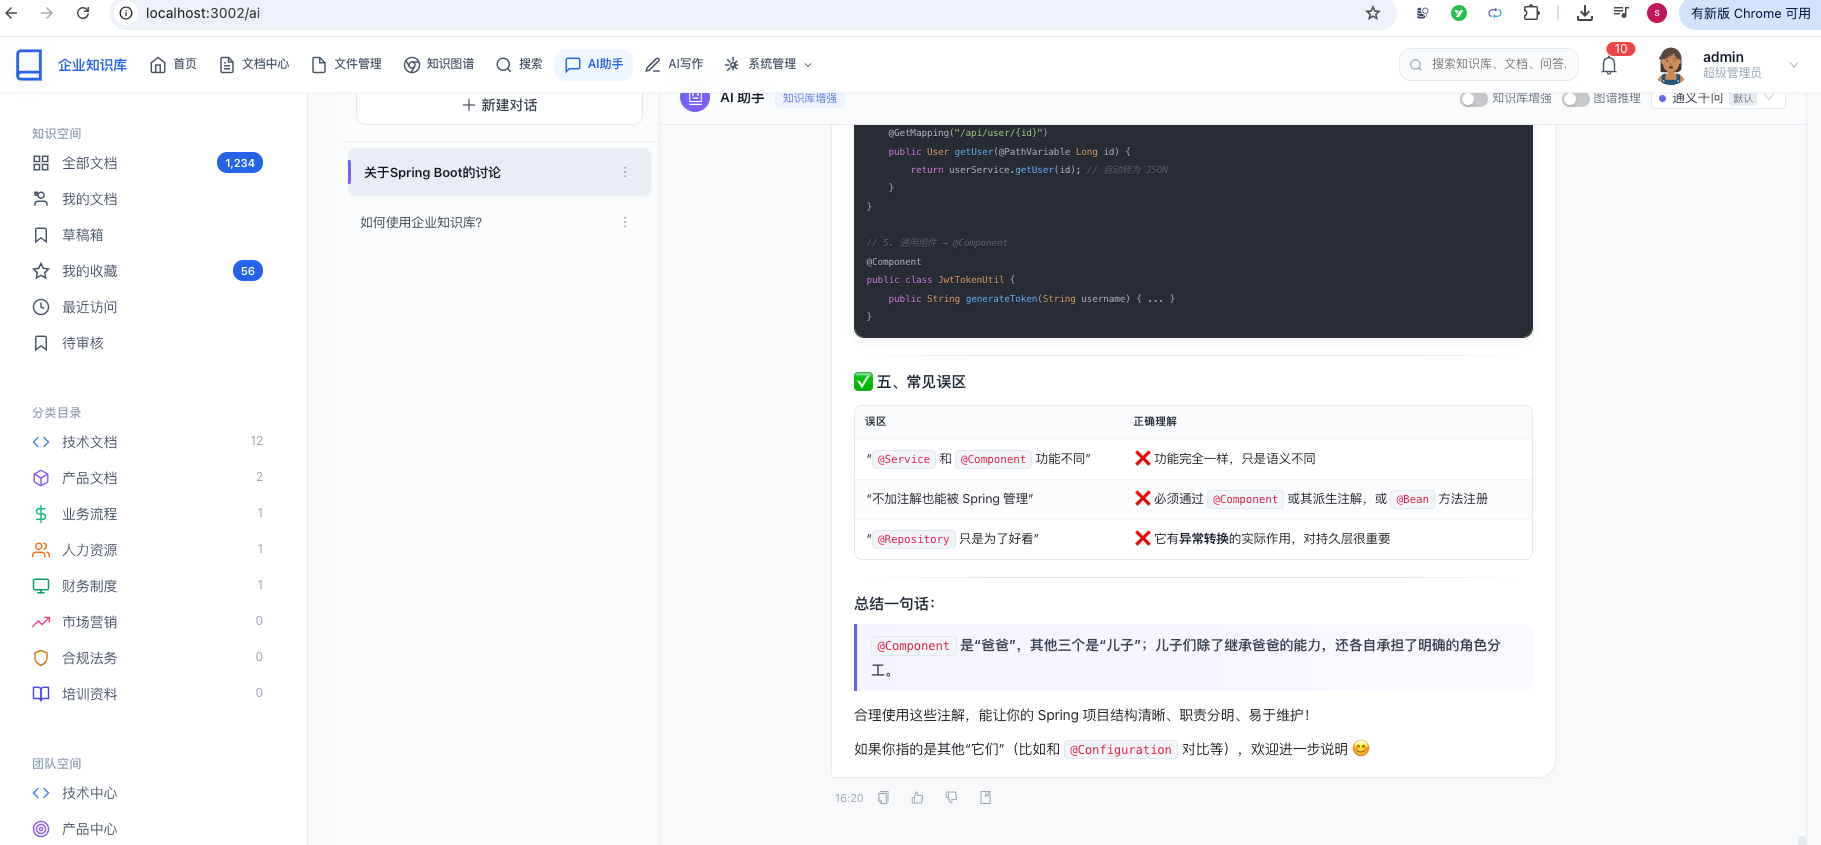
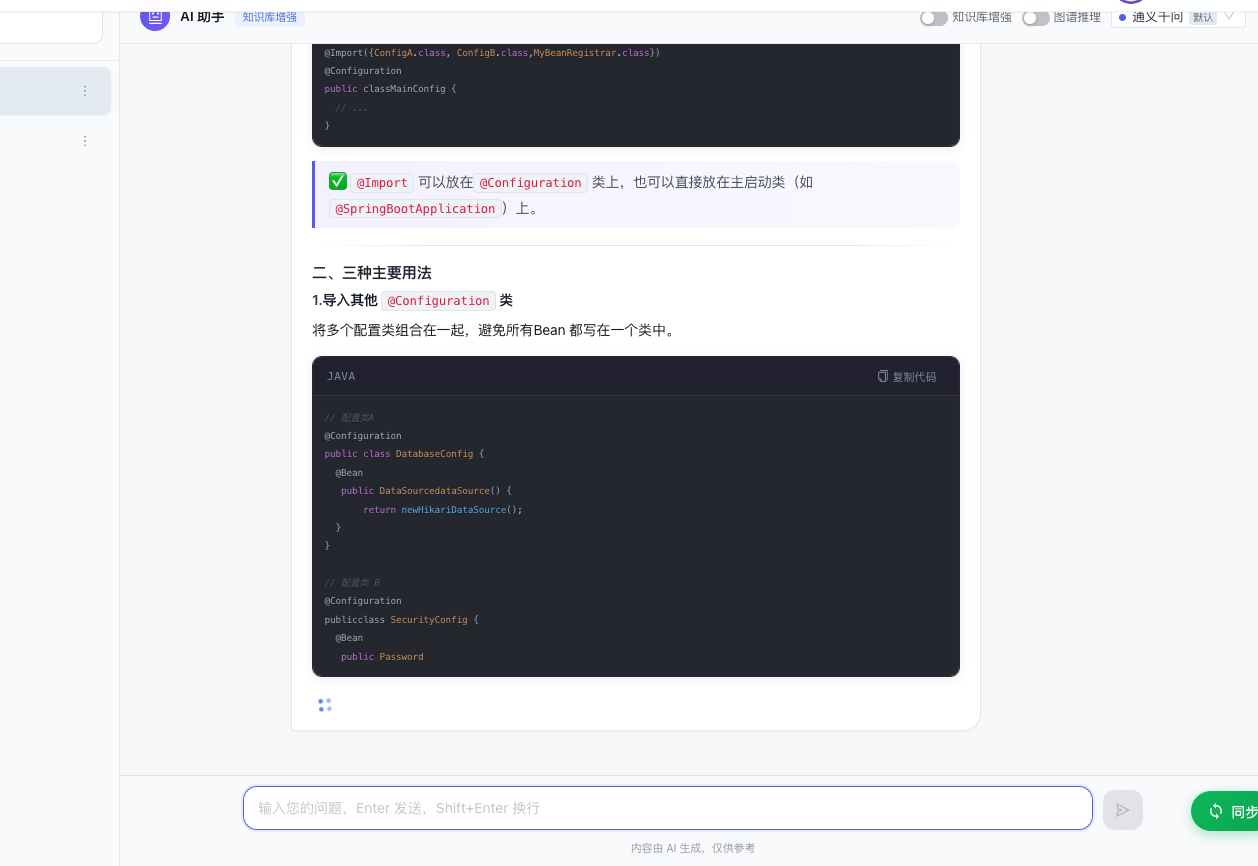
输入问题:@Import注解有什么用途?
它会流式输出内容,响应速度还是比较快的。
再问一下带记忆的上下文关联的问题:
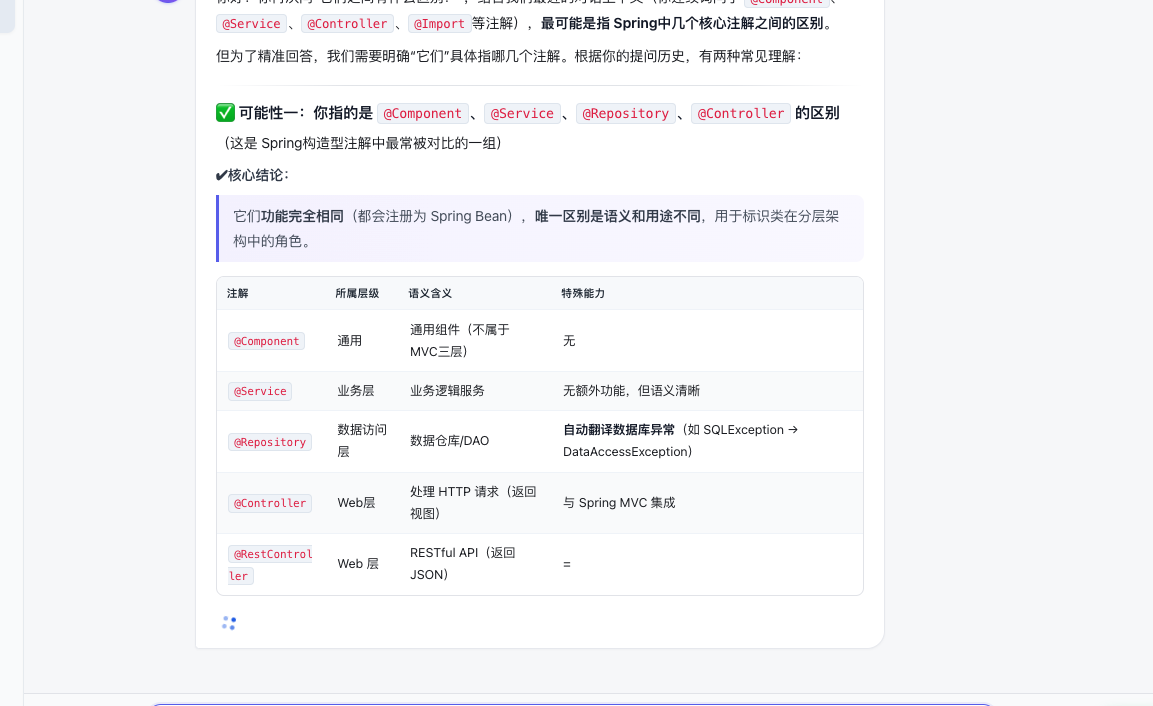
也可以回答上了。
总结
本文详细介绍了 AI 对话流式输出和记忆功能的完整改造方案,涵盖了以下核心内容:
改造清单
| 改造项 | 实现方式 | 说明 |
|---|---|---|
| 流式模型 | OpenAiStreamingChatModel | LangChain4j 流式接口,与阻塞式共用参数 |
| SSE 推送 | SseEmitter + StreamingResponseHandler | Spring MVC 原生 SSE 支持 |
| 异步执行 | CompletableFuture.runAsync | 避免阻塞 Tomcat 线程 |
| 前端解析 | fetch + ReadableStream | 逐行解析 SSE 事件流 |
| Token 批处理 | createBatchedCallback(80ms) | 减少 Zustand 更新频率 |
| 滚动优化 | behavior: 'auto' | 流式期间瞬时滚动 |
| 对话记忆 | buildChatHistory() | MySQL 最近 20 条消息 |
| 记忆持久化 | Message 表 | 每次对话自动存储 |
| RAG 流式 | RagChatServiceImpl.chatWithContextStream | 知识库路径同步流式化 |
技术要点
- 流式模型与阻塞式模型用同一套 API 参数:
buildStreamingModel与buildModel参数完全一致,仅类型不同 - SSE 三大事件:
message(token 推送)、done(完成通知)、error(错误通知) - 前端 SSE 解析:逐行读取
ReadableStream,按event:/data:/ 空行 三种行类型分别处理 - 批处理优化:80ms 窗口批量输出 tokens,平衡实时性与性能
- 记忆窗口:
LIMIT 20+orderByDesc+reverse,取出最近 20 条并按时间正序排列 - 优雅降级:RAG 异常时自动回退到普通流式对话
通过本文的学习,你应该能够掌握:
- LangChain4j
StreamingChatLanguageModel的使用方法和StreamingResponseHandler回调机制 - Spring MVC
SseEmitter实现 SSE 服务器推送的完整流程 - 前端
ReadableStreamAPI 解析 SSE 事件流的技术细节 - 通过 MySQL 消息表实现 AI 对话记忆功能的架构设计
- Token 批处理、滚动优化等前端性能调优技巧
祝你开发顺利!
