一、功能概述
系统上线前做健康度巡检时,日志这一块的问题最扎眼:
=== 全仓库搜索日志配置文件 ===
find . -name "logback*.xml" -o -name "log4j2*.xml"
(改造前:0 个结果)

=== 各服务 application.yml 的 logging 段 ===
kb-gateway:   logging.level + logging.pattern.console
kb-document:  logging.level + logging.pattern.console
kb-user-auth: logging.level + logging.pattern.console
kb-search:    logging.level + logging.pattern.console
... (9 个服务全是如此)换句话说:9 个微服务的日志全部只打到控制台。这带来三个直接后果:
| 问题 | 后果 |
|---|---|
| 日志不落盘 | 进程一重启(发版、崩溃、OOM)日志就没了,事故复盘无据可查 |
| 无滚动归档 | 就算重定向到文件,也会被单个文件撑爆磁盘,且无法按天检索 |
| 错误不分离 | ERROR 淹没在 INFO 里,出问题要 grep 整个大文件 |
本次改造的目标:让日志可归档、可检索、可关联、不拖慢业务,且不增加任何业务代码侵入。
功能特性
- 多目标输出:控制台(开发友好)+ 全量文件 + 错误文件(ERROR 独立成文件)
- 自动滚动:按天 + 按文件大小双维度滚动,历史文件 gzip 压缩,自动清理过期
- 异步写入:文件 Appender 走
AsyncAppender,磁盘 I/O 不阻塞业务线程 - 统一格式:所有服务一套格式,字段固定,便于
grep与日志采集 - 链路关联:每行日志带
[TID:xxx],一次请求跨服务共用同一个 ID(详见第六节) - 零侵入:业务代码一行不改,配置放公共模块,全服务生效
二、技术栈
项目本身基于 Spring Boot 3.2,日志门面/实现是 Spring Boot 默认的 SLF4J + Logback,因此不引入任何新依赖,只补配置文件。
| 组件 | 选型 | 说明 |
|---|---|---|
| 日志门面 | SLF4J 2.x | Spring Boot 3.2 默认 |
| 日志实现 | Logback 1.4.x | Spring Boot 默认,无需额外引入 |
| 配置方式 | logback-spring.xml | 支持 springProperty / springProfile 等 Spring 扩展 |
| 滚动策略 | SizeAndTimeBasedRollingPolicy | 时间 + 大小双维度滚动 |
| 异步写入 | AsyncAppender | Logback 内置,无需 Disruptor |
| 上下文传递 | SLF4J MDC | 把 traceId 放进 MDC,日志模板 %X{tid} 自动渲染 |
选 Logback 而不是 Log4j2 的原因:Spring Boot 默认就是 Logback,替换实现会牵动 spring-boot-starter-logging 的排除关系,收益(吞吐)远小于改造成本与风险。用默认实现 + 正确配置就够了。三、整体架构
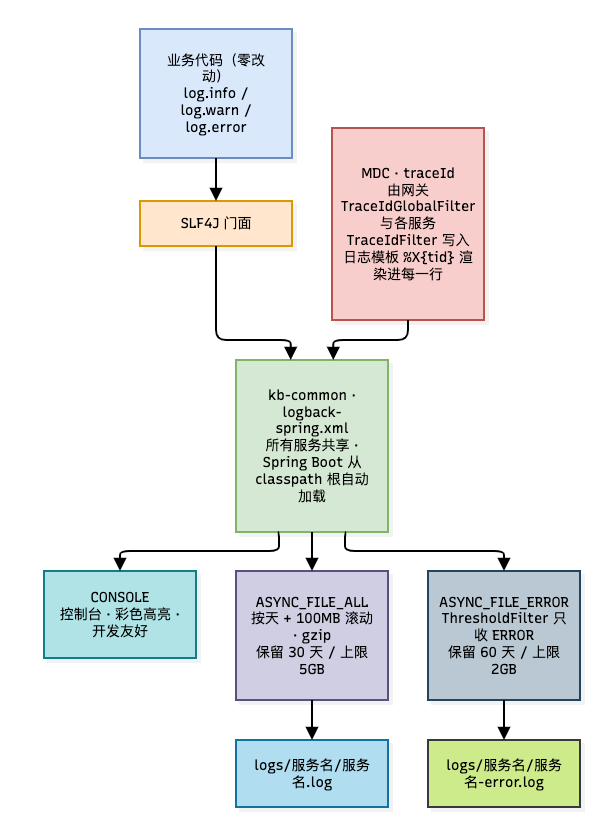
为什么不每个服务写一份?
11 个服务各写一份 logback-spring.xml 的直接问题是:格式漂移。今天 A 服务加了 %X{tid},明天 B 服务忘了加,事后按日志排查就会发现两个服务的日志字段对不上。
把所有服务都依赖的 kb-common 作为配置载体,能做到:
- 一处修改,全服务生效 —— 格式、滚动策略、保留策略永远一致;
- 可单独覆盖 —— 某个服务有特殊需求(比如 AI 服务要 TRACE 级别),只要在自己模块的
resources下再放一份同名文件即可覆盖; - 配置与业务解耦 —— 日志是横切关注点,天然属于公共模块。
这一点与项目的 Gateway 路由、统一响应、JWT 校验放在kb-common/kb-gateway是同一个思路。
四、方案选型与关键决策
4.1 为什么用 SizeAndTimeBasedRollingPolicy 而不是 TimeBasedRollingPolicy
| 策略 | 问题 |
|---|---|
| 只按时间 | 批量导入等场景下,单日日志可能涨到几个 G,一天的切片仍然过大,打开和检索都难受 |
| 只按大小 | 无法按天归档,跨天文件混在一起,定位不到"昨天几点出的问题" |
| 时间 + 大小 | 每天一个切片,且超过 100MB 立即切分(%i 序号),兼顾归档与单文件可读性 |
配置里对应:
<fileNamePattern>${LOG_PATH}/${APP_NAME}/${APP_NAME}.%d{yyyy-MM-dd}.%i.log.gz</fileNamePattern>
<maxFileSize>100MB</maxFileSize>
4.2 为什么错误日志要单独一个文件
线上排障的典型动作是「打开最近一段时间的 ERROR」,而不是「打开最近一段时间的全部日志」。多一个 -error.log(ThresholdFilter 只收 ERROR)的好处:
- 排障路径最短:出故障时先 tail 错误文件,不用在几十万行 INFO 里捞;
- 保留更久:错误文件保留 60 天、上限 2GB;全量文件保留 30 天、上限 5GB —— 错误日志量小但价值高,值得存更久;
- 便于告警接入:监控可以直接盯错误文件或按 ERROR 计数告警。
4.3 为什么文件写入一定要走 AsyncAppender
同步写文件意味着业务线程要等磁盘 I/O。磁盘抖动(尤其是容器里挂载的网络盘)时,一次日志写入可能阻塞几十毫秒,直接体现在接口 RT 上。
AsyncAppender 把日志丢进内存队列由后台线程写:
<appender name="ASYNC_FILE_ALL" class="ch.qos.logback.classic.AsyncAppender">
    <appender-ref ref="FILE_ALL"/>
    <queueSize>4096</queueSize>
    <discardingThreshold>0</discardingThreshold>
    <neverBlock>true</neverBlock>
</appender>三个参数都是刻意选的:
| 参数 | 取值 | 为什么 |
|---|---|---|
queueSize | 4096 | 队列容量。按每条日志约 200 字节估算,最多占用约 800KB 内存,可接受 |
discardingThreshold | 0 | 默认值 20% 表示"队列快满时丢弃低级别日志"。设为 0 = 任何级别都不主动丢,代价是队列满时依赖 neverBlock 策略 |
neverBlock | true | 队列满时丢弃日志而不是阻塞业务线程。宁可丢日志,不可拖垮业务 |
discardingThreshold=0+neverBlock=true的组合语义是:正常情况一条不丢;极端情况(队列打满)宁可丢日志也不拖慢业务。这是「可用性 > 完整性」的取舍 —— 日志丢一条不影响业务,但接口卡一下可能引发雪崩。
4.4 控制台与文件为什么用不同格式
<!-- 控制台:带颜色,级别高亮 -->
%d{yyyy-MM-dd HH:mm:ss.SSS} %highlight(%-5level) [%thread] [TID:%X{tid:-}] %cyan(%logger{40}) - %msg%n

<!-- 文件:纯文本,便于 grep / ELK 采集 -->
%d{yyyy-MM-dd HH:mm:ss.SSS} [%thread] %-5level [TID:%X{tid:-}] %logger{50} - %msg%n
控制台是给人看的(高亮级别能一眼找到 ERROR),文件是给机器和 grep 看的(颜色码会污染检索结果)。
五、核心实现
5.1 唯一新增的文件:kb-common/src/main/resources/logback-spring.xml
整个改造只新增了一个配置文件,无 Java 代码侵入。核心内容:
<configuration scan="false">

    <!-- 从 Spring 环境读取变量:应用名用于日志目录,log.path 可被 yml/启动参数覆盖 -->
    <springProperty scope="context" name="APP_NAME" source="spring.application.name" defaultValue="knowledge-base"/>
    <springProperty scope="context" name="LOG_PATH" source="logging.file.path" defaultValue="logs"/>

    <!-- 全量文件:按天 + 100MB 滚动,gzip 压缩,保留 30 天 / 上限 5GB -->
    <appender name="FILE_ALL" class="ch.qos.logback.core.rolling.RollingFileAppender">
        <file>${LOG_PATH}/${APP_NAME}/${APP_NAME}.log</file>
        <rollingPolicy class="ch.qos.logback.core.rolling.SizeAndTimeBasedRollingPolicy">
            <fileNamePattern>${LOG_PATH}/${APP_NAME}/${APP_NAME}.%d{yyyy-MM-dd}.%i.log.gz</fileNamePattern>
            <maxFileSize>100MB</maxFileSize>
            <maxHistory>30</maxHistory>
            <totalSizeCap>5GB</totalSizeCap>
            <cleanHistoryOnStart>true</cleanHistoryOnStart>
        </rollingPolicy>
        <encoder>
            <pattern>${LOG_PATTERN_FILE}</pattern>
            <charset>UTF-8</charset>
        </encoder>
    </appender>
    <!-- 错误文件:ThresholdFilter 只收 ERROR 及以上,保留 60 天 / 上限 2GB -->
    <appender name="FILE_ERROR" class="ch.qos.logback.core.rolling.RollingFileAppender">
        <file>${LOG_PATH}/${APP_NAME}/${APP_NAME}-error.log</file>
        <filter class="ch.qos.logback.classic.filter.ThresholdFilter">
            <level>ERROR</level>
        </filter>
        ...
    </appender>
</configuration>
几个容易被忽略但很关键的配置:
| 配置 | 作用 |
|---|---|
springProperty + defaultValue | 让 APP_NAME / LOG_PATH 既可由 Spring 环境注入,又有安全默认值。APP_NAME 取 spring.application.name,所以日志目录天然按服务名隔离 |
<charset>UTF-8</charset> | 不显式指定时,中文日志在部分环境下会乱码 |
maxHistory / totalSizeCap | 双保险:既限制保留天数,也限制总占用,防止「日志把磁盘写满」这类低级事故 |
cleanHistoryOnStart=true | 服务启动时清理过期历史,避免长期不重启的服务永远不清理 |
5.2 分环境:开发与生产用不同 Appender
<!-- 开发/测试:控制台 + 文件 -->
<springProfile name="!prod">
    <root level="INFO">
        <appender-ref ref="CONSOLE"/>
        <appender-ref ref="ASYNC_FILE_ALL"/>
        <appender-ref ref="ASYNC_FILE_ERROR"/>
    </root>
</springProfile>
<!-- 生产:在上面基础上,追加 SkyWalking 日志上报(下一篇详述) -->
<springProfile name="prod">
    <appender name="GRPC_LOG" class="org.apache.skywalking.apm.toolkit.log.logback.v1.x.log.GRPCLogClientAppender">...</appender>
    <root level="INFO">
        <appender-ref ref="CONSOLE"/>
        <appender-ref ref="ASYNC_FILE_ALL"/>
        <appender-ref ref="ASYNC_FILE_ERROR"/>
        <appender-ref ref="GRPC_LOG"/>
    </root>
</springProfile>
GRPC_LOG 只在 prod 启用,是为了避免本地开发时因为没有 OAP 而刷一堆连接错误 —— 这一点在下一篇《增加 SkyWalking 分布式链路跟踪》里展开。
5.3 日志级别:仍然交给各服务的 application.yml
日志格式与落地策略统一收在 logback 配置里,但日志级别保留在各服务自己的 yml,因为不同服务的关注点不同(AI 服务要 DEBUG 看模型调用,基础服务 INFO 就够):
# kb-ai —— 需要观察大模型交互
logging:
  level:
    com.knowledge.base.ai: DEBUG
    dev.langchain4j: DEBUG

# kb-gateway —— 需要观察路由
logging:
  level:
    root: INFO
    com.knowledge.base: DEBUG
org.springframework.cloud.gateway: DEBUG这里有个容易搞混的点:yml 里的logging.level.*优先级高于logback-spring.xml里写的<root level>。Spring Boot 加载完 XML 后会再用 yml 的级别覆盖一遍。所以「格式用 XML、级别用 yml」是可行且推荐的组合。
5.4 异步任务的日志也不能丢
文件 I/O 异步了,但业务异步线程的 MDC 不会自动传递 —— 线程池里 async-task-1 线程打出的日志,%X{tid} 是空的,链路直接断在异步边界上。
kb-common 里补了 MdcTaskDecorator,在任务提交时快照 MDC、执行前恢复、执行后清理:
public class MdcTaskDecorator implements TaskDecorator {
    @Override
    public Runnable decorate(Runnable runnable) {
        Map<String, String> contextMap = MDC.getCopyOfContextMap(); // 提交时快照
        return () -> {
            if (contextMap != null) MDC.setContextMap(contextMap);   // 执行前恢复
            try {
                runnable.run();
            } finally {
                MDC.clear();                                        // 线程复用必须清理
            }
        };
    }
}
并挂到异步线程池上:
executor.setTaskDecorator(new MdcTaskDecorator());**为什么 finally 里一定要 **MDC.clear():线程池的线程是复用的,如果不清理,A 请求的 traceId 会残留在 async-task-1 线程上,被 B 请求的异步任务捞到,日志就会出现「张冠李戴」 —— 这比没有 traceId 更难排查。
补充说明:MdcTaskDecorator只对请求触发的异步任务有意义。项目里还有一类跑在同一个线程池上的定时任务(如CategoryDocCountTask计算分类文档数),它们没有发起请求,日志的[TID:]就该是空的 —— 这一点在 9.4 有实测印证。
六、日志如何串联一次请求(端到端)
日志乱在「一次请求的日志散落在多个服务、多个线程」,所以每行日志必须带一个一致的请求标识。这里的字段是 tid(trace id)。
6.1 链路流转
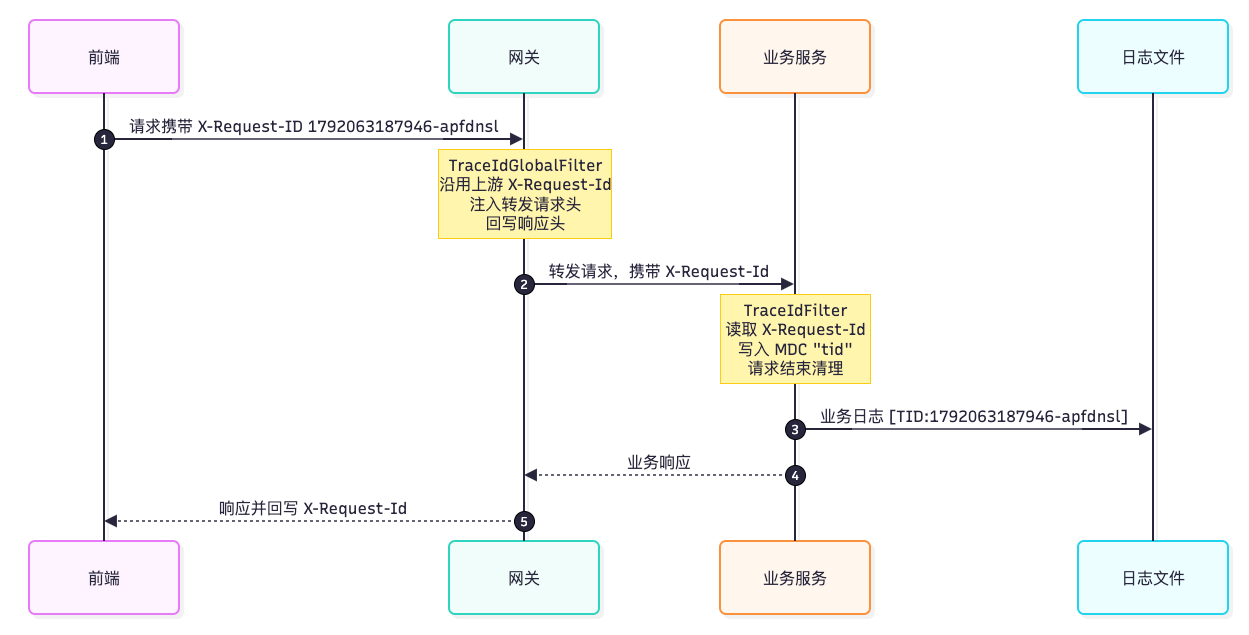
6.2 traceId 的取值优先级
// TraceIdUtil.resolveTraceId
// 1) SkyWalking Agent 的 traceId(挂了 Agent 且被采样时,与 UI 上的链路 ID 一致)
// 2) 上游透传的 X-Request-Id(前端 / 网关分配)
// 3) 都没有 -> 本地生成 UUID
为什么要这个顺序?因为 Agent 可能没挂(本地开发、CI、单测)。SkyWalking 在无链路上下文时会返回 N/A 或 Ignored_Trace 这类占位值,如果直接写进 MDC,日志里就是一片 [TID:N/A],等于没做。所以 TraceIdUtil.isValid() 会把这些占位值判为无效并回退。
6.3 实证:前端 -> 网关 -> 服务,同一个 TID
前端在 axios 请求拦截器里给每个请求生成追踪 ID:
// knowledge-base-frontend/src/services/request.ts
function generateRequestId(): string {
  return `${Date.now()}-${Math.random().toString(36).substring(2, 9)}`;
}
config.headers['X-Request-ID'] = generateRequestId();于是同一个请求在网关和文档服务里的日志如下(真实运行日志):
# 网关
2026-10-15 19:19:50.938 [parallel-4] INFO  [TID:1792063187946-apfdnsl] c.k.base.gateway.filter.GlobalLogFilter - [1792063187946-apfdnsl] 请求 => Method: GET, URI: http://localhost:8080/api/document/categories/children/0, ...

# 文档服务
2026-10-15 19:19:53.605 [http-nio-8082-exec-1] DEBUG [TID:1792063187946-apfdnsl] c.k.base.document.filter.JwtAuthenticationFilter - JwtAuthenticationFilter: URI=/categories/children/0, Method=GET
2026-10-15 19:19:55.000 [http-nio-8082-exec-1] INFO  [TID:1792063187946-apfdnsl] c.k.base.document.filter.JwtAuthenticationFilter - Token解析成功: userId=1000000000000000001, uri=/categories/children/0
两条日志的 TID 完全一致,上面那个 ID 拿去 grep,就能把这次请求经过的网关、文档服务日志全部串起来:
grep "1792063187946-apfdnsl" logs/*/*.log再看一个回退场景:WebSocket 请求不是 axios 发的,没有 X-Request-ID,于是网关侧自动生成了 UUID:
2026-10-15 19:19:52.110 [parallel-3] INFO [TID:438ab489edc34c25bcf94974dc8ac12b] c.k.base.gateway.filter.GlobalLogFilter - [438ab489edc34c25bcf94974dc8ac12b] 请求 => Method: GET, URI: http://localhost:8080/ws/notification/info?...这正好印证了 6.2 的优先级链:有上游就沿用,没有就自己生成,日志永远有可用的追踪 ID。
七、接入方式:其他服务需要做什么
什么都不用做。因为配置放在所有服务都依赖的 kb-common 的 resources 根目录,Spring Boot 会从 classpath 根自动加载。
验证一下「一处配置、全服务生效」:
# 全仓库只有 1 个 logback 配置文件
$ find . -name "logback*.xml" -not -path "*/target/*" | wc -l
1

# 但多个服务都在按各自服务名输出日志文件
$ ls logs/
kb-document/ kb-foundation/ kb-gateway/ kb-user-auth/如果某个服务想覆盖(例如只输出到文件、不要控制台),只需在它自己的 src/main/resources/ 下放一份 logback-spring.xml,由于 classpath 加载顺序,模块内的配置会优先生效。
八、配置说明
| 配置项 | 默认值 | 说明 |
|---|---|---|
logging.file.path | logs | 日志根目录,最终路径为 ${path}/${spring.application.name}/ |
logging.level.root | INFO | 全局级别(覆盖 logback 中的 <root level>) |
logging.level.com.knowledge.base | 各服务自定 | 业务包级别,多数服务为 DEBUG |
覆盖方式(优先级从高到低):
# 1) 启动参数
java -jar app.jar --logging.file.path=/data/logs/knowledge-base

# 2) 环境变量(Spring Boot 松散绑定)
export LOGGING_FILE_PATH=/data/logs/knowledge-base

# 3) application.yml
logging:
  file:
    path: /data/logs/knowledge-base
日志文件命名规则:
logs/<服务名>/<服务名>.log                   # 全量
logs/<服务名>/<服务名>-error.log             # 仅 ERROR
logs/<服务名>/<服务名>.2026-10-15.0.log.gz   # 滚动后的历史文件(gzip)
九、测试验证
9.1 文件是否真的落盘、目录是否按服务名隔离
$ ls -lh logs/*/*.log
-rw-r--r--  1 mac  staff    76K  logs/kb-document/kb-document.log
-rw-r--r--  1 mac  staff    30K  logs/kb-foundation/kb-foundation.log
-rw-r--r--  1 mac  staff   277K  logs/kb-gateway/kb-gateway.log
-rw-r--r--  1 mac  staff    45K  logs/kb-user-auth/kb-user-auth.log
9.2 格式是否统一、字段是否齐全
$ head -3 logs/kb-document/kb-document.log
2026-10-15 19:15:43.964 [background-preinit] INFO  [TID:] org.hibernate.validator.internal.util.Version - HV000001: Hibernate Validator 8.0.1.Final
2026-10-15 19:15:44.650 [main] INFO  [TID:] com.knowledge.base.document.DocumentApplication - Starting DocumentApplication using Java 21.0.6 with PID 82794 ...
2026-10-15 19:15:44.652 [main] DEBUG [TID:] com.knowledge.base.document.DocumentApplication - Running with Spring Boot v3.2.0, Spring v6.1.1时间戳(毫秒)、线程名、级别、[TID:...]、类名、消息 —— 字段顺序全服务一致。
9.3 错误日志是否真的只收 ERROR
$ wc -l logs/*/*-error.log
       0 logs/kb-document/kb-document-error.log
       0 logs/kb-foundation/kb-foundation-error.log
     326 logs/kb-gateway/kb-gateway-error.log     <-- 网关启动阶段确有 ERROR
       0 logs/kb-user-auth/kb-user-auth-error.log
文档/基础/认证服务的错误文件为 0 行(期间没有 ERROR),网关有 326 行(启动阶段有真实错误)—— 说明 ThresholdFilter 的分级隔离按预期工作。
9.4 线程分布:请求线程有 traceId,定时任务线程没有(这是对的)
$ awk '{print $3}' logs/kb-document/kb-document.log | sort | uniq -c | sort -rn
  204 =
  110 [scheduling-1]
  110 [async-task-1]
   96 [main]
12 [http-nio-8082-exec-1]这里有个容易误判的点,特意验证了一下:
# 带 traceId 的日志全部来自请求处理线程
$ grep "\[TID:[0-9a-f]" logs/kb-document/kb-document.log | sed -E 's/.*(\[[^]]+\]) \[TID.*/\1/' | sort -u
[http-nio-8082-exec-1]

# 异步/定时任务线程的日志,TID 为空
$ grep -h "\[async-task-1\]" logs/kb-document/kb-document.log | head -1
2026-10-15 19:16:36.911 [async-task-1] INFO  [TID:] ... CategoryDocCountTask - 定时任务:开始重新计算分类文档数量
$ grep -h "\[async-task-1\]" logs/kb-document/kb-document.log | grep -c "\[TID:[0-9a-f]"
0
这不是 bug:这批 [async-task-1] 日志来自定时任务(CategoryDocCountTask 计算分类文档数),定时任务没有"发起它的请求",自然没有 traceId —— 如果强行编一个,反而会污染链路。
MdcTaskDecorator(见 5.4)解决的是另一类场景:由 HTTP 请求触发的异步任务(例如"浏览文档后异步记录访问记录")。这类任务有明确的归属请求,必须继承该请求的 traceId,否则链路会在业务入口处断开。本次采样窗口内没有触发这类日志,因此无法从现有日志直接举证,机制由代码保证。
9.5 按 traceId 串一次请求
$ grep "1792063187946-apfdnsl" logs/*/*.log
logs/kb-gateway/kb-gateway.log:... [TID:1792063187946-apfdnsl] ... 请求 => Method: GET, URI: .../api/document/categories/children/0
logs/kb-document/kb-document.log:... [TID:1792063187946-apfdnsl] ... Token解析成功: userId=1000000000000000001
总结
这次改造解决了什么
| 改造前 | 改造后 |
|---|---|
| 只有控制台输出,重启即丢 | 按天 + 大小滚动落盘,gzip 归档,自动清理 |
| 错误混在 INFO 里 | ERROR 独立文件,保留更久,便于告警 |
| 同步写日志,可能拖慢接口 | AsyncAppender 异步写入,不阻塞业务线程 |
| 各服务格式不一 | 一套配置全服务生效,字段完全一致 |
| 一次请求的日志散落各处 | 每行带 [TID:xxx],一个 ID 串起全链路 |
几个关键落点
- 配置放公共模块 —— 用「classpath 根 + springProperty」实现「一处配置、全服务生效、单服务可覆盖」,零业务侵入。
- 异步是双刃剑,要显式取舍 ——
neverBlock=true保证不拖慢业务,但要知道极端情况下会丢日志;审计类日志走数据库而不是文件。 - MDC 是链路的地基,但必须清理 —— 请求结束清理、异步任务
finally清理,否则 traceId 会在线程池里串号,制造更隐蔽的问题。 - 格式统一比格式漂亮更重要 —— 多个服务用同一套字段顺序,才能一条
grep捞穿全链路。 - 可观测的链路是分层的 —— 本篇解决「日志落盘 + 请求关联」;
- 下一步的跨服务调用拓扑、慢 SQL、慢接口需要 APM,也就是下一篇《增加 SkyWalking 分布式链路跟踪》的内容。
