1. 系统概述
1.1 项目背景
企业智能知识库系统 Python 版是一套功能与 Java 版完全对等的全栈知识管理平台。
两者的数据库 Schema、REST API 接口、前端代码完全一致,唯一的差异在于后端实现语言与框架生态。
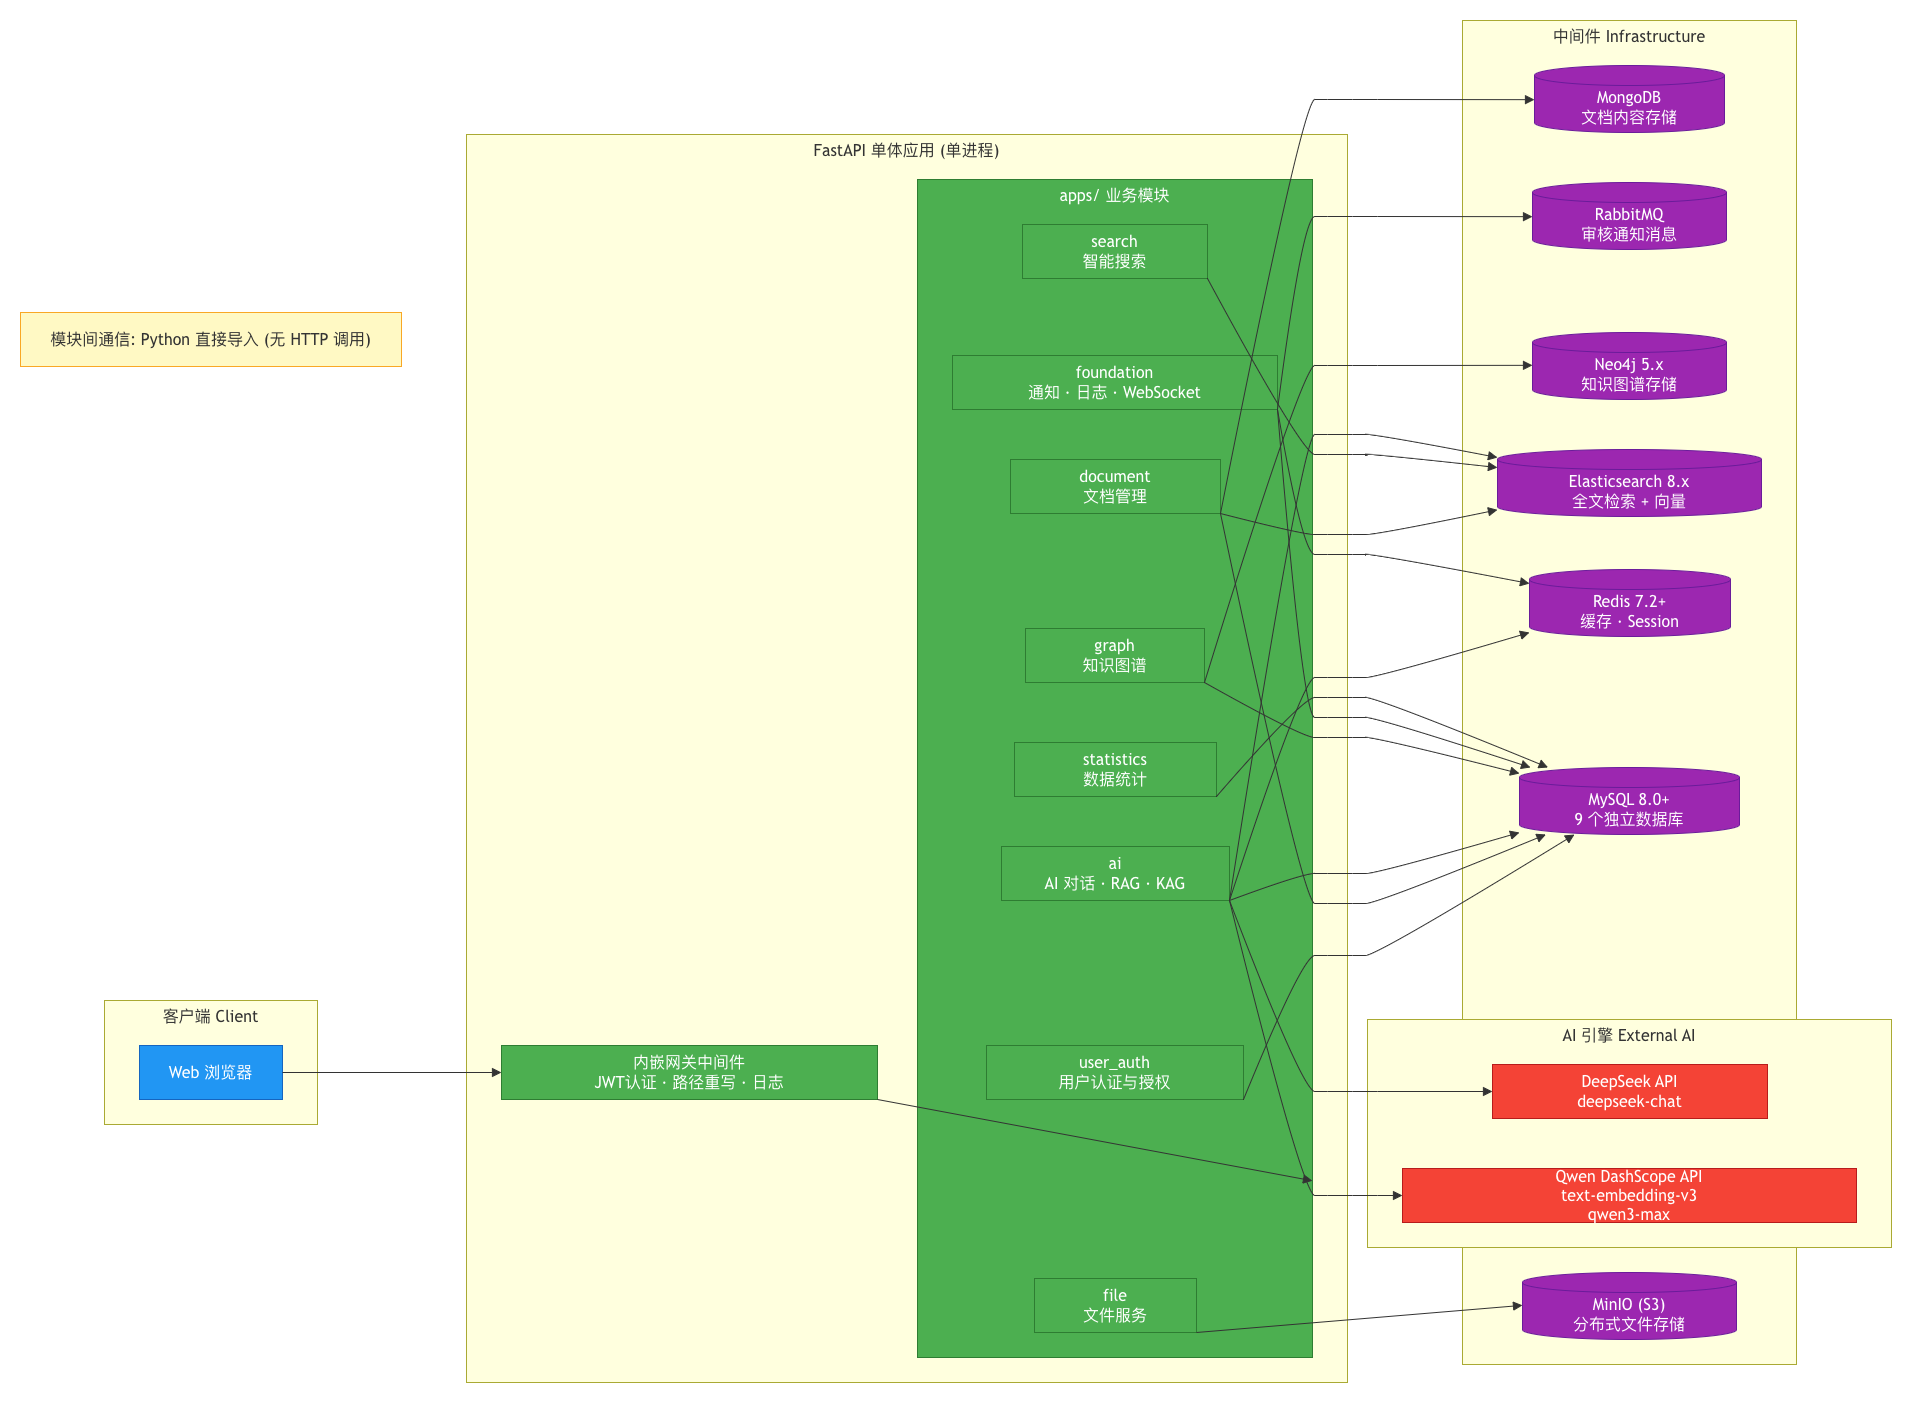
与 Java 版的微服务架构不同,Python 版采用单体应用架构:所有功能模块(用户认证、文档管理、搜索、文件、AI、图谱、统计等)运行在同一个 FastAPI 进程中,通过 Python 包导入直接通信,避免了微服务间的 HTTP 调用开销。模块间使用 apps/ 目录组织,common/ 包提供共享基础设施。
Python 版面向以下场景:
- 团队技术栈以 Python 为主,引入 Java 的学习和维护成本过高
- 需要深入定制 AI / RAG 工作流,Python 生态(LangChain、HuggingFace)是 LLM 开发的事实标准
- 中小规模部署,单体架构降低运维复杂度
1.2 核心能力矩阵
| 能力域 | 功能 | 技术支撑 |
|---|---|---|
| 文档管理 | 富文本/Markdown 编辑、多层级分类、标签、版本管理、审核工作流 | MySQL + MongoDB + RustFS |
| 智能搜索 | 全文检索、混合检索(BM25+向量)、重排序 | Elasticsearch |
| AI 助手 | 多模型对话、智能写作、RAG 知识增强回答 | LangChain + OpenAI-Compatible SDK |
| 知识图谱 | 实体抽取、关系构建、图遍历检索、KAG 融合推断 | Neo4j + LangChain Graph |
| 协作审核 | 提交审核 → 审批通过/驳回 → 状态流转 → 通知推送 | FastAPI Users RBAC + WebSocket |
| 统计分析 | 文档趋势、用户活跃度、热度排行、操作日志 | Celery 事件驱动 + 跨库视图 |
| 实时通知 | WebSocket 推送 + 站内通知 + 模板化消息 | FastAPI WebSocket + Celery |
| 权限管控 | RBAC 角色权限 + 数据级访问控制 | FastAPI Users + JWT |
1.3 与 Java 版的关系
| 维度 | Java 版 | Python 版 |
|---|---|---|
| 架构风格 | 微服务(Spring Cloud) | 单体应用(FastAPI 单进程) |
| 框架 | Spring Boot 3.2 + Spring Cloud | FastAPI 0.115+ |
| ORM | MyBatis Plus | SQLAlchemy 2.0+(异步) |
| 认证 | Spring Security + JJWT | 自定义 JWT + bcrypt |
| 异步任务 | RabbitMQ + Spring Cloud Stream | asyncio.create\_task(Celery 已配置未启用) |
| AI 框架 | LangChain4j | LangChain + OpenAI SDK |
| 模块组织 | 独立可部署微服务 ×10 | apps/ 目录下 Python 包 ×9 |
| 数据库 | 同一套(MySQL ×9 + MongoDB + ES + Neo4j + Redis) | |
| API 接口 | 同一套 RESTful 规范,路径与参数一致 | |
| 前端 | 同一个 React 18 项目,零改动切换 |
核心设计原则:两套后端的数据库、中间件、API 契约完全一致。你可以在任意时刻从 Java 版切换到 Python 版(或反之),前端、数据库、缓存、ES 索引均不受影响。Python 版的模块间通过 Python 直接导入通信,无需 HTTP 调用或服务发现。
2. 系统全景架构
Python 版采用单体应用架构,所有功能模块运行在同一个 FastAPI 进程中,通过 Python 包导入直接通信。
3. 逻辑架构
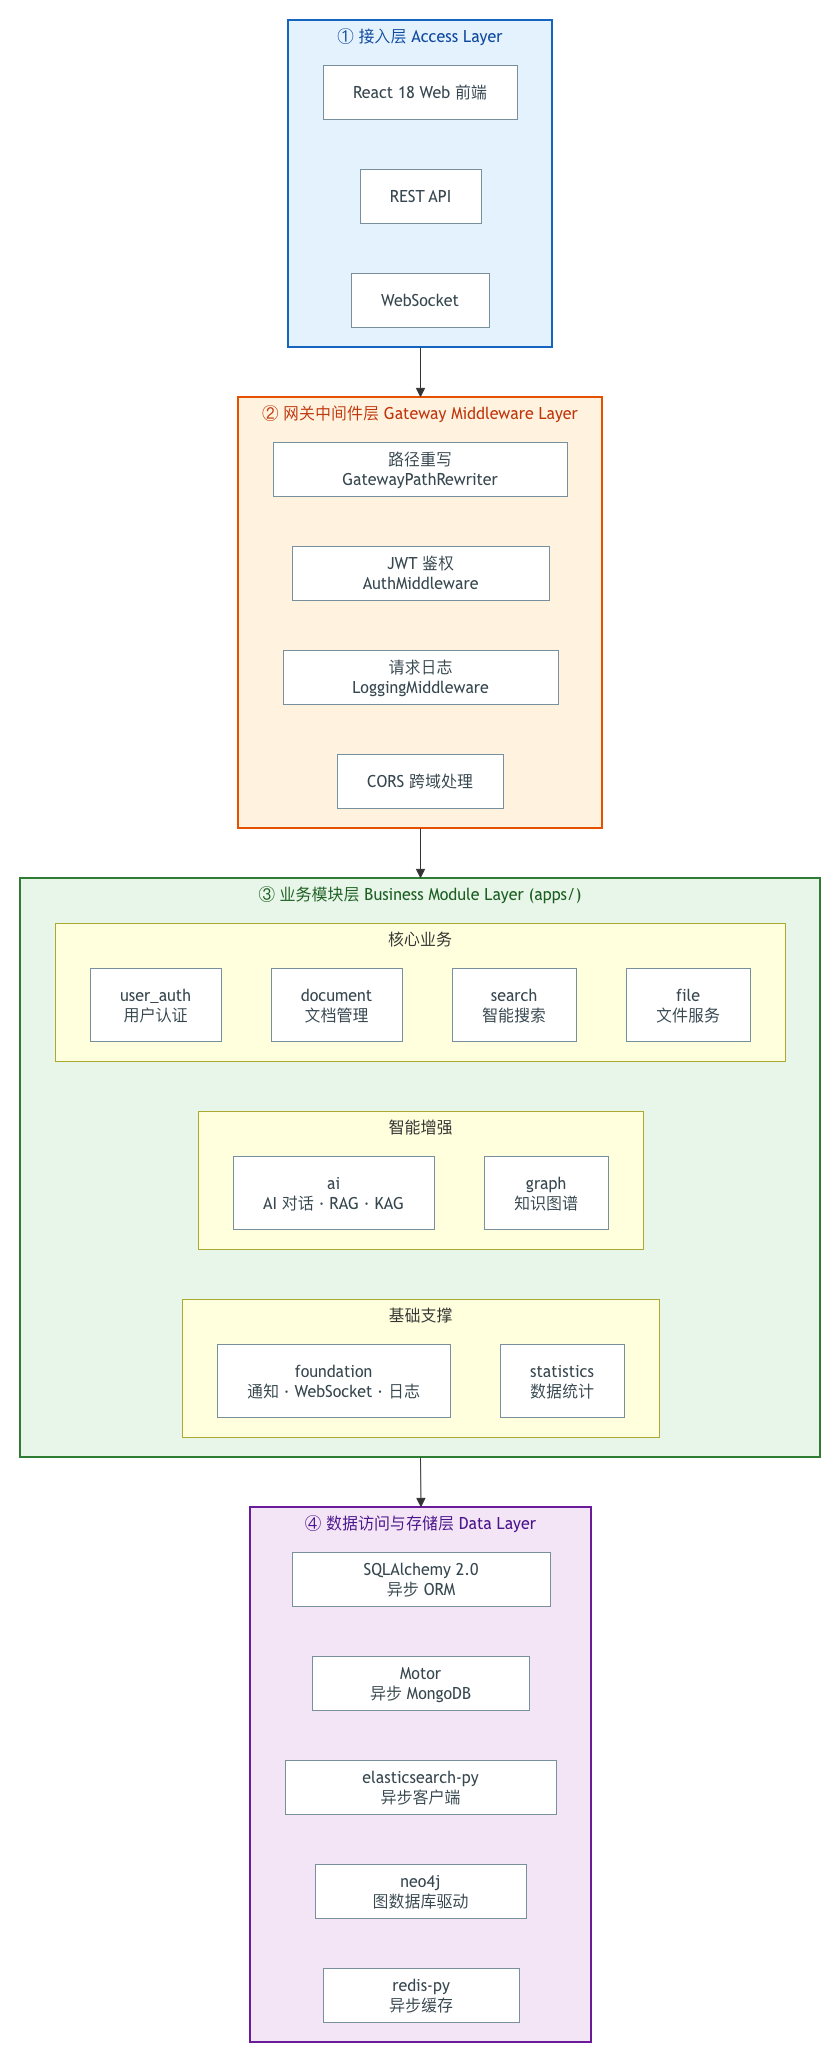
3.1 分层架构
系统采用 四层单体架构,所有模块运行在同一进程中,通过 Python 包导入直接通信:
3.2 模块职责边界
每个业务模块的职责范围:
| 模块 | 包路径 | 独有职责 | 不负责 |
|---|---|---|---|
| user\_auth | apps/user_auth/ | 用户 CRUD、角色/权限管理、JWT 签发 | 文档内容、审核逻辑 |
| document | apps/document/ | 文档 CRUD、分类/标签、评论/点赞、版本管理、审核工作流 | AI 对话、图谱构建 |
| search | apps/search/ | 全文检索、搜索历史 | 文档存储、内容管理 |
| file | apps/file/ | 文件上传/下载/预览、格式转换 | 文档元数据、权限 |
| ai | apps/ai/ | 多模型对话、RAG 检索增强、KAG 图谱推理、智能写作 | 文档 CRUD、用户管理 |
| graph | apps/graph/ | 图查询、路径遍历、子图扩展 | AI 对话、文件管理 |
| foundation | apps/foundation/ | 通知推送、操作日志、WebSocket、系统配置 | 业务逻辑 |
| statistics | apps/statistics/ | 数据聚合、趋势分析、跨库统计 | 原始数据管理 |
4. 应用模块设计
4.1 模块依赖关系
所有业务模块位于 apps/ 目录下,共享基础设施位于 common/ 包中。模块间通过 Python 直接 import 调用,无需 HTTP 通信。
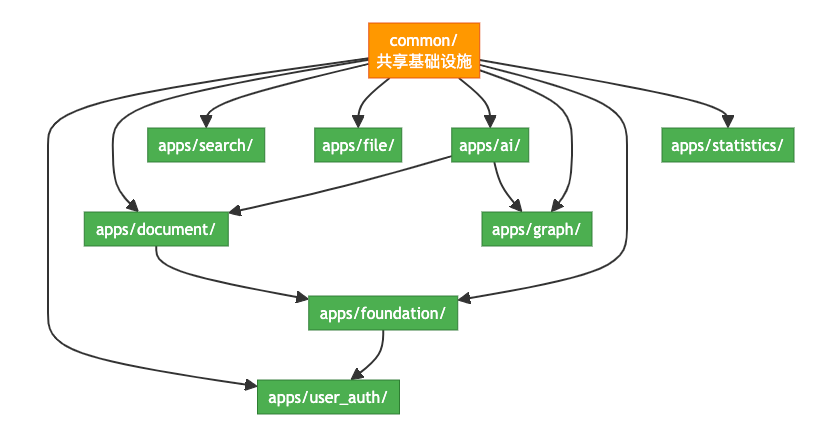
common/ 是唯一被所有模块依赖的共享包,提供:
| 类别 | 核心模块 | 说明 |
|---|---|---|
| 数据库 | common.database | DatabaseManager:管理 9 个 MySQL 异步引擎和 Session |
| 统一响应 | common.result | Result[T]、PageResult[T] Pydantic 模型 |
| 认证工具 | common.security | JWTHandler(JWT 签发/验证/刷新)、PasswordHandler(bcrypt) |
| 依赖注入 | common.deps | get_current_user()、PermissionChecker、UserContext |
| 异常处理 | common.exceptions | 全局异常拦截与标准错误响应 |
| ID 生成 | common.id_generator | Snowflake 分布式 ID |
| 基础模型 | common.base_model | SQLAlchemy Base、TimestampMixin、SoftDeleteMixin |
| Redis | common.redis | RedisManager 异步连接池 |
| RabbitMQ | common.rabbitmq | RabbitMQManager(审核通知事件) |
4.2 项目目录结构
所有模块位于 apps/ 目录下,每个模块遵循统一规范:
knowledge-base-python/
├── main.py                    # FastAPI 应用入口 + lifespan + 路由注册
├── config.py                  # Pydantic Settings 全量配置
├── docker-compose.yml         # 基础设施容器(MySQL/Redis/ES/Mongo/Neo4j/MinIO/RabbitMQ)
├── alembic.ini                # 数据库迁移配置
├── pyproject.toml             # 项目依赖
│
├── common/                    # 共享基础设施
│   ├── database.py            # DatabaseManager(9 个异步引擎)
│   ├── security.py            # JWTHandler + PasswordHandler
│   ├── deps.py                # FastAPI 依赖注入
│   ├── base_model.py          # SQLAlchemy Base 模型 + Mixin
│   │── redis.py               # Redis 异步客户端
│   ├── rabbitmq.py            # RabbitMQ 异步客户端
│   ├── result.py              # Result/PageResult 响应模型
│   ├── exceptions.py          # 全局异常处理
│   └── ...
│
├── apps/                      # 所有业务模块
│   ├── gateway/               # 内嵌网关中间件
│   │   └── middleware.py      # 路径重写 · JWT认证 · 日志
│   ├── user_auth/            # 用户认证模块
│   │   ├── models.py
│   │   ├── routers/           # auth, user, role, permission, team
│   │   ├── schemas/
│   │   └── services/
│   ├── document/             # 文档管理模块(最大模块)
│   │   ├── models.py
│   │   ├── routers/           # document, category, tag, comment, review, version, share, favorite
│   │   ├── schemas/
│   │   └── services/
│   ├── search/               # 搜索模块
│   │   ├── routers/
│   │   ├── es_client.py      # ES 异步客户端
│   │   └── services/
│   ├── file/                 # 文件模块
│   │   ├── routers/
│   │   ├── storage.py        # S3/MinIO 存储适配
│   │   └── services/
│   ├── ai/                   # AI 模块
│   │   ├── routers/           # chat, conversation, writing, feedback
│   │   ├── rag/               # RAG 子模块
│   │   │   ├── chunking_service.py
│   │   │   ├── embedding_service.py
│   │   │   ├── vector_index_service.py
│   │   │   ├── rag_retrieval_service.py
│   │   │   ├── rag_chat_service.py
│   │   │   └── routers/
│   │   └── kag/               # KAG 子模块
│   │       ├── extraction_service.py
│   │       ├── kag_retrieval_service.py
│   │       ├── kag_chat_service.py
│   │       └── routers/
│   ├── graph/                # 知识图谱模块
│   │   ├── models.py          # GraphNodeVO/GraphEdgeVO Pydantic
│   │   ├── neo4j_client.py
│   │   ├── routers/
│   │   └── services/
│   ├── foundation/           # 基础服务模块
│   │   ├── routers/           # notification, operation_log, system_config
│   │   ├── websocket/         # WebSocket + SockJS
│   │   └── services/
│   └── statistics/           # 统计模块
│       ├── routers/
│       └── services/
│
├── alembic/                  # 数据库迁移脚本
├── scripts/                  # 诊断与测试脚本
└── sql/                      # 数据库初始化 SQL
4.3 关键设计模式
| 模式 | 应用场景 | 关键实现 |
|---|---|---|
| 依赖注入 | 全局复用数据库会话、认证用户 | FastAPI Depends(get_db) / Depends(get_current_user) |
| 单例模式 | 数据库引擎、Redis、ES、Neo4j 客户端 | 模块级懒加载全局单例 |
| 适配器模式 | 多 AI 模型统一接口 | AiChatService._get_llm_client() 统一返回 OpenAI 兼容客户端 |
| 策略模式 | 文档分块策略(可配置 chunk\_size / overlap) | RecursiveCharacterTextSplitter 参数化配置 |
| 中间件链 | 路径重写 → JWT 验证 → 请求日志 → CORS | 内嵌网关中间件洋葱模型 |
| 事件驱动 | RabbitMQ 审核通知 → WebSocket 实时推送 | ReviewEventType → RabbitMQ → sockjs_bridge |
5. 数据库架构设计
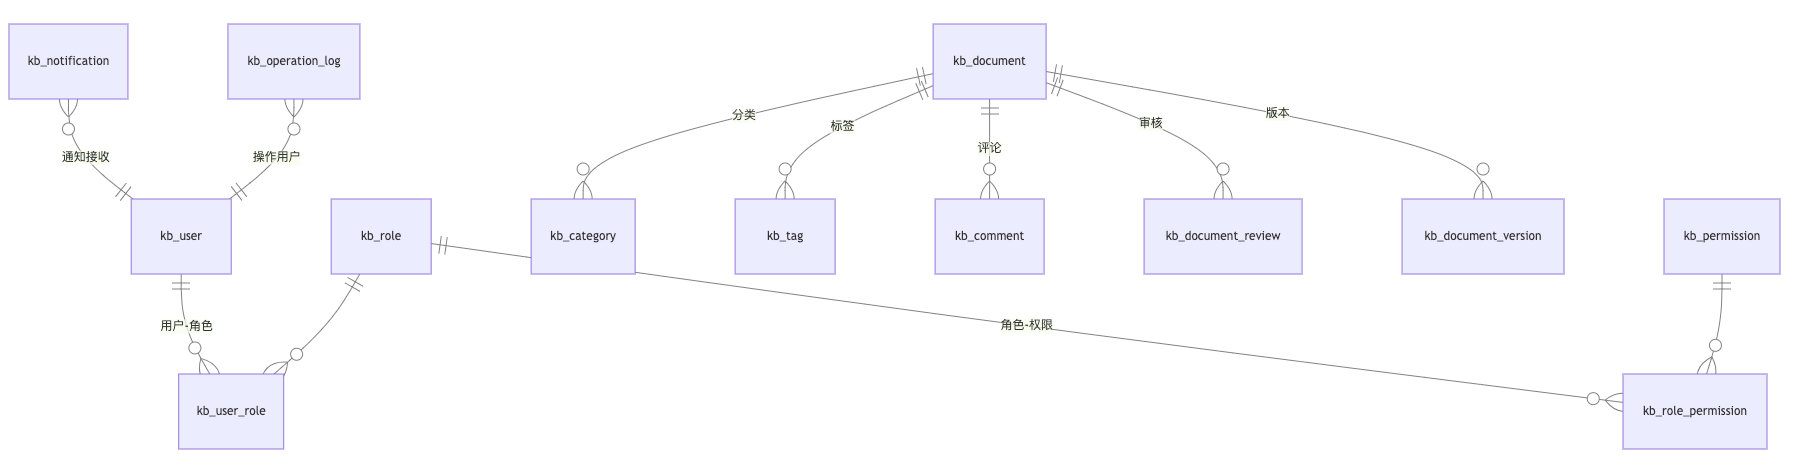
5.1 数据库隔离策略
系统严格遵循 Database per Service 模式,与 Java 版使用完全相同的数据库 Schema:
5.2 跨库视图设计
statistics-service 使用 MySQL 跨库视图聚合其他服务数据,避免 HTTP 调用:
-- kb_statistics 库中的跨库视图
CREATE VIEW kb_document AS SELECT * FROM kb_document.kb_document WHERE deleted = 0;
CREATE VIEW kb_user AS SELECT * FROM kb_user.kb_user WHERE deleted = 0;
CREATE VIEW kb_comment AS SELECT * FROM kb_document.kb_comment WHERE deleted = 0;
CREATE VIEW kb_operation_log AS SELECT * FROM kb_foundation.kb_operation_log;
CREATE VIEW kb_category AS SELECT * FROM kb_document.kb_category WHERE deleted = 0;
CREATE VIEW kb_ai_conversation AS SELECT * FROM kb_ai.kb_ai_conversation;
CREATE VIEW kb_ai_message AS SELECT * FROM kb_ai.kb_ai_message;
5.3 SQLAlchemy 模型定义
# shared/models/base.py
from datetime import datetime
from sqlalchemy import BigInteger, DateTime, Integer, func
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column

class Base(DeclarativeBase):
    pass

class TimestampMixin:
    """通用审计字段 Mixin"""
    id: Mapped[int] = mapped_column(
        BigInteger, primary_key=True, autoincrement=False,
        comment="Snowflake 雪花 ID"
    )
    created_at: Mapped[datetime] = mapped_column(
        DateTime, server_default=func.now(), comment="创建时间"
    )
    updated_at: Mapped[datetime] = mapped_column(
        DateTime, server_default=func.now(), onupdate=func.now(),
        comment="更新时间"
    )
    create_by: Mapped[int | None] = mapped_column(BigInteger, nullable=True)
    update_by: Mapped[int | None] = mapped_column(BigInteger, nullable=True)
    deleted: Mapped[int] = mapped_column(
        Integer, default=0, comment="逻辑删除: 0-正常, 1-已删除"
    )

# services/auth-service/models/user.py
class User(TimestampMixin, Base):
    __tablename__ = "kb_user"
    __table_args__ = {"schema": "kb_user"}

    username: Mapped[str] = mapped_column(String(50), unique=True, nullable=False)
    password: Mapped[str] = mapped_column(String(255), nullable=False)
    email: Mapped[str | None] = mapped_column(String(100))
    nickname: Mapped[str | None] = mapped_column(String(50))
    avatar: Mapped[str | None] = mapped_column(String(500))
    status: Mapped[int] = mapped_column(Integer, default=1, comment="1-正常, 0-禁用")
5.4 表字段规范
所有业务表遵循统一规范(与 Java 版完全一致):
`id`           BIGINT NOT NULL    COMMENT 'Snowflake 雪花 ID',
`created_at`   DATETIME NOT NULL  DEFAULT CURRENT_TIMESTAMP,
`updated_at`   DATETIME NOT NULL  DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,
`create_by`    BIGINT DEFAULT NULL,
`update_by`    BIGINT DEFAULT NULL,
`deleted` TINYINT NOT NULL DEFAULT 0 COMMENT '逻辑删除: 0-正常, 1-已删除'- 主键:所有表使用
SnowflakeIdGenerator生成 19 位 BIGINT ID,由应用层生成后传入 - 逻辑删除:在所有查询中手动加入
WHERE deleted = 0或使用 SQLAlchemy 事件拦截 - 字符集:全部
utf8mb4+utf8mb4_unicode_ci - 迁移工具:每个服务独立使用 Alembic 管理 DDL 版本
5.5 数据库分布
| # | 数据库 | 拥有服务 | 核心表数量 | 扩展存储 |
|---|---|---|---|---|
| 1 | kb_user | auth-service | 8 | — |
| 2 | kb_document | document-service | 7 | MongoDB(文档内容), ES(全文索引) |
| 3 | kb_search | search-service | 1 | ES(搜索索引) |
| 4 | kb_file | file-service | 1 | RustFS(文件存储) |
| 5 | kb_ai | ai-service | 3 | ES(RAG 向量块) |
| 6 | kb_statistics | statistics-service | 4 + 7视图 | Celery(事件消费) |
| 7 | kb_graph | graph-service | 3 | Neo4j(图存储) |
6. 认证与授权体系
6.1 认证架构
系统使用自定义 JWT 认证(非 FastAPI Users 库),通过 common/security.py 中的 JWTHandler 实现。网关中间件(AuthMiddleware)负责全局 JWT 校验并注入 X-User-Id 头,业务模块通过 Depends(get_current_user) 获取用户上下文。
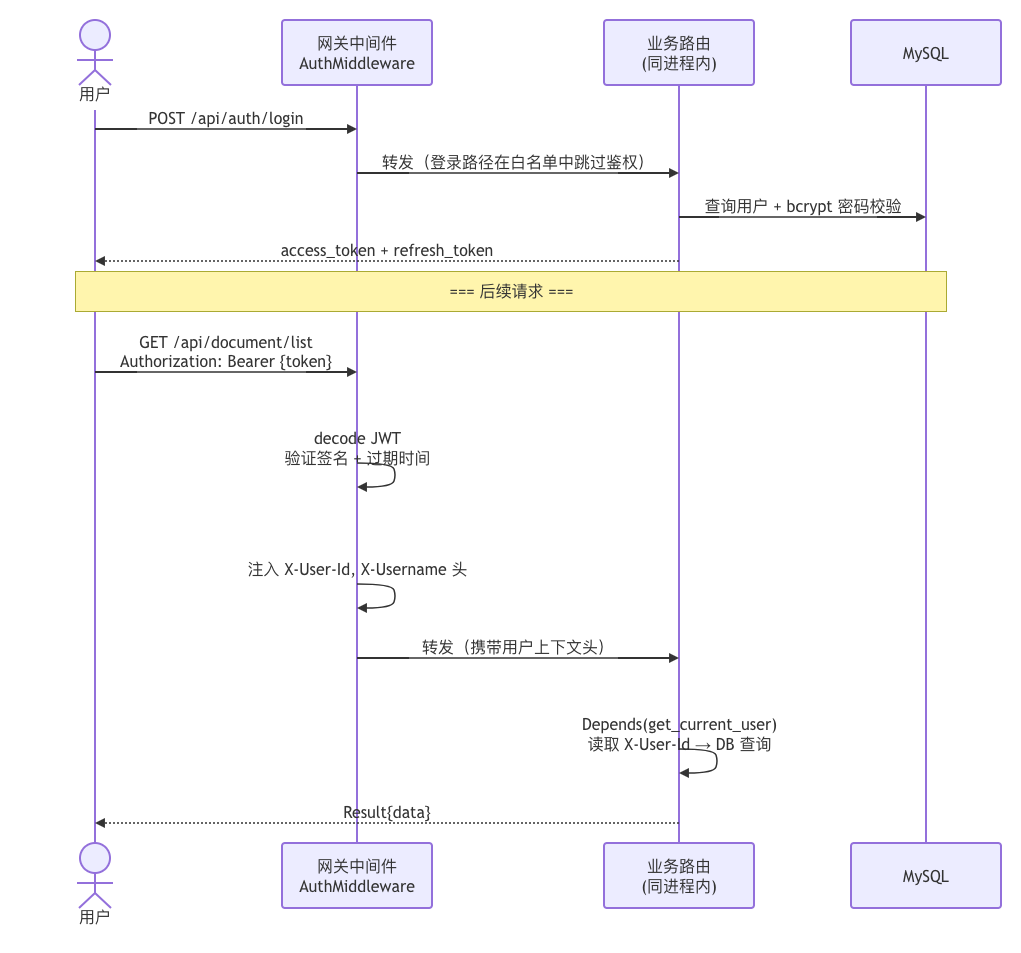
注意:网关中间件不会在鉴权失败时返回 401(始终放行),权限校验由业务路由层的Depends(get_current_user)和PermissionChecker负责。这意味着需要登录的接口如果缺少有效 Token 会在路由层返回 401。
6.2 JWT 令牌设计
| 令牌类型 | 有效期 | 用途 |
|---|---|---|
| access\_token | 2 小时 | API 请求身份凭证 |
| refresh\_token | 7 天 | 无感刷新 access\_token |
JWT Payload 结构:
{
  "sub": "1000000000000000001",
  "username": "admin",
  "avatar": "https://...",
  "type": "access",
  "iat": 1718832000,
  "exp": 1718839200
}
6.3 FastAPI 依赖注入实现
# common/deps.py
from fastapi import Depends, HTTPException, Request

class UserContext:
    """用户上下文数据类"""
    user_id: int
    username: str
    avatar: str | None
    permissions: list[str]

async def get_current_user(request: Request) -> UserContext:
    """从请求头中提取当前用户(四级优先级)"""
    # 优先级 1: 网关中间件注入的 X-User-Id 头
    user_id = request.headers.get("X-User-Id")
    if user_id:
        return UserContext(user_id=int(user_id), ...)

    # 优先级 2: Authorization: Bearer <token>
    auth_header = request.headers.get("Authorization")
    if auth_header and auth_header.startswith("Bearer "):
        token = auth_header[7:]
        payload = JWTHandler.decode_token(token)
        return UserContext(user_id=payload["userId"], ...)

    # 优先级 3: ?token=<token> 查询参数(WebSocket)
    # 优先级 4: access_token Cookie

    raise UnauthorizedException()

# 在路由中使用
@router.get("/me")
async def get_my_profile(
    current_user: UserContext = Depends(get_current_user)
):
    return Result(data=current_user)
6.4 RBAC 权限模型
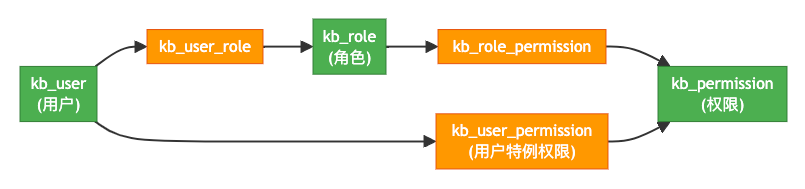
预置角色与权限:
| 角色 | 编码 | 核心权限 |
|---|---|---|
| 超级管理员 | ROLE_SUPER_ADMIN | 全部权限 |
| 知识管理员 | ROLE_ADMIN | 文档管理 + 分类/标签/版本 + 审核 |
| 知识编辑者 | ROLE_EDITOR | 文档查看 + 创建 + AI 对话 |
| 审核员 | ROLE_REVIEWER | 文档查看 + 审核 |
| 知识成员 | ROLE_USER | 文档查看/创建/编辑/删除 + AI 对话 |
| 游客 | ROLE_VISITOR | 文档查看(只读) |
权限校验装饰器:
# shared/security.py
from functools import wraps

def require_permission(permission_code: str):
    """方法级权限校验装饰器"""
    def decorator(func):
        @wraps(func)
        async def wrapper(*args, current_user: User = Depends(get_current_user), **kwargs):
            has_permission = await permission_service.check(
                current_user.id, permission_code
            )
            if not has_permission:
                raise HTTPException(status_code=403, detail=f"缺少权限: {permission_code}")
            return await func(*args, current_user=current_user, **kwargs)
        return wrapper
    return decorator

# 使用
@router.put("/documents/{doc_id}")
@require_permission("document:edit")
async def update_document(doc_id: int, body: DocumentUpdate, ...):
    ...
6.5 网关白名单
网关中间件(AuthMiddleware)对以下路径跳过 JWT 校验:
/api/auth/**               # 登录/注册/刷新Token
/api/files/**              # 文件下载(可公开访问)
/api/ai/**                 # AI 对话(匿名可选,路由层校验)
/api/config/public         # 公开配置
/ws/**                     # WebSocket 连接(在连接时通过查询参数认证)
/docs                      # FastAPI Swagger 文档
/redoc                     # FastAPI ReDoc 文档
6.6 Token 管理说明
- 无 Token 黑名单:当前版本未实现 Redis 黑名单机制,Token 签发后在其有效期内始终有效
- Token 刷新:
refresh_token仅用于签发新的access_token,不会使旧 Token 失效 - 生产环境建议配合短有效期的 access\_token(默认 2 小时)+ 网关层 IP 白名单进行安全加固
7. 核心业务流程
7.1 文档审核工作流
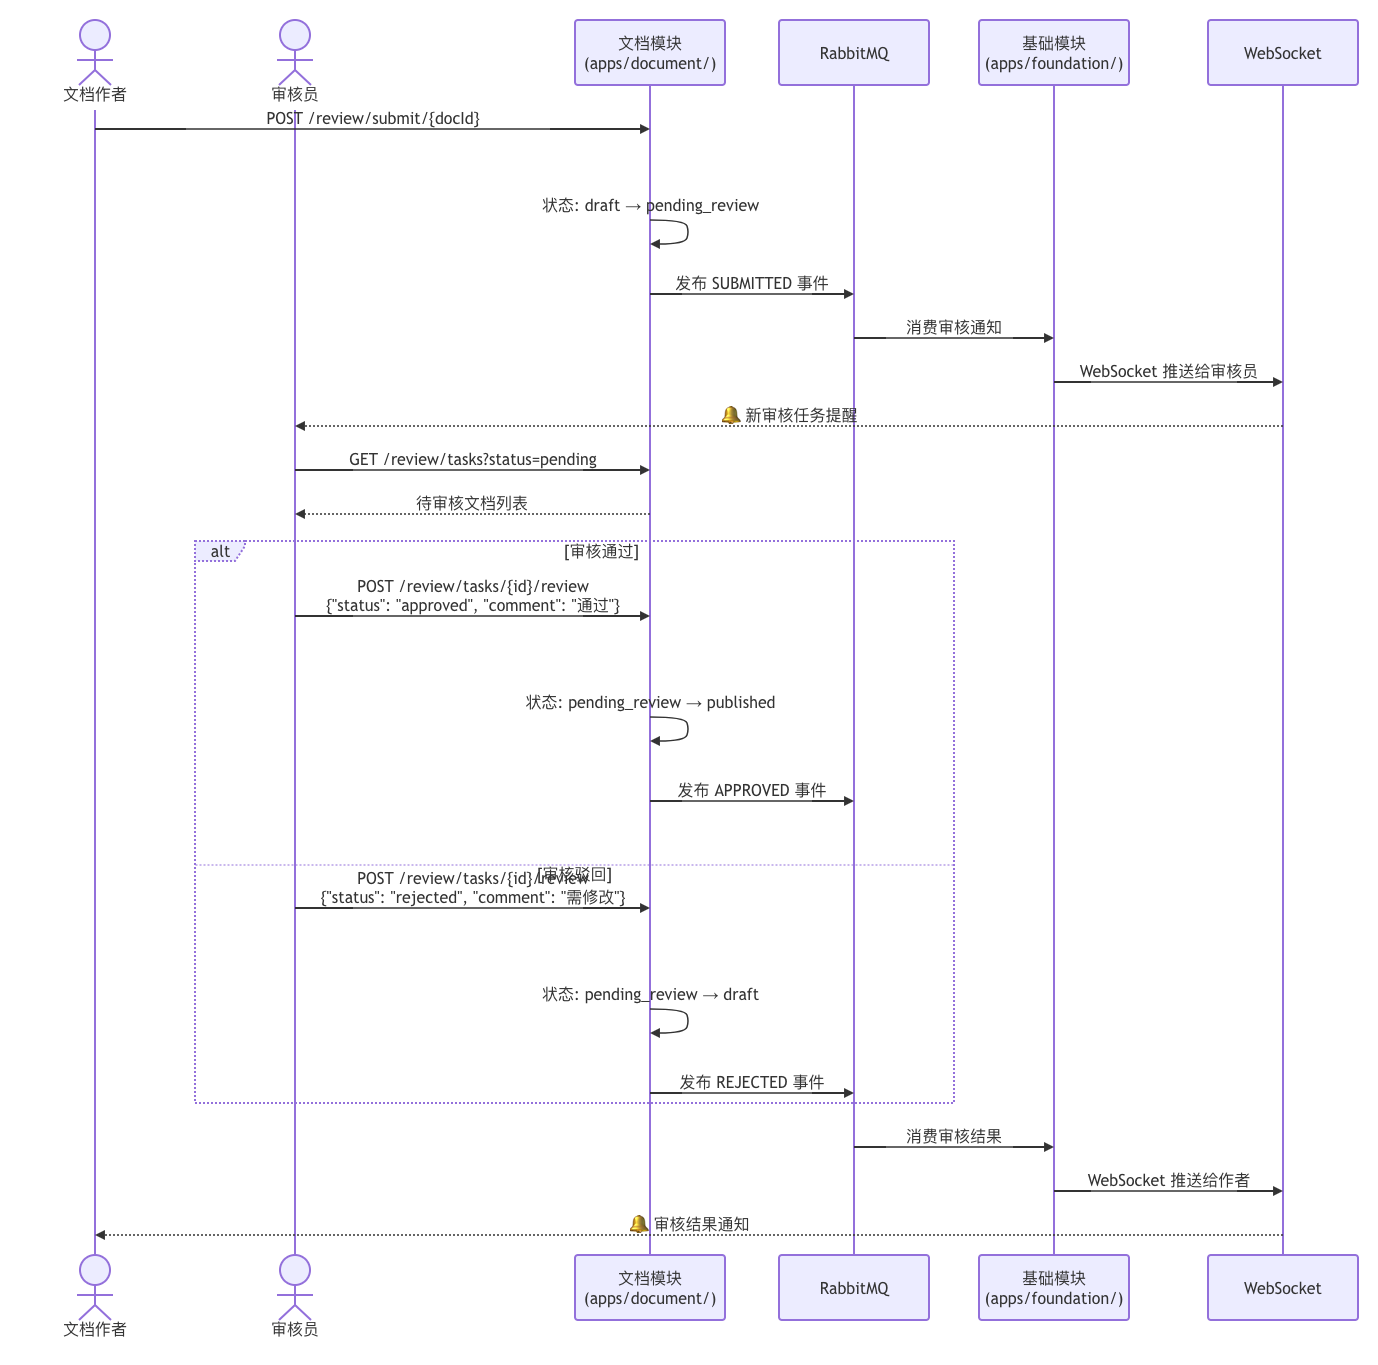
审核流程由 apps/document/services/document_review_service.py 驱动,通过 RabbitMQ 发送审核事件,apps/foundation/ 消费事件并通过 WebSocket 实时推送通知。RabbitMQ 不可用时降级为同步数据库通知。
7.2 RAG 知识增强问答
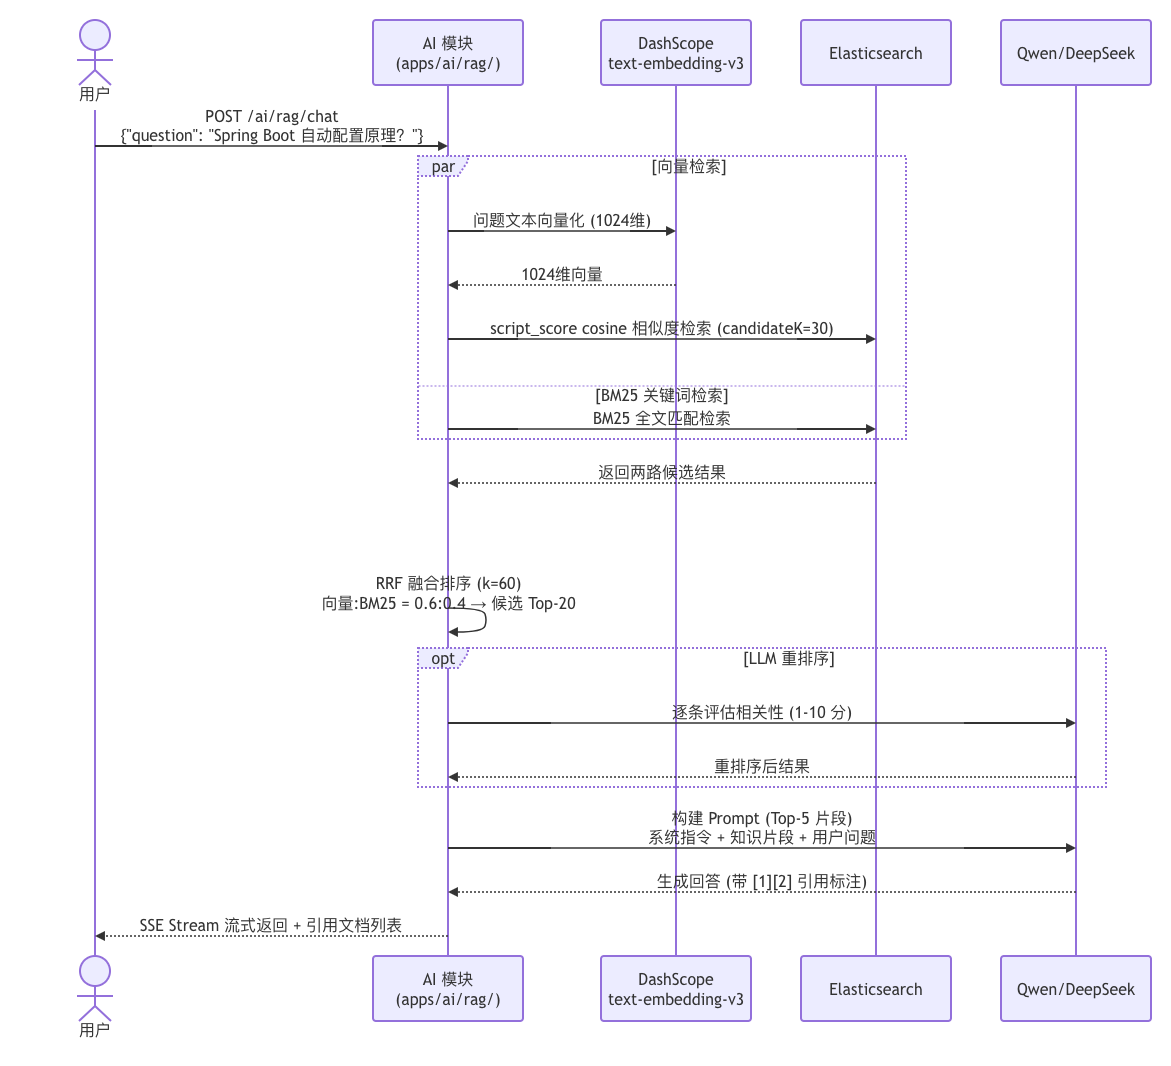
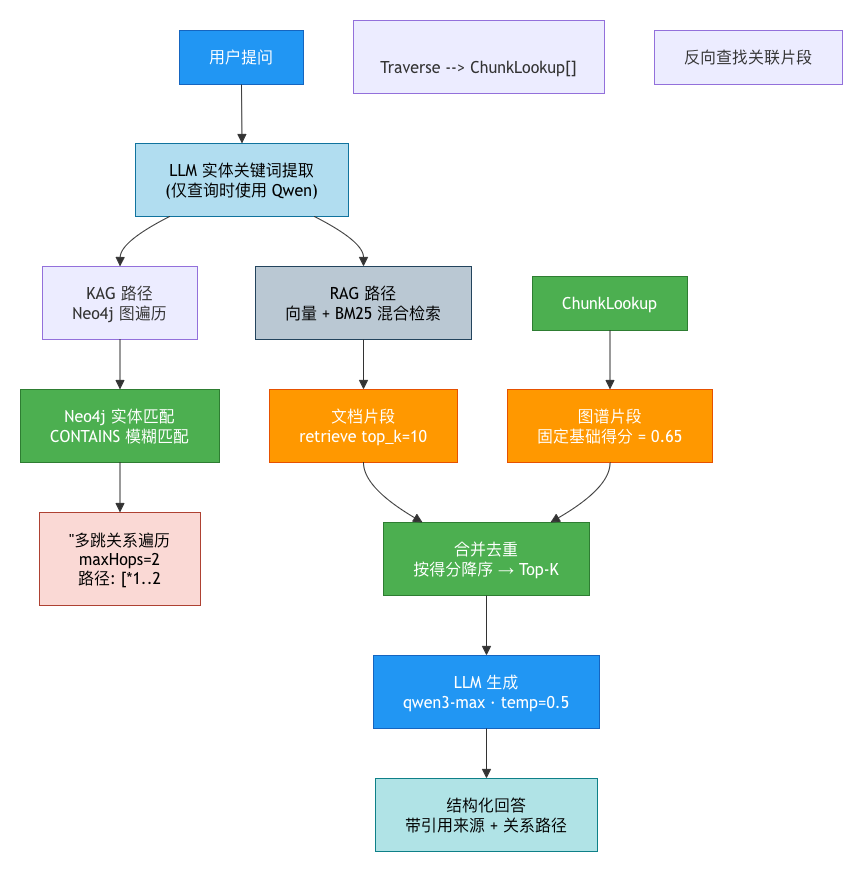
RAG 流程由 apps/ai/rag/ 子模块实现。采用混合检索(向量 0.6 + BM25 0.4,RRF k=60),可选 LLM 重排序阶段。
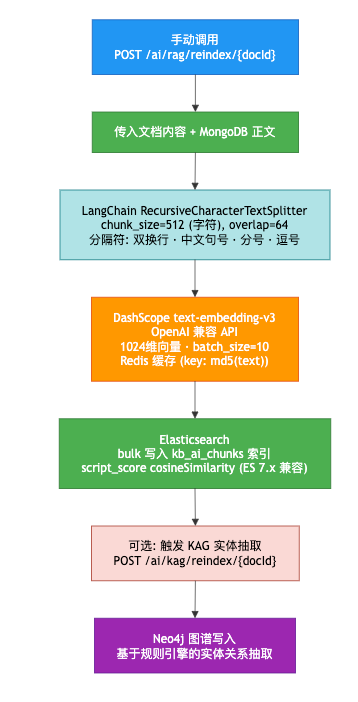
7.3 RAG 文档入库索引流程
文档索引不会在发布时自动触发。索引通过独立的 API 端点 POST /ai/rag/reindex/{doc_id} 手动触发,需传入文档内容和分块参数。POST /ai/rag/reindex/all 端点(全量重建)当前为桩实现。
7.4 KAG 图谱增强推断
KAG 检索由 apps/ai/kag/ 子模块实现。实体抽取基于**规则引擎**(关键词字典 + 正则表达式),查询时的实体链接才使用 LLM 辅助。
RAG 和 KAG 结果通过去重合并(KAG 结果固定得分 0.65),非 50:50 加权融合。
8. API 网关与通信
8.1 内嵌网关中间件
Python 版不使用外部 API 网关(Traefik/Nginx)。所有网关功能通过 apps/gateway/middleware.py 中的 **Starlette 中间件** 在应用进程内实现。
中间件执行顺序(外层→内层,洋葱模型):
Request → AuthMiddleware → LoggingMiddleware → CORSMiddleware → GatewayPathRewriter → 业务路由| 顺序 | 中间件 | 职责 |
|---|---|---|
| 1 (最外层) | AuthMiddleware | JWT 令牌校验,注入 X-User-Id / X-Username 头。白名单路径跳过校验,鉴权失败不拦截(交由路由层处理) |
| 2 | LoggingMiddleware | 请求方法、路径、状态码、耗时记录 |
| 3 | CORSMiddleware | 跨域请求处理(allow_origins=["*"]) |
| 4 (最内层) | GatewayPathRewriter | 路径重写:折叠重复前缀(/api/auth/auth/login → /api/auth/login)、跨服务路由(/api/auth/users/page → /api/users/page) |
8.2 模块间通信
系统采用单体架构,模块间通过 Python 直接导入 通信,无需 HTTP 调用或服务发现:
# apps/ai/kag/kag_retrieval_service.py 中直接导入其他模块
from apps.ai.rag.rag_retrieval_service import retrieve        # RAG 检索
from apps.ai.services.ai_chat_service import AiChatService     # LLM 调用
from apps.graph.neo4j_client import run_cypher                 # Neo4j 查询

# apps/document/services/document_review_service.py 中调用通知服务
from apps.foundation.services.notification_service import NotificationService
from apps.foundation.websocket.sockjs_handler import sockjs_bridge_send_to_user
唯一的外部 HTTP 调用:apps/file/services/file_service.py 和 apps/document/services/document_service.py 中使用 httpx 下载外部 URL 资源(文件导入、图片转换),非服务间调用。
8.3 异步通信(RabbitMQ)
唯一的异步消息场景是审核通知——apps/document/services/document_review_service.py 通过 common/rabbitmq.py 发布审核事件(SUBMITTED / APPROVED / REJECTED),apps/foundation/mq/review_notification_listener.py 消费事件并通过 WebSocket 推送实时通知。
注意:项目配置了 Celery(pyproject.toml中有celery[redis]依赖),但实际代码中**未初始化 Celery 应用实例**,无 Task 定义,无 Worker 启动命令。当前所有异步处理使用asyncio.create_task()。
9. 前端架构设计
与 Java 版共用同一套 React 前端,详见《企业智能知识库系统-系统架构文档》第 9 节。两套后端的 API 路径、参数、响应格式完全一致,前端无需任何改动即可切换后端。
10. AI 引擎架构
10.1 LLM 多模型接入
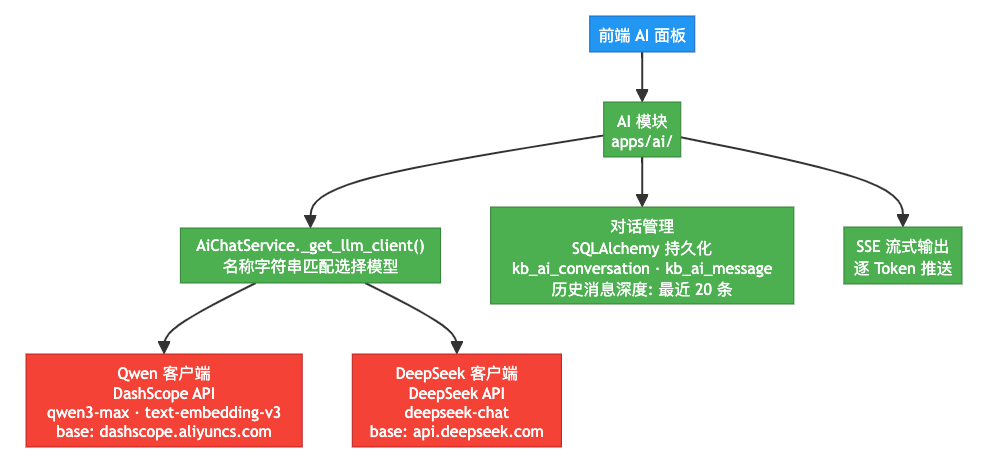
通过 apps/ai/services/ai_chat_service.py 中的 AiChatService._get_llm_client() 方法管理多模型。两个模型均通过 OpenAI 兼容 API 调用,模型选择基于名称字符串匹配(if "deepseek" in model → DeepSeek,其他 → Qwen)。
无智能路由和自动 Fallback 逻辑——API Key 缺失时直接抛出 BusinessException。
10.2 AI 功能路由架构
当前版本未使用 LangGraph 或 Agent 编排框架。RAG 和 KAG 作为独立的子模块存在,各自提供独立的 API 端点。路由由前端选择或通过 KAG 的 fused_retrieval() 方法手动融合。
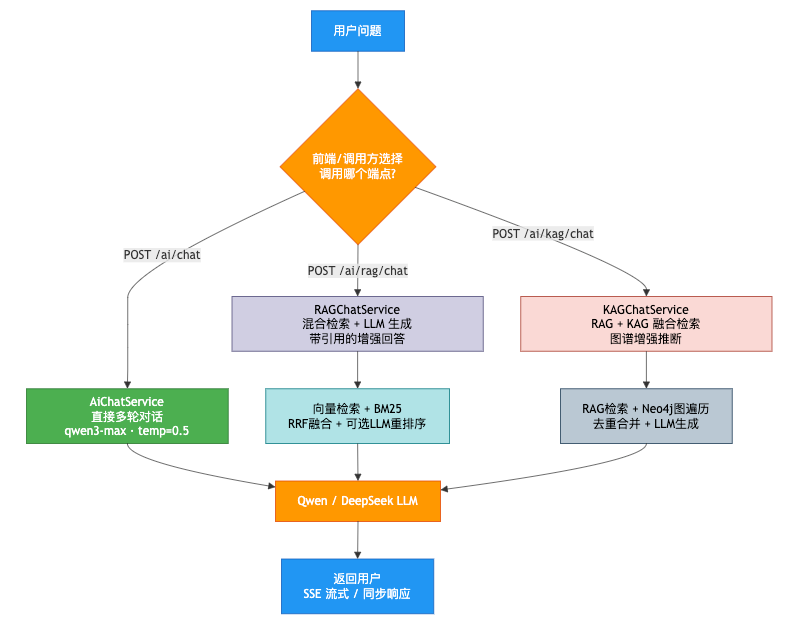
说明:项目依赖列表中包含 langgraph 但实际代码中**未使用**。AI 功能的路径选择由前端调用不同的 API 端点实现,不存在服务端 Agent 编排、意图识别或自动路由。10.3 RAG 文档分块策略
分块由 apps/ai/rag/chunking_service.py 中的 RecursiveCharacterTextSplitter 实现。使用**字符级分块**(非 Token 计数),分隔符针对中文优化。
未使用 MarkdownHeaderTextSplitter,Markdown 标题层级在分块时不保留。
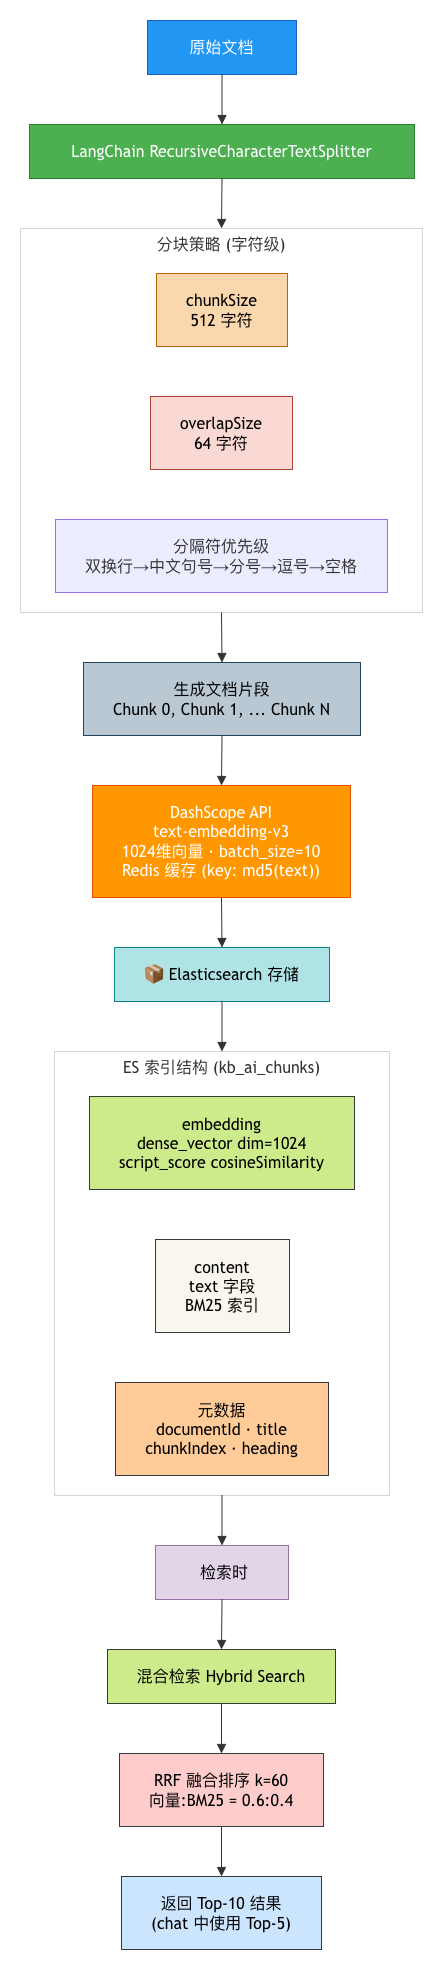
分块代码实现(来自实际项目 apps/ai/rag/chunking_service.py):
from langchain.text_splitter import RecursiveCharacterTextSplitter

class ChunkingService:
    def __init__(self, chunk_size: int = 512, chunk_overlap: int = 64):
        self.text_splitter = RecursiveCharacterTextSplitter(
            chunk_size=chunk_size,      # 字符数,非 Token 数
            chunk_overlap=chunk_overlap,
            separators=[
                "\n\n", "\n",           # 段落边界优先
                "。", ".", ";", ";",   # 中文句子边界
                ",", ",", " ", ""      # 最后手段
            ]
        )

    def chunk(self, content: str, metadata: dict) -> list[dict]:
        """纯字符分割,不感知 Markdown 标题层级"""
        chunks = self.text_splitter.create_documents(
            texts=[content], metadatas=[metadata]
        )
return [{"content": c.page_content, "metadata": c.metadata} for c in chunks]检索参数:
- 候选池 Top-K: 10(检索),5(chat 最终使用)
- 向量相似度: cosine(script\_score 兼容 ES 7.x)
- RRF 融合: 向量权重 0.6,关键词权重 0.4,k=60
- LLM 重排序: 可选启用,串行逐条调用 LLM 评分(1-10),候选块截断至 1000 字符
10.4 多层降级体系
系统在所有 AI 相关路径上实现了分层降级,而非单一的线性回退链。每一层独立降级,上层失败不影响下层继续工作。
降级策略核心代码:
# ① Embedding 降级 — embedding_service.py
# API Key 未配置 → 零向量;批量失败 → 逐条;单条失败 → 零向量;缓存不可用 → 调 API
if not api_key:
    return [0.0] * dimension  # 优雅降级:零向量,系统继续运行
try:
    vectors = await client.embeddings.create(input=texts, model=model)
except Exception:
    # 批量失败 → 降级为逐条调用
    vectors = [await embed_single(t) for t in texts]

# ② 检索降级 — rag_retrieval_service.py
try:
    query_vector = await embed_query(query)
except Exception:
    # 查询嵌入失败 → 降级为纯 BM25 关键词搜索
    logger.warning(f"查询嵌入失败,降级为纯关键词搜索")
    return keyword_search(query)

try:
    reranked = await llm_rerank(results, query)
except Exception:
    # LLM 重排序失败 → 降级为 RRF 原始排序
    logger.warning(f"LLM 重排序失败,降级为 RRF 排序")
    return rrf_fused

# ③ RAG/KAG 互相降级 — rag_chat_service.py + kag_retrieval_service.py
try:
    rag_results = await rag_retrieve(query)
except Exception:
    # RAG 检索失败 → 降级为纯 LLM 对话模式
    logger.warning(f"RAG检索失败,降级为纯 LLM 模式")
    rag_results = []

try:
    kag_results = await kag_retrieve(query)
except Exception:
    # KAG 图检索失败 → 降级为纯 RAG
    logger.warning(f"KAG图检索失败,降级为纯RAG")
    kag_results = []

# ④ 基础设施降级 — main.py, search_service.py, file_parser_service.py
# RabbitMQ 不可用 → 同步回退
# ES 查询失败 → MySQL LIKE 回退
# S3 上传失败 → base64 Data URI 回退设计原则:
| 原则 | 说明 |
|---|---|
| 逐层独立 | 每一层的降级不影响其他层,Embedding 失败不会拖垮 Chat |
| 最终兜底 | 所有 AI 功能全部不可用时,文档 CRUD、权限管控、全文搜索仍正常工作 |
| 静默降级 | 降级时只打 WARNING 日志,不抛异常中断用户请求 |
| 自动恢复 | 不持久化降级状态,每次请求独立判断,上游服务恢复后自动切回正常路径 |
11. 知识图谱架构
11.1 图谱存储架构
知识图谱数据仅存储在 Neo4j 中。
图谱模块的 Pydantic 模型(GraphNodeVO、GraphEdgeVO 等)仅用于 HTTP 响应序列化,不映射数据库表。
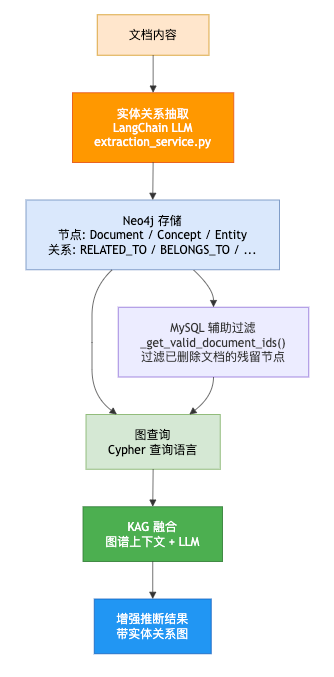
通过 _get_valid_document_ids() 查询已发布文档 ID,用于在 Neo4j 返回结果后过滤掉已删除文档的残留节点。Neo4j 不可用时,所有查询直接返回空结果。
这是有意为之——图数据和关系型数据面向不同的查询模式,双写会引入分布式一致性难题。
11.2 图谱节点与关系
实际代码(apps/graph/services/graph_service.py)中处理的节点和关系类型:
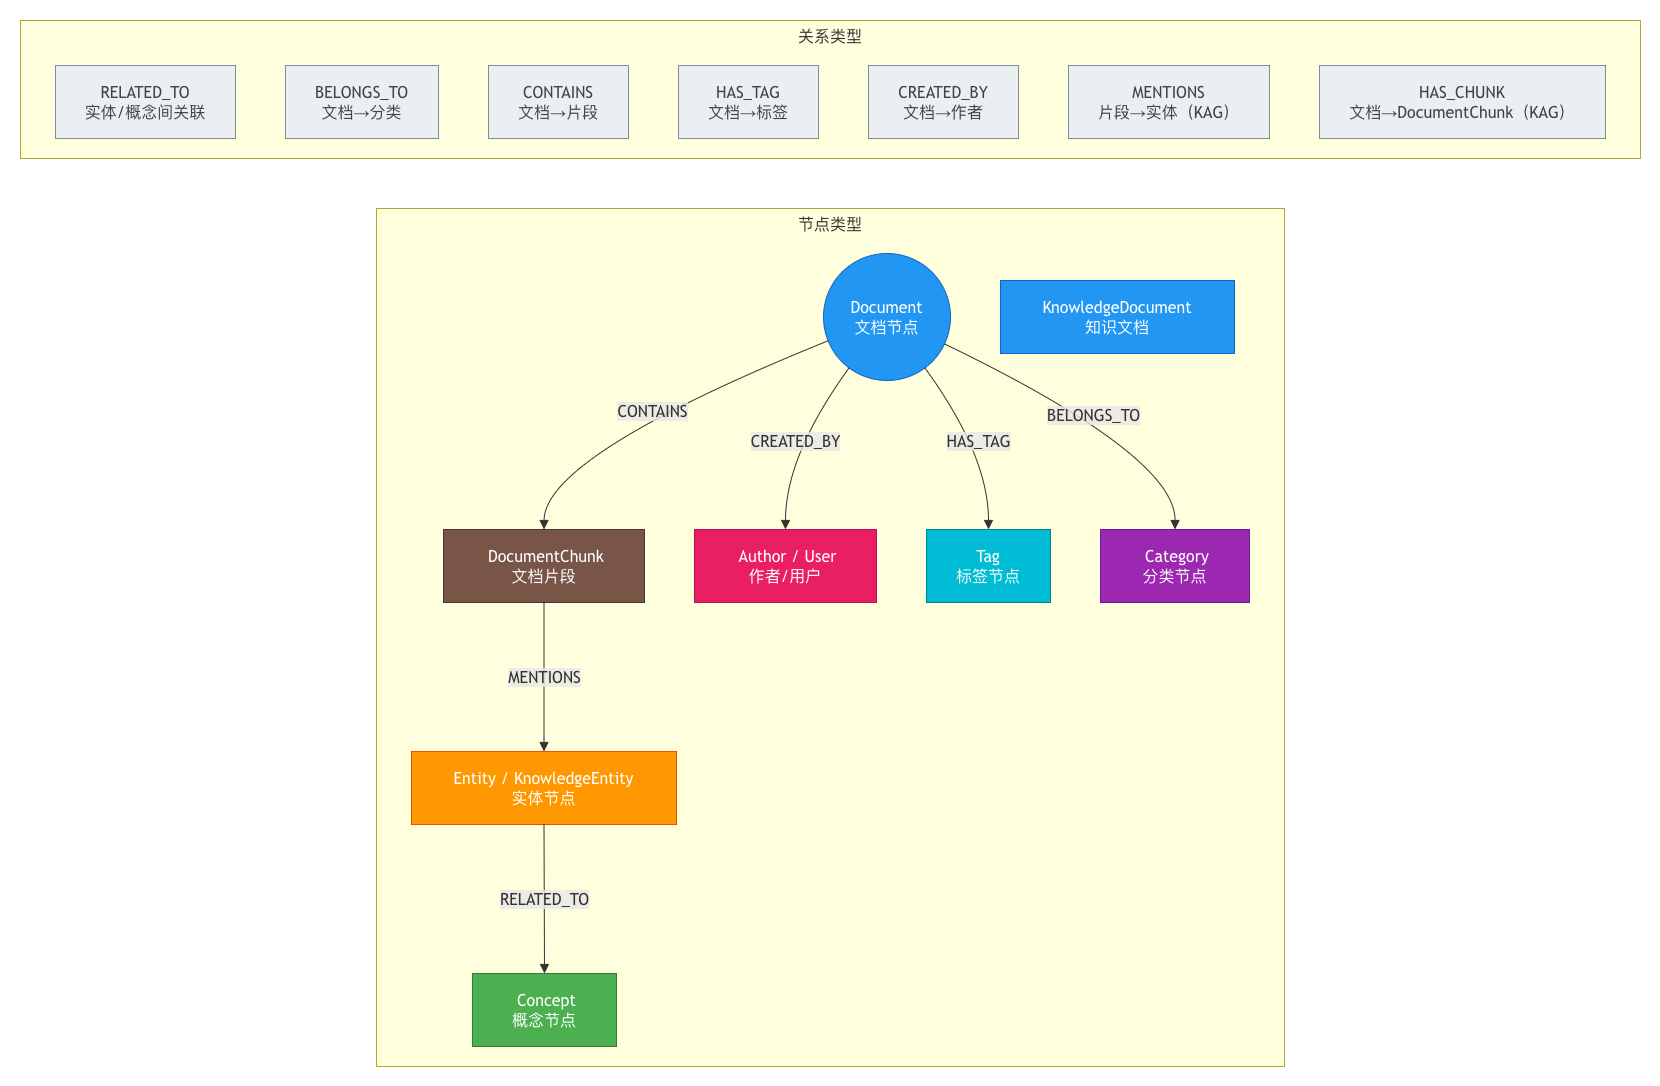
**节点颜色/大小视觉映射(来自 **graph_service.py**)**:
| 标签 | 颜色 | 大小 |
|---|---|---|
| Document / KnowledgeDocument | #2196F3 (蓝色) | 30 |
| Concept / Entity / KnowledgeEntity | #95de64 (绿色) | 20 |
| Category | #ffd666 (黄色) | 25 |
| Tag | #ff7c43 (橙色) | 18 |
| Author / User | #ff6b6b (红色) | 22 |
| DocumentChunk / Chunk | #36cfc9 (青色) | 15 |
图操作功能(apps/graph/services/graph_service.py 中的实际方法):
| 方法 | 功能 | 说明 |
|---|---|---|
get_graph_data() | 获取全图数据 | 最多 500 节点/边,Redis 缓存 1h |
search_nodes() | 节点搜索 | Neo4j 全文索引优先,回退 CONTAINS |
get_community() | 邻域子图 | 以节点为中心的 N-hop 展开(depth=2, max 50 节点),非图聚类算法 |
find_path() | 最短路径 | Neo4j shortestPath(),最大深度 5 |
cleanup_orphaned() | 孤立节点清理 | 删除无关系的非 Document 节点 |
社区发现说明:当前版本的 get_community() 是简单的以节点为中心的子图提取,未实现 Louvain、标签传播等图聚类算法。这是一个邻域可视化功能,不是真正意义上的社区检测。12. 部署拓扑
Python 版为单体应用,部署时启动单个 FastAPI 进程 + N 个基础设施容器。
建议资源配置:
| 组件 | 实例数 | 规格 | 说明 |
|---|---|---|---|
| Nginx (可选) | 1-2 | 2C4G | 反向代理 + HTTPS 终端 |
| FastAPI 应用 | 2-4 | 8C16G | uvicorn workers=N,水平扩展 |
| MySQL | 1 | 8C16G | 9 个独立数据库(同一实例) |
| Redis | 1 | 4C8G | 缓存 + Session |
| Elasticsearch | 1 | 8C16G | 全文检索 + 向量存储 |
| MongoDB | 1 | 4C8G | 文档内容 + 草稿 |
| Neo4j | 1 | 8C16G | 图存储与查询 |
| RabbitMQ | 1 | 2C4G | 审核事件通知 |
| MinIO | 1 | 4C8G | S3 兼容文件存储 |
13. 技术选型
13.1 Python 后端技术栈
| 类别 | 技术 | 版本 | 选型理由 |
|---|---|---|---|
| 语言 | Python | 3.12+ | asyncio 成熟、match-case 语法、PEP 695 类型参数 |
| 框架 | FastAPI | 0.115+ | 原生异步、自动 OpenAPI 文档、Pydantic 深度集成 |
| ASGI 服务器 | Uvicorn | - | 多 worker 协程并发 |
| 数据校验 | Pydantic | 2.x | Rust 内核 rust-pydantic |
| ORM | SQLAlchemy | 2.0+ | 异步支持、声明式映射 |
| 数据库驱动 | asyncmy | 0.2+ | Python 异步 MySQL 驱动 |
| 迁移工具 | Alembic | 1.13+ | 数据库 DDL 版本管理 |
| 认证 | python-jose + bcrypt | - / 4.1+ | 自定义 JWT 实现(非 FastAPI Users) |
| AI 框架 | LangChain (仅 TextSplitter) | 0.3+ | 仅使用分块功能,不用于 LLM 编排 |
| LLM SDK | OpenAI SDK | 1.x | 兼容 DashScope / DeepSeek API |
| Embedding | DashScope text-embedding-v3 | 云端 API | 通过 OpenAI 兼容接口调用,1024维 |
| 全文检索 | elasticsearch-py | 8.x | ES 异步客户端,script\_score cosine 相似度(ES 7.x 兼容) |
| 图数据库 | neo4j | 5.x | 官方 Python 异步驱动 |
| 缓存 | redis-py[hiredis] | 5.x | 异步 Redis 客户端 + 连接池 |
| 消息队列 | aio-pika (RabbitMQ) | - | 仅用于审核通知事件 |
| 任务队列 | asyncio.create\_task | 内置 | Celery 已配置未启用 |
| HTTP 客户端 | httpx | 0.28+ | 仅用于外部 URL 资源下载 |
| 配置管理 | Pydantic Settings | 2.x | .env 加载 + 类型安全配置 |
| 日志 | loguru | 0.7+ | 结构化日志 |
| 流式输出 | SSE (FastAPI StreamingResponse) | 原生 | 逐 Token 推送 |
| WebSocket | FastAPI WebSocket + SockJS | 原生 | 实时通知推送 |
13.2 Python vs Java 选型对比
| 维度 | Python 版 | Java 版 | 建议 |
|---|---|---|---|
| AI 生态 | ⭐⭐⭐⭐⭐ LangChain 原生 | ⭐⭐⭐ LangChain4j 移植版 | AI 重度的项目选 Python |
| 企业稳定 | ⭐⭐⭐⭐ FastAPI 异步 | ⭐⭐⭐⭐⭐ Spring 生态 | 大型团队选 Java |
| 开发效率 | ⭐⭐⭐⭐⭐ 动态语言 | ⭐⭐⭐ 编译型 | 快速迭代选 Python |
| 性能 | ⭐⭐⭐⭐ asyncio 协程 | ⭐⭐⭐⭐⭐ 虚拟线程 | 高并发选 Java |
| 类型安全 | ⭐⭐⭐ mypy + Pydantic | ⭐⭐⭐⭐⭐ 编译时类型 | 安全敏感选 Java |
| 运维成本 | ⭐⭐⭐⭐ Docker/K8s | ⭐⭐⭐ 需要 JVM | 轻量部署选 Python |
| 招聘市场 | ⭐⭐⭐ 增长中 | ⭐⭐⭐⭐⭐ 成熟 | 保守选 Java |
14. 安全设计
14.1 安全分层
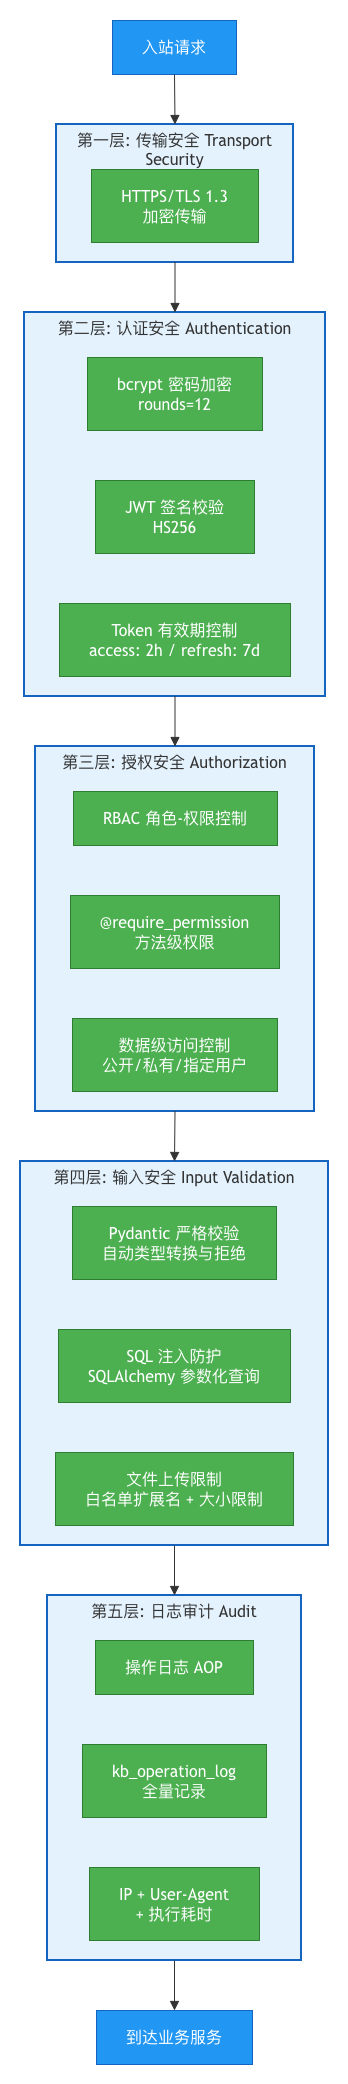
14.2 令牌安全设计
- 短期 access\_token:默认 2 小时有效期,降低泄露风险
- refresh\_token 隔离:仅用于签发新 access\_token,
type字段防止混淆 - 无 Token 黑名单:当前版本未实现 Redis 黑名单,登出后已签发 Token 在有效期内仍有效(生产环境建议配合短有效期使用)
附录
1 与 Java 版的差异对照
| 场景 | Java 版 | Python 版 |
|---|---|---|
| 架构风格 | 微服务(Spring Cloud + 独立部署) | 单体应用(apps/ 模块,单进程) |
| Controller 路由定义 | @RestController + @RequestMapping | FastAPI @router.get/post/put/delete |
| 请求校验 | @Valid + Bean Validation 注解 | Pydantic BaseModel 类型定义 |
| ORM 操作 | MyBatis-Plus BaseMapper<T> | SQLAlchemy select() + AsyncSession |
| 异步处理 | @Async / RabbitMQ Stream | asyncio.create_task / RabbitMQ(审核通知) |
| 服务发现 | Nacos + Feign | 无(模块间直接 Python 导入) |
| 网关 | Spring Cloud Gateway | 内嵌 ASGI 中间件(apps/gateway/) |
| 配置管理 | @ConfigurationProperties | pydantic-settings + .env |
| API 文档 | Knife4j (Swagger) | FastAPI 自动生成 /docs /redoc |
| 全局异常处理 | @RestControllerAdvice | FastAPI exception_handler 装饰器 |
| 中间件 | Filter / Interceptor | @app.middleware() / Depends() |
| AOP 编程 | @Aspect + @Around | FastAPI 中间件 + 装饰器 |
2 术语表
| 术语 | 全称 | 说明 |
|---|---|---|
| RAG | Retrieval-Augmented Generation | 检索增强生成:从知识库检索相关内容,注入 LLM 上下文 |
| KAG | Knowledge-Augmented Generation | 知识增强生成:从知识图谱中检索实体关系,与 RAG 融合 |
| RRF | Reciprocal Rank Fusion | 倒数排名融合:融合向量检索和 BM25 检索结果的排序算法 |
| Snowflake | Snowflake ID | Twitter 雪花算法:分布式唯一 ID 生成方案 |
| RBAC | Role-Based Access Control | 基于角色的访问控制 |
| JWT | JSON Web Token | 无状态身份令牌 |
| SSE | Server-Sent Events | 服务器推送事件,用于流式输出 |
| HNSW | Hierarchical Navigable Small World | 分层导航小世界:高性能近似最近邻搜索算法 |
| ASGI | Asynchronous Server Gateway Interface | 异步服务器网关接口,Python 异步 Web 标准 |
| BGE-M3 | BAAI General Embedding - Multilingual | 智源研究院多语言通用 Embedding 模型,1024维 |
