前言
这是一套以 Gin + GORM + CloudWeGo Eino 为核心的企业级知识库后端。
系统采用“单进程、多业务模块、多数据基础设施”的模块化单体架构,在保持 Java 版 /api/** 接口兼容的同时,原生实现文档、文件、搜索、知识图谱、RAG、KAG、AI 写作与实时通知能力。
一、架构目标
Go 后端的设计目标不只是“用 Go 重写 Java”,而是同时满足以下约束:
| 目标 | 设计手段 |
|---|---|
| 前端零改造 | 保持 Java 版接口路径、DTO、Result、分页结构一致 |
| 单进程部署 | 一个 Gin 进程承载多个业务域 |
| 业务边界清晰 | internal/modules 按领域拆分 |
| 数据隔离 | 7 个 MySQL 库 + Mongo/ES/Neo4j/RustFS 各司其职 |
| AI 可编排 | Eino Chain + ReAct Agent + Tool |
| 企业级权限 | JWT、RBAC、团队空间、文档 ACL |
| 故障可降级 | 模型、搜索、图谱、文件服务异常时不阻断全部业务 |
| 可观测 | TraceID、访问日志、业务日志、任务进度 |
| 云原生交付 | 配置化、单二进制、可容器化;有状态任务后续外置 |
1.1 当前工程事实
以下数据来自当前代码与路由清单:
| 指标 | 当前值 |
|---|---|
| Go 非测试源码 | 110 个文件,约 21,700 行 |
| Go 测试文件 | 24 个 |
/api/** 业务路由 | 286 |
| 总路由数(含 health/WebSocket) | 289 |
| MySQL 业务库 | 7 |
| AI 技术框架 | CloudWeGo Eino |
| 主要 AI 接口 | 41 个 /api/ai/** 路由 |
二、系统上下文
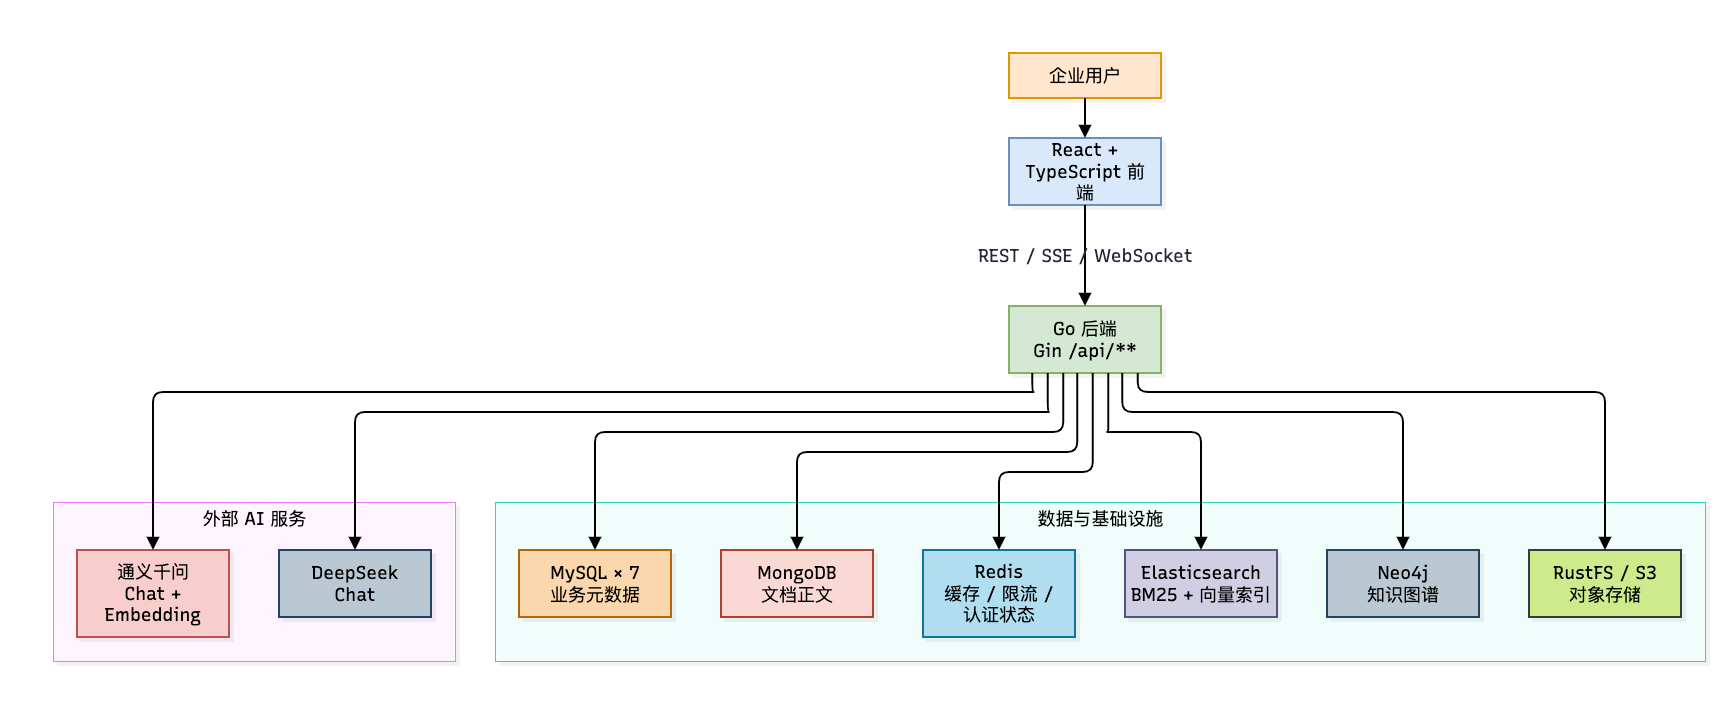
系统对外的核心入口是一个统一 Go API 服务。
React 前端不感知业务模块在进程内如何拆分,只依赖稳定的 /api/** 契约。
2.1 架构风格
项目采用模块化单体:
- 一次部署一个 Go 进程。
- 模块边界在代码层和数据库访问层体现。
- 各业务模块共享鉴权、日志、配置和基础设施客户端。
- 未来可将
internal/modules/*按边界拆成独立服务。
这种选择适合知识库当前的负载形态:内部系统并发不高,但数据存储和 AI 链路复杂。单进程可以减少服务治理、网络调用、部署和排障成本。
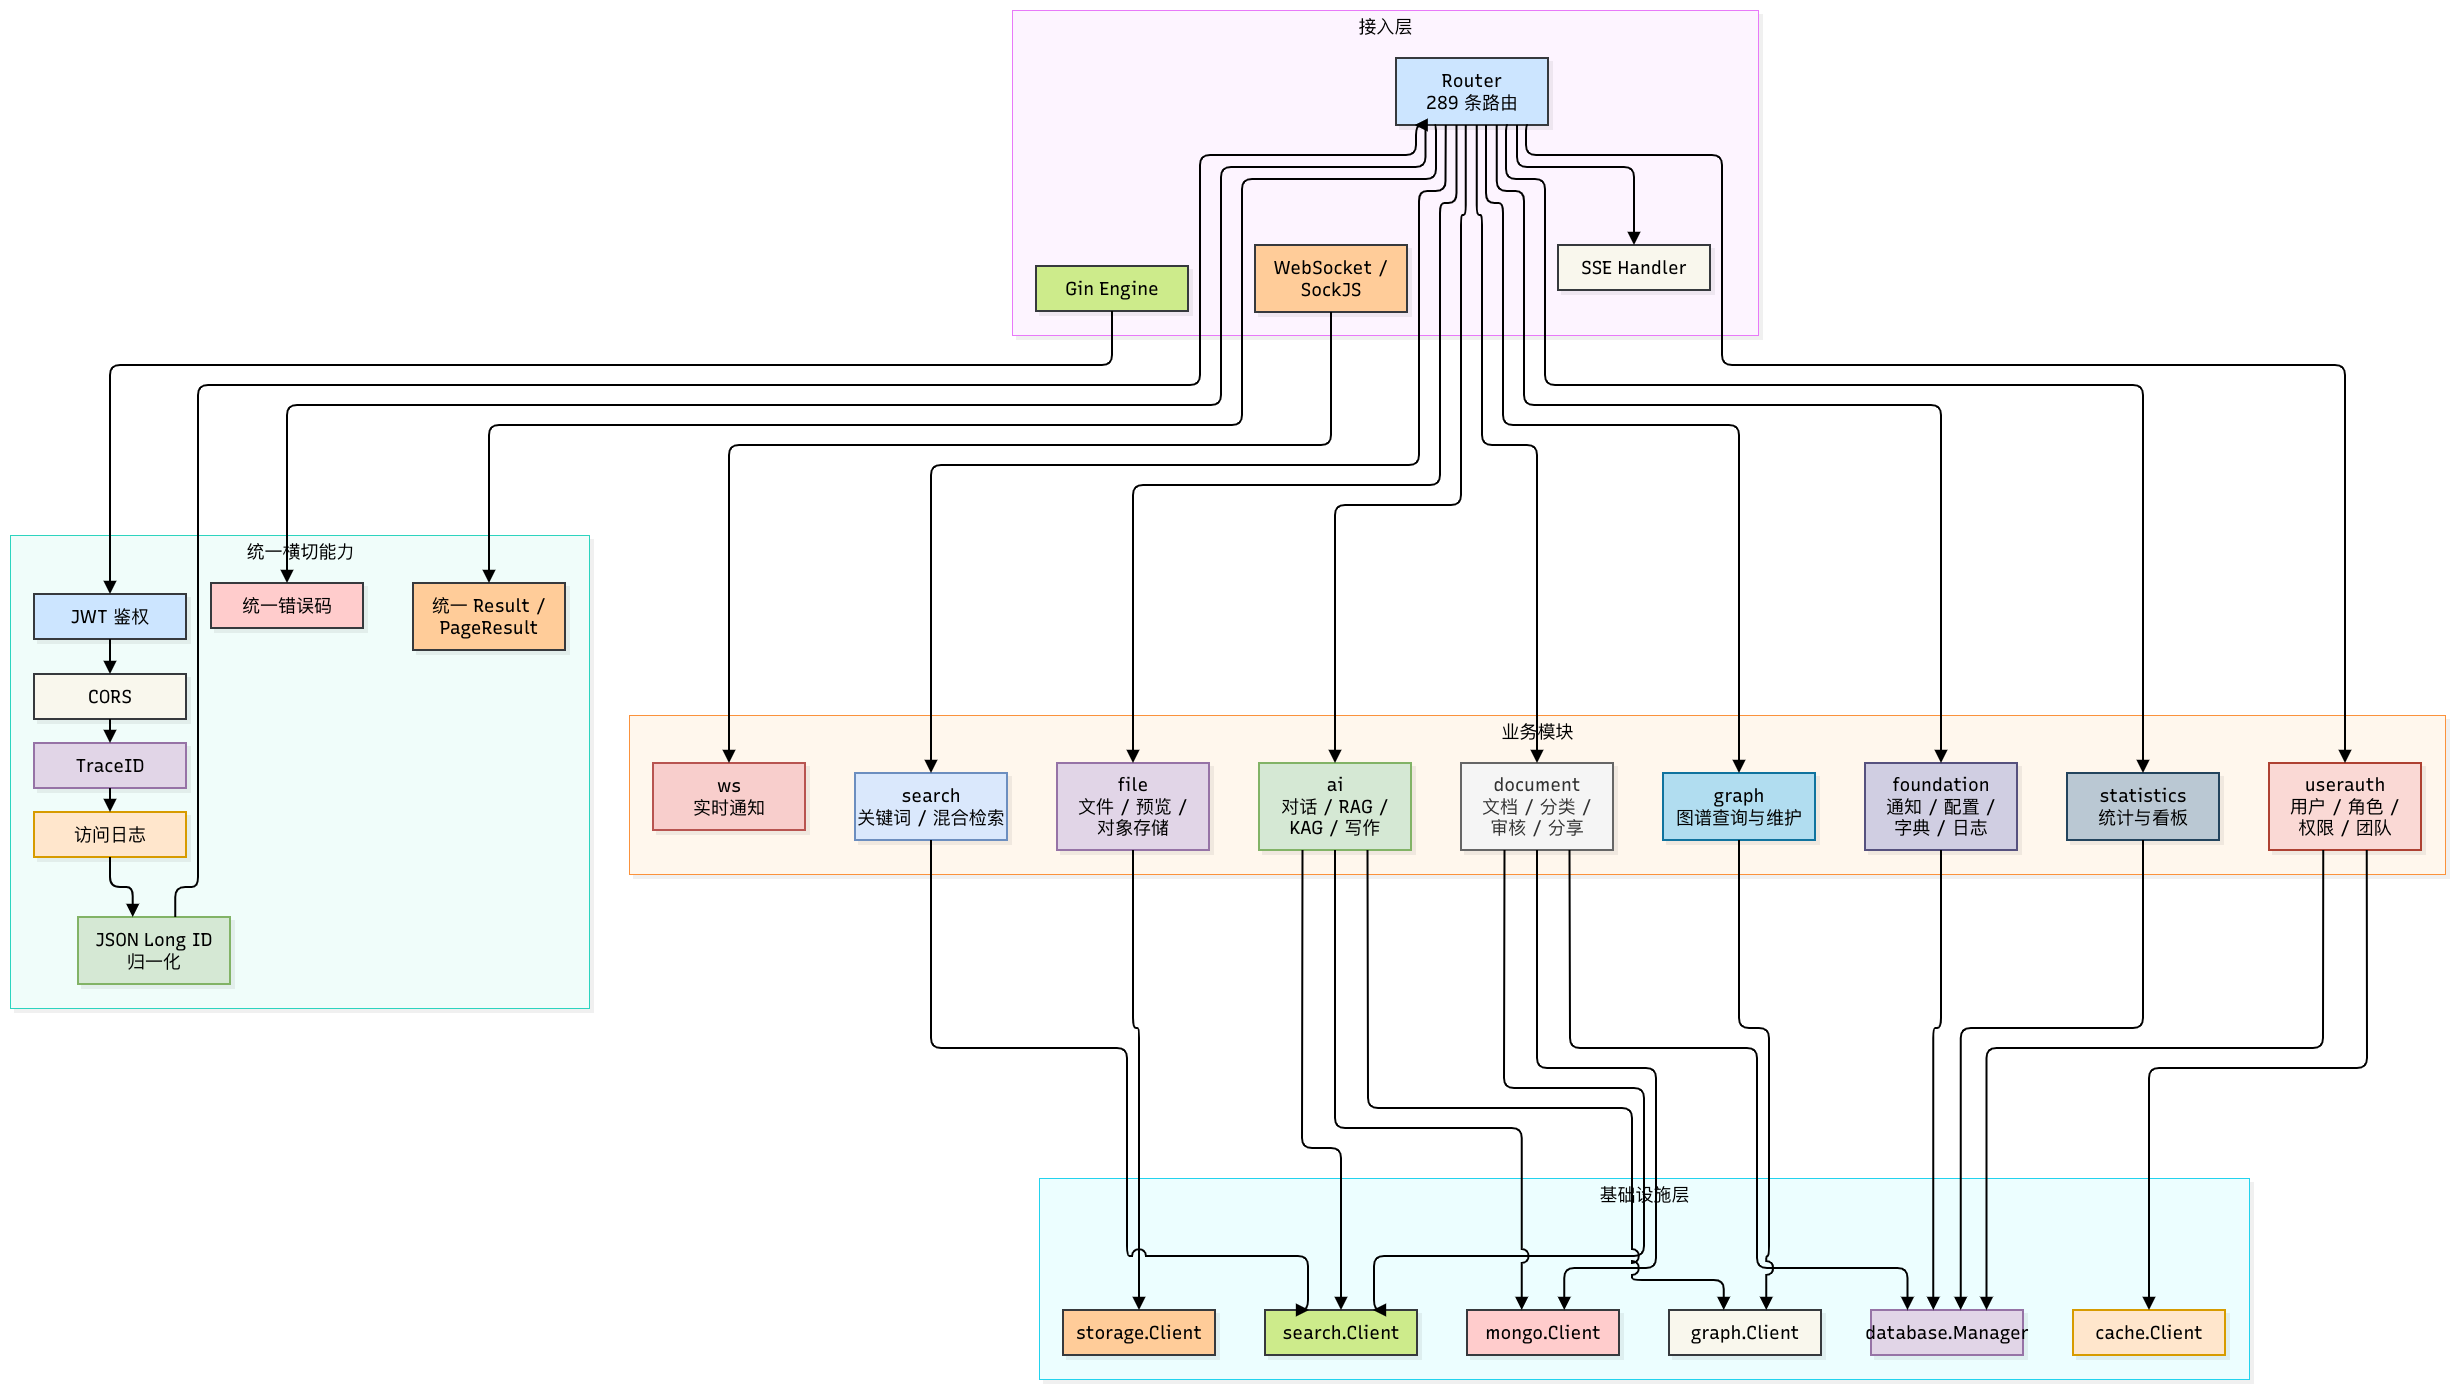
三、总体逻辑架构
3.1 模块职责
| 模块 | 核心职责 | 主要依赖 |
|---|---|---|
userauth | 登录、JWT、用户、角色、权限、团队空间 | MySQL、Redis |
document | 文档 CRUD、分类、标签、审核、版本、分享、访问历史 | MySQL、Mongo、ES |
file | 文件上传、下载、预览、文件分类 | MySQL、RustFS |
foundation | 通知、配置、字典、操作日志 | MySQL |
search | 关键词搜索、搜索历史、混合搜索 | Elasticsearch |
statistics | 文档、用户、分类、热门内容统计 | MySQL、Redis |
graph | 节点、边、路径、社区、图谱维护 | Neo4j |
ai | 对话、RAG、KAG、文档处理、AI 写作 | Eino、ES、Neo4j、Mongo |
ws | WebSocket 通知推送 | 进程内连接管理 |
四、代码分层
knowledge-base-go/
├── cmd/
│   ├── server/
│   │   └── main.go                 # 配置、依赖装配、启动、优雅退出
│   └── routedump/
│       └── main.go                 # 路由清单导出
│
├── internal/
│   ├── config/                     # YAML + 环境变量
│   ├── infra/                      # 外部基础设施客户端
│   │   ├── database/               # 7 个 GORM 连接
│   │   ├── cache/                  # Redis
│   │   ├── search/                 # Elasticsearch
│   │   ├── graph/                  # Neo4j
│   │   ├── mongo/                  # MongoDB
│   │   ├── storage/                # RustFS / S3
│   │   ├── mq/                     # RabbitMQ 预留
│   │   └── nacos/                  # Nacos 可选
│   ├── middleware/                 # 鉴权、日志、TraceID、限流、ID 归一化
│   ├── modules/                    # 业务领域
│   │   ├── userauth/
│   │   ├── document/
│   │   ├── file/
│   │   ├── foundation/
│   │   ├── search/
│   │   ├── statistics/
│   │   ├── graph/
│   │   ├── ai/
│   │   └── ws/
│   ├── pkg/                        # Result、错误码、JWT、Logger、ID、上下文
│   └── router/                     # 路由注册和模块装配
│
├── docs/
├── docker-compose.local.yml
├── .env / .env.example
└── run.sh / run.bat
4.1 依赖方向
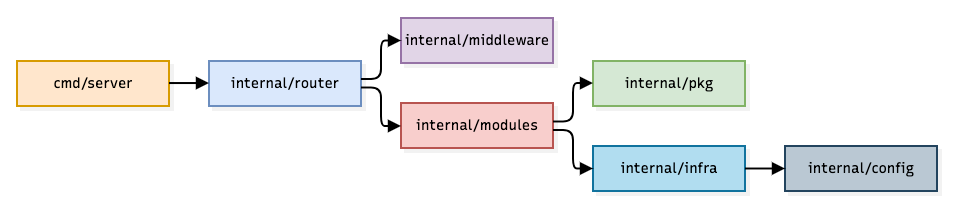
约束原则:
cmd只负责装配,不写业务逻辑。router只做路由和依赖绑定。modules负责业务规则。infra封装外部系统,避免业务模块直接管理底层连接。pkg放跨模块基础能力。
五、请求处理链路
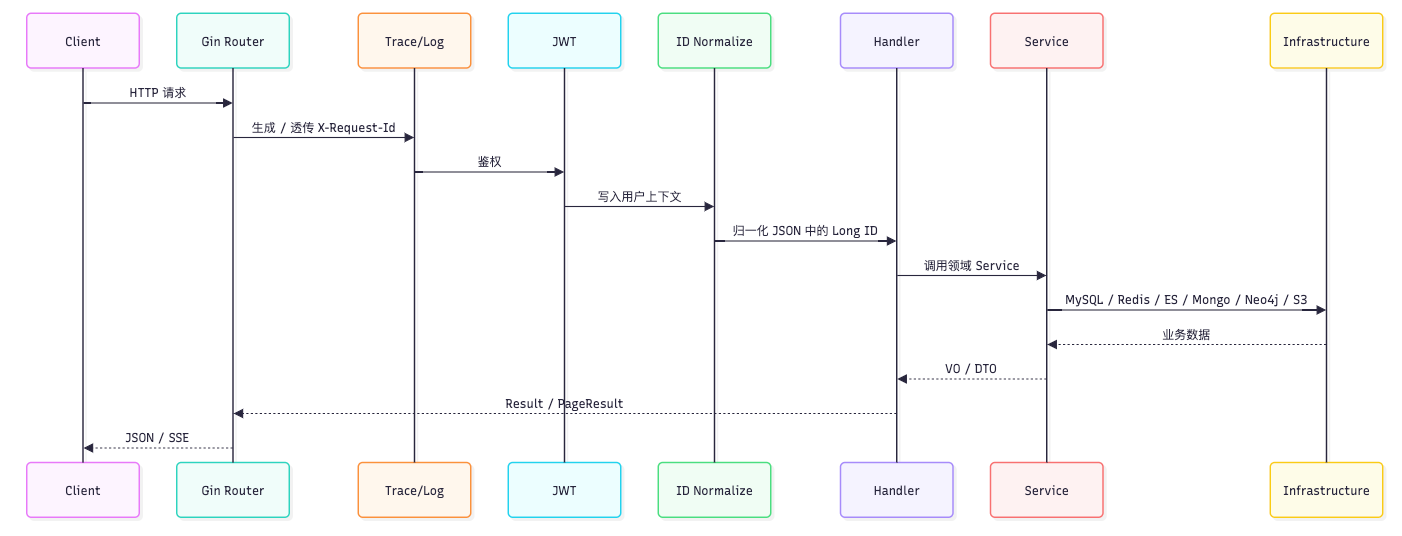
5.1 中间件链
当前 Gin 中间件顺序:
Recovery
  → CORS
  → TraceID
  → AccessLog
  → NormalizeJSONIDs
  → JWTAuth
  → Handler
关键设计:
TraceID从X-Request-Id沿用或自动生成,并写回响应头。JWTAuth白名单包括登录、健康检查、公开文档分享等。NormalizeJSONIDs解决 JavaScript 雪花 ID 精度问题:响应输出字符串,请求侧自动还原为数字。- 统一
Result结构和业务错误码,保持与 Java 前端契约一致。
六、数据架构
6.1 数据存储职责
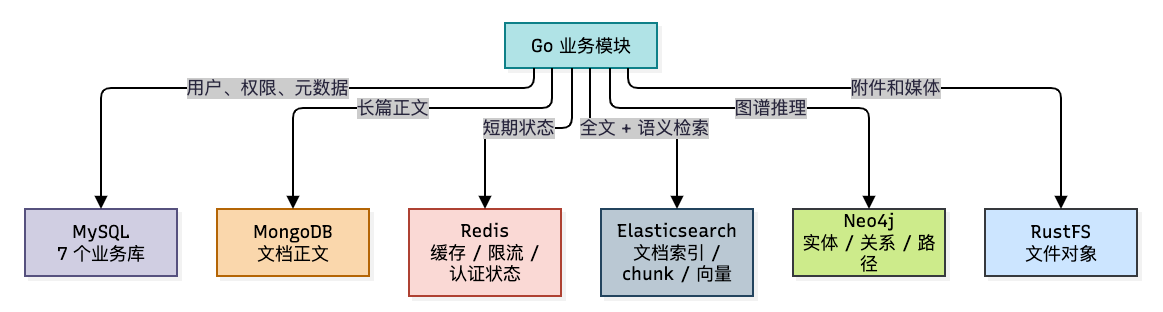
| 存储 | 保存内容 |
|---|---|
kb_user | 用户、角色、权限、团队 |
kb_document | 文档元数据、分类、评论、审核、版本、分享、访问记录、自动保存快照 |
kb_file | 文件元数据和文件分类 |
kb_foundation | 通知、系统配置、字典、操作日志 |
kb_search | 搜索历史 |
kb_statistics | 文档、用户、评论统计 |
kb_ai | 会话、消息、AI 反馈 |
| MongoDB | Markdown 文档正文 |
| Elasticsearch | 文档全文索引、RAG chunk、BM25 与向量字段 |
| Neo4j | KnowledgeDocument、DocumentChunk、KnowledgeEntity 和关系 |
| Redis | JWT 黑名单、登录失败计数、缓存、限流 |
| RustFS | 文件、图片、PDF、音视频对象 |
6.2 MySQL 与 MongoDB 分离
文档没有把长正文直接塞进 MySQL 列表行:
MySQL kb_document
  ├── title / summary / author / status
  ├── category_id / team_id / tags
  ├── view_count / like_count / comment_count
  └── content_id ───────────────┐
                                ▼
                       MongoDB document_content
                       ├── document_id
                       ├── content
                       └── updated_at
优势:
- 文档列表查询不需要读取大字段。
- 正文更新与元数据更新解耦。
- RAG 分块时按需读取 Mongo 正文。
- Mongo 不可用时,列表和元数据仍可降级服务。
- 自动保存历史仍保存在 MySQL
kb_document_autosave_history,与正文当前版本分开管理。
6.3 多库连接管理
Java 版由多个微服务分别持有数据源。Go 版由 database.Manager 同时管理 7 个 GORM 连接:
dbMgr.User()
dbMgr.Document()
dbMgr.File()
dbMgr.Foundation()
dbMgr.Search()
dbMgr.Statistics()
dbMgr.AI()
所有连接使用统一 MySQL 配置、连接池参数和 SingularTable 命名策略,保证表名与 Java 版一致。
七、权限架构
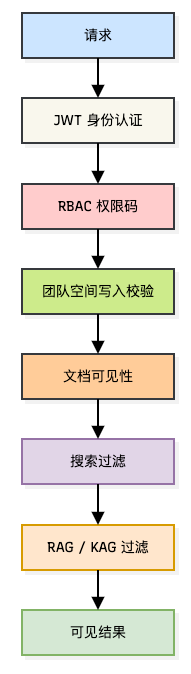
企业知识库的权限不是只放在 Controller 上。
当前系统有多层控制:
7.1 认证
- JWT HS512,与 Java 版 Token 互通。
- Access Token + Refresh Token。
- Token 黑名单处理主动退出。
- BCrypt 用户密码。
- 登录失败次数与账号锁定。
7.2 RBAC
User → UserRole → Role → RolePermission → Permission权限码同时覆盖菜单、按钮、API 和页面模块。
7.3 团队空间
- 用户可属于多个团队。
- 新建文档必须选择当前用户直属团队。
- 新建和自动保存时校验团队成员关系。
- 文档
team_id用于右侧团队空间筛选。
7.4 文档级权限
列表、详情、搜索、RAG、KAG 均要考虑:
可见 =
  管理员
  或 当前用户是作者
  或 文档已发布且公开
检索侧 ACL 解析失败时采用 fail-closed:返回空结果,不返回可能越权的知识。
八、AI 架构
AI 模块位于 internal/modules/ai,核心由 Eino、Elasticsearch、Neo4j、MongoDB 和 Qwen/DeepSeek 组成。
8.1 AI 分层
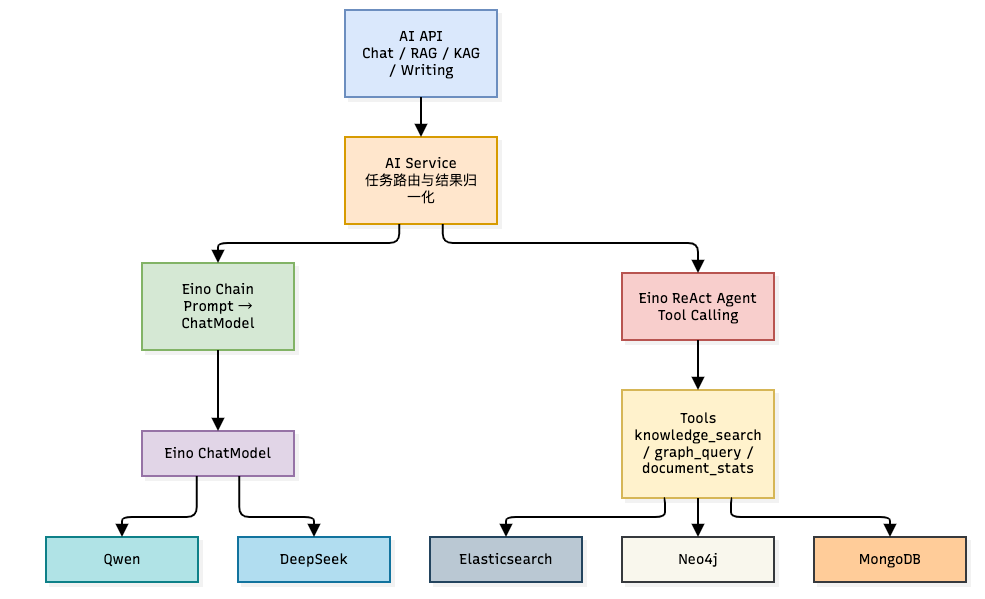
8.2 Eino 的作用
项目不是直接散落调用模型 HTTP,而是通过 Eino 抽象:
model.ChatModel:统一非流式与流式模型调用。schema.Message:统一消息结构。compose.Chain:把 Prompt Template 和 ChatModel 串成可执行链。flow/agent/react.Agent:支持模型自主选择工具并多轮执行。components/tool.BaseTool:把知识检索、图谱查询和统计能力工具化。
8.3 当前聊天主链路
当前 /api/ai/chat 和 /api/ai/chat/stream 主要由请求开关决定执行路径:
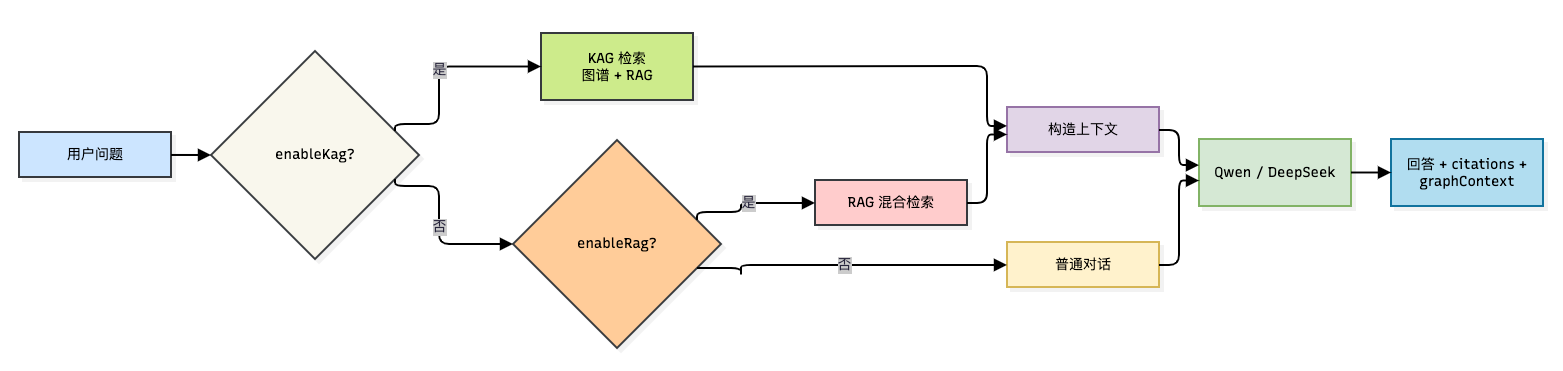
架构边界:agent.go已经实现 Eino ReAct Agent、Tool Calling 和三个工具,但当前聊天主链路仍以确定性 KAG/RAG 分支为主,尚未默认调用AgentChat。因此当前生产路径应表述为“确定性 Agentic RAG 工作流 + 可接入 ReAct Agent”。
九、RAG 检索架构
9.1 数据入库
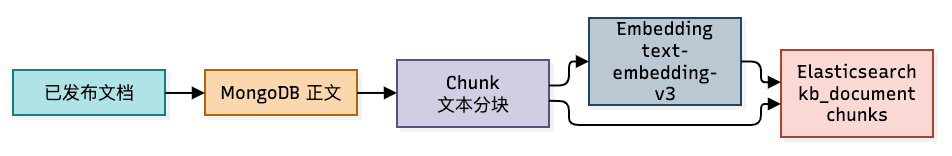
分块结果同时保留:
chunk_id
document_id
document_title
heading
content
chunk_index
total_chunks
embedding
publish_time
metadata
9.2 查询
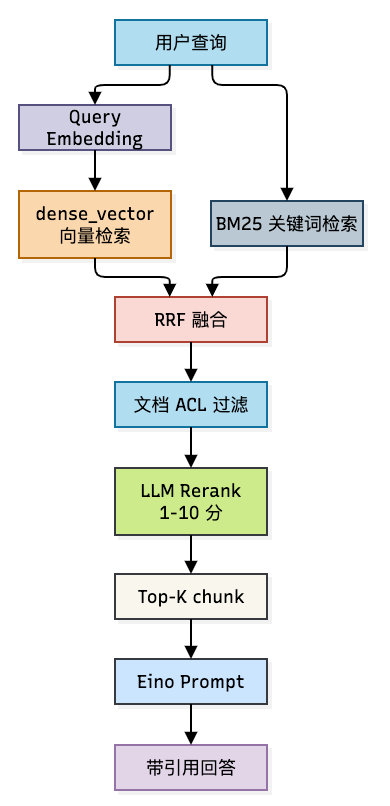
设计要点:
- BM25 与向量检索并行执行。
- 两路先各取更多候选,再按排名做 RRF 融合。
- 默认 RRF 常量
k=60。 - 向量与关键词默认权重由请求控制,常见策略是语义优先。
- Rerank 失败时自动回退为 RRF Top-K。
- 最终回答带
citations,前端可展示来源。
十、KAG 图谱架构
10.1 建图
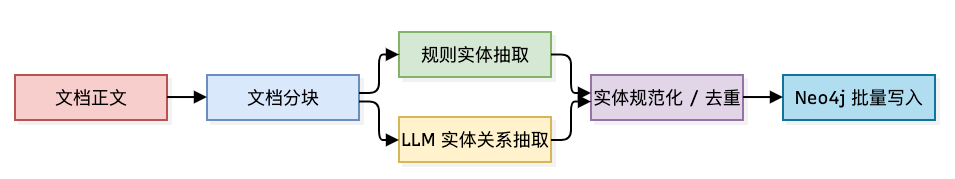
Neo4j 主要模型:
KnowledgeDocument
  └── HAS_CHUNK → DocumentChunk
                     └── MENTIONS → KnowledgeEntity
KnowledgeEntity
  ├── DEPENDS_ON
  ├── USES
  ├── CONFIGURES
  ├── HAS_PART
  └── RELATED_TO
10.2 图谱推理
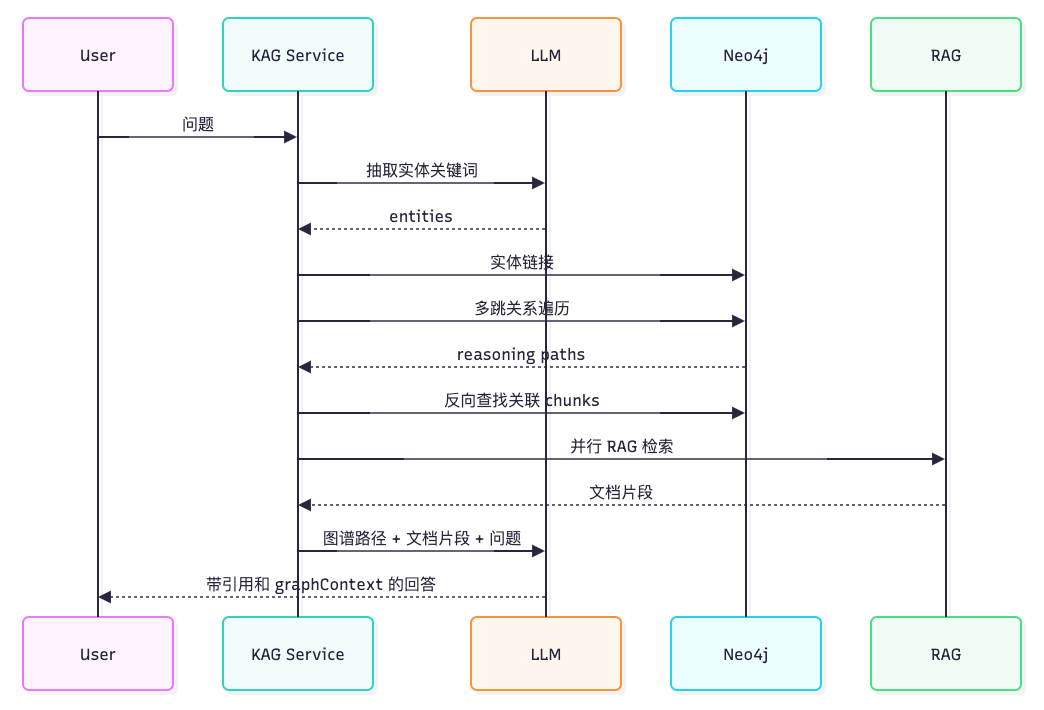
KAG 的价值是补足 RAG 对“实体关系、依赖、上下游、技术对比”等结构化问题的能力。
十一、Agent 模块现状
11.1 已实现部分
internal/modules/ai/agent.go 已包含:
- Eino
react.NewAgent ToolCallingModelMaxStep=12- 系统 Prompt Modifier
- 非流式
agent.Generate - 流式
agent.Stream
11.2 工具
| Tool | 输入 | 能力 |
|---|---|---|
knowledge_search | query, top_k | 检索知识库 chunk |
graph_query | keyword | 获取实体和推理路径 |
document_stats | 无 | 查询文档总量和发布量 |
11.3 当前边界
已有:Agent 基础设施
已有:Tool 实现
已有:Agent 测试
未接入:/ai/chat 默认路由
当前主路径使用确定性的 RAG/KAG 工作流,便于:
- 控制调用成本。
- 保证回答契约稳定。
- 避免模型随意调用高风险工具。
- 更容易调试、复现和审计。
后续可将 EnableKag 分支升级为 Agent 模式,或在普通对话中增加自动 Intent Router。
十二、异步与实时架构
12.1 SSE 流式
AI 流式接口使用原生 Gin Handler,不走统一 JSON Result 包装:
event: message
data: token

event: done
data: {conversationId, messageId, content, tokens}

event: error
data: error-message
流式处理解决了:
- 长文本等待时间。
- 首字延迟。
- 前端逐字渲染。
- 工具调用阶段空 content 分片过滤。
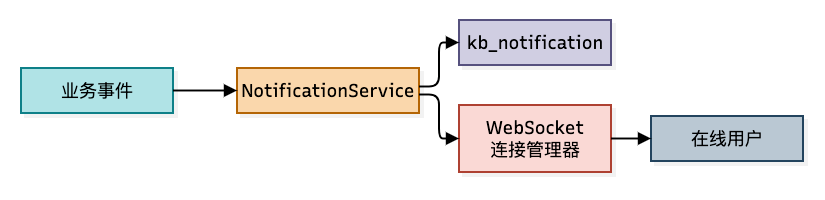
12.2 WebSocket 通知
审核、评论、点赞和系统消息通过站内信 + WebSocket 推送:
12.3 后台任务
- 文档发布后异步触发 RAG 索引。
- 文档发布后异步触发 KAG 建图。
- 批量 RAG/KAG 重建。
- Neo4j 批量写入和并发限制。
- RAG 任务进度写进程内状态,后续可迁移 Redis/消息队列。
十三、可观测性架构
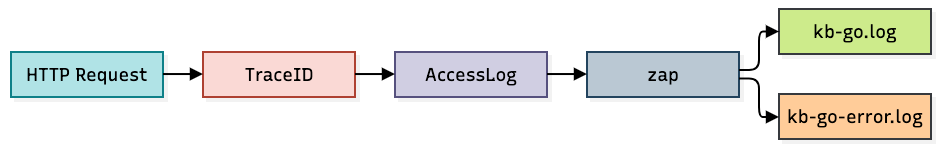
日志包含:
- TID
- HTTP 方法和路径
- 查询参数
- 客户端 IP
- 响应状态
- 耗时
- 用户 ID
- 请求摘要
- 响应摘要
AI 日志额外记录:
- provider / model
- token usage
- 检索 chunk 数量
- 是否启用 RAG/KAG
- graph entity 和 reasoning path 数量
- SSE 错误和完成事件
十四、部署架构
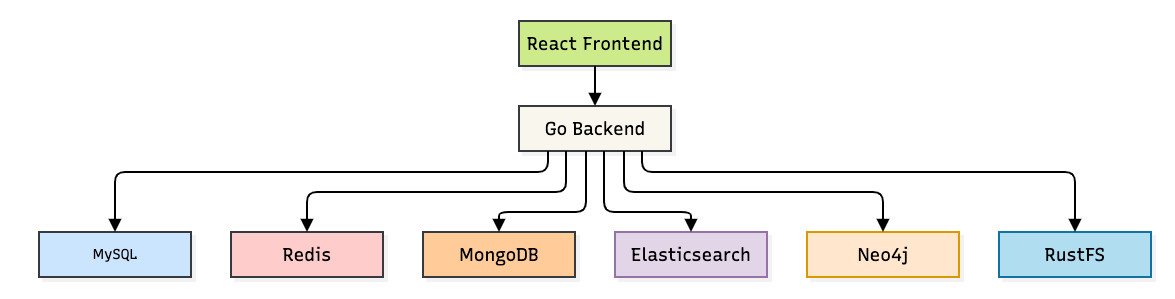
14.1 单实例
14.2 多实例演进
多实例部署前需要处理:
- RAG 任务进度:从进程内迁移 Redis/MySQL。
- WebSocket 广播:引入 Redis Pub/Sub 或消息队列。
- SSE 连接:网关支持长连接和超时配置。
- 限流:Redis 全局限流。
- 文件上传:统一 RustFS,不依赖本地磁盘。
十五、关键设计取舍
15.1 为什么使用模块化单体
| 维度 | 模块化单体 | 微服务 |
|---|---|---|
| 部署 | 简单,一个二进制 | 多服务编排 |
| 排障 | 一个进程、一份主日志 | 跨服务链路 |
| 内部调用 | 直接函数调用 | 网络 + 序列化 |
| 独立扩容 | 较弱 | 强 |
| 适合场景 | 中小规模企业知识库 | 大规模、团队独立发布 |
当前选择单体的原因:
- 内部知识库请求量通常不是主要瓶颈。
- AI 链路大量依赖外部模型和检索服务。
- 统一进程更容易保证权限和事务边界。
- Java 版已经验证了微服务架构,Go 版承担另一条工程路线。
15.2 为什么 MySQL + Mongo 分离
- MySQL 负责稳定结构和关系查询。
- Mongo 负责长正文和正文更新。
- MySQL 负责自动保存历史、版本和业务元数据。
- 避免 MySQL 大字段拖慢列表查询。
- 保留 Java 版数据模型,后端可切换。
15.3 为什么 ES 同时做 BM25 和向量
- 一个索引同时保存文本和 embedding。
- 过滤、权限、分页、标题、章节元数据可以在同一查询里处理。
- 避免在早期规模下引入第二套向量数据库。
15.4 为什么保留 Python 转发
复杂文档解析或 PDF 排版仍可能需要 Python 能力。Go 路由可以按配置转发到 Python,不影响同一套 API 契约。
十六、当前架构边界
16.1 已知限制
- RAG 重建进度主要保存在进程内,多实例需持久化。
- ReAct Agent 已实现但未接入默认聊天主链路。
- RabbitMQ 客户端已有,但大部分异步任务仍由 goroutine 执行。
- HLS 视频转码和视频缩略图仍未实现。
- 知识图谱构建依赖 Neo4j 和 LLM 质量。
十七、总结
Go 版的企业智能知识库采用“一个进程、多个领域模块、多种数据基础设施”的架构:
- Gin 提供统一 API 和中间件链。
- 业务按
userauth / document / file / foundation / search / statistics / graph / ai拆分。 - MySQL 保存业务元数据,MongoDB 保存正文,ES 负责检索,Neo4j 负责图谱,RustFS 保存文件。
- RAG 使用 BM25 + 向量 + RRF + Rerank。
- KAG 使用实体抽取 + 实体链接 + 多跳遍历 + 文档片段融合。
- Eino 提供 Chain、ReAct Agent 和 Tool 抽象。
- JWT、RBAC、团队空间和文档 ACL 构成多层权限体系。
- 单体进程降低部署复杂度,同时保留按模块拆分演进的路径。
这套架构的核心不是堆技术,而是让企业知识库中的“知识生产、检索、推理、生成、权限和运维”形成一条可解释、可降级、可持续演进的工程链路。
