一、项目概述
企业智能知识库 Go 后端用于解决企业内部“知识分散、检索困难、文档权限复杂、AI 答案缺少依据”等问题,提供从知识生产到智能消费的完整闭环:
文档创建 / 导入
    → 分类、标签、团队空间管理
    → 审核、版本、分享、收藏、评论
    → Elasticsearch 全文检索
    → RAG 检索增强问答
    → Neo4j 知识图谱与 KAG 推理
    → 统计分析与运营决策
它不是一套简化的 Demo,而是一套接口契约、业务规则、数据模型和基础设施均按企业系统方式设计的实现。
1.1 项目定位
| 维度 | 说明 |
|---|---|
| 项目类型 | 企业级智能知识管理平台后端 |
| 核心语言 | Go 1.26 |
| Web 框架 | Gin |
| 架构模式 | 模块化单体,按业务域拆分内部模块 |
| 对外接口 | RESTful API + SSE 流式接口 + WebSocket |
| 数据库 | MySQL 多库 + MongoDB + Redis + Elasticsearch + Neo4j |
| 文件存储 | RustFS,使用 S3 兼容协议 |
| 大模型框架 | CloudWeGo Eino |
| AI 模型 | 通义千问 Qwen / DeepSeek |
| 向量模型 | text-embedding-v3,默认 1024 维 |
| 与 Java 关系 | API 路径、请求参数、响应结构和核心业务语义保持兼容 |
| 与前端关系 | 不修改 React 前端即可替换 Java 后端运行 |
1.2 当前工程规模
以下数据来自当前工作区快照:
| 指标 | 数量 |
|---|---|
| Go 源码文件 | 110 |
| 非测试源码行数 | 约 21,700 行 |
| Go 测试文件 | 24 |
| 测试代码行数 | 约 1,749 行 |
/api/** 业务路由 | 286 |
| 路由清单总数(含健康检查、WebSocket) | 289 |
| 逻辑业务模块 | 8 个核心模块 + WebSocket 通知模块 |
| MySQL 业务库 | 7 个 |
| 主要外部基础设施 | MongoDB / Redis / Elasticsearch / Neo4j / RustFS |
1.3 为什么选择 Go
| 目标 | Go 实现的优势 |
|---|---|
| 降低部署复杂度 | 编译为单二进制,无 JVM、Python 虚拟环境依赖 |
| 降低资源占用 | 相比完整微服务 JVM 栈,容器镜像和常驻内存更小 |
| 提高并发吞吐 | goroutine 适合 SSE、文件流、检索聚合和异步任务 |
| 保持接口兼容 | 同一前端可直接切换后端,不需要改造页面和请求协议 |
| 简化工程交付 | 单体进程内按模块隔离,部署和排障链路更短 |
| 支持云原生 | 单进程、无状态、易容器化,可平滑扩容 |
Go 版不是 Java 版的“接口壳”,文档解析、PDF 生成、RAG 分块检索、Eino Chain/Agent、知识图谱构建等均在 Go 侧实现。
二、技术栈
2.1 Web 与工程基础
| 层次 | 技术 |
|---|---|
| Web 框架 | Gin |
| ORM | GORM |
| 参数校验 | go-playground/validator + Gin Binding |
| 配置管理 | YAML + .env + 环境变量覆盖 |
| JWT | golang-jwt/v5,HS512 |
| 主键生成 | Snowflake 雪花 ID |
| 日志 | zap + lumberjack |
| 测试 | Go testing |
2.2 数据与基础设施
| 组件 | 选型 | 用途 |
|---|---|---|
| MySQL | GORM + go-sql-driver/mysql | 用户、文档元数据、文件、统计、AI 会话等 7 个业务库 |
| MongoDB | mongo-driver | 文档正文、自动保存历史 |
| Redis | go-redis/v9 | 缓存、登录锁定、Token 黑名单、限流 |
| Elasticsearch | go-elasticsearch/v8 | 全文检索、BM25、向量索引、RAG 分块 |
| Neo4j | neo4j-go-driver/v5 | 实体、关系、路径和知识图谱查询 |
| RustFS | AWS SDK for Go v2 / S3 | 文档、附件、图片、PDF 等对象存储 |
| RabbitMQ | amqp091-go | 预留异步消息基础设施 |
| Nacos | 轻量 REST 客户端 | 可选配置中心接入 |
2.3 AI 与检索技术
| 能力 | 技术 |
|---|---|
| 大模型编排 | CloudWeGo Eino |
| 模型组件 | eino-ext/components/model/openai |
| 非流式生成 | Eino ChatModel.Generate |
| 流式生成 | Eino ChatModel.Stream + StreamReader |
| 知识库问答链 | Eino compose.Chain + Prompt Template |
| 图谱推理 Agent | Eino ReAct Agent + Tool Calling |
| 对话模型 | qwen-max / deepseek-chat |
| Embedding | text-embedding-v3 |
| 关键词检索 | Elasticsearch BM25 |
| 向量检索 | Elasticsearch dense vector / kNN |
| 混合检索 | BM25 + 向量检索 + RRF 融合 |
| 重排序 | LLM Relevance Rerank |
| 知识图谱 | Neo4j + 规则/LLM 实体关系抽取 |
2.4 可观测性与兼容性
| 能力 | 实现 |
|---|---|
| Request ID | TraceID 中间件 |
| 请求日志 | 全局访问日志,记录 TID、方法、路径、状态、耗时、用户 |
| 业务日志 | zap 控制台 + 普通日志文件 + 错误日志文件 |
| Long 精度 | JSON ID 规范化中间件,将 Java Long 风格 ID 统一为字符串 |
| 统一响应 | {code, message, data, timestamp} |
| 分页响应 | {current, size, total, pages, records} |
三、系统架构
3.1 总体架构
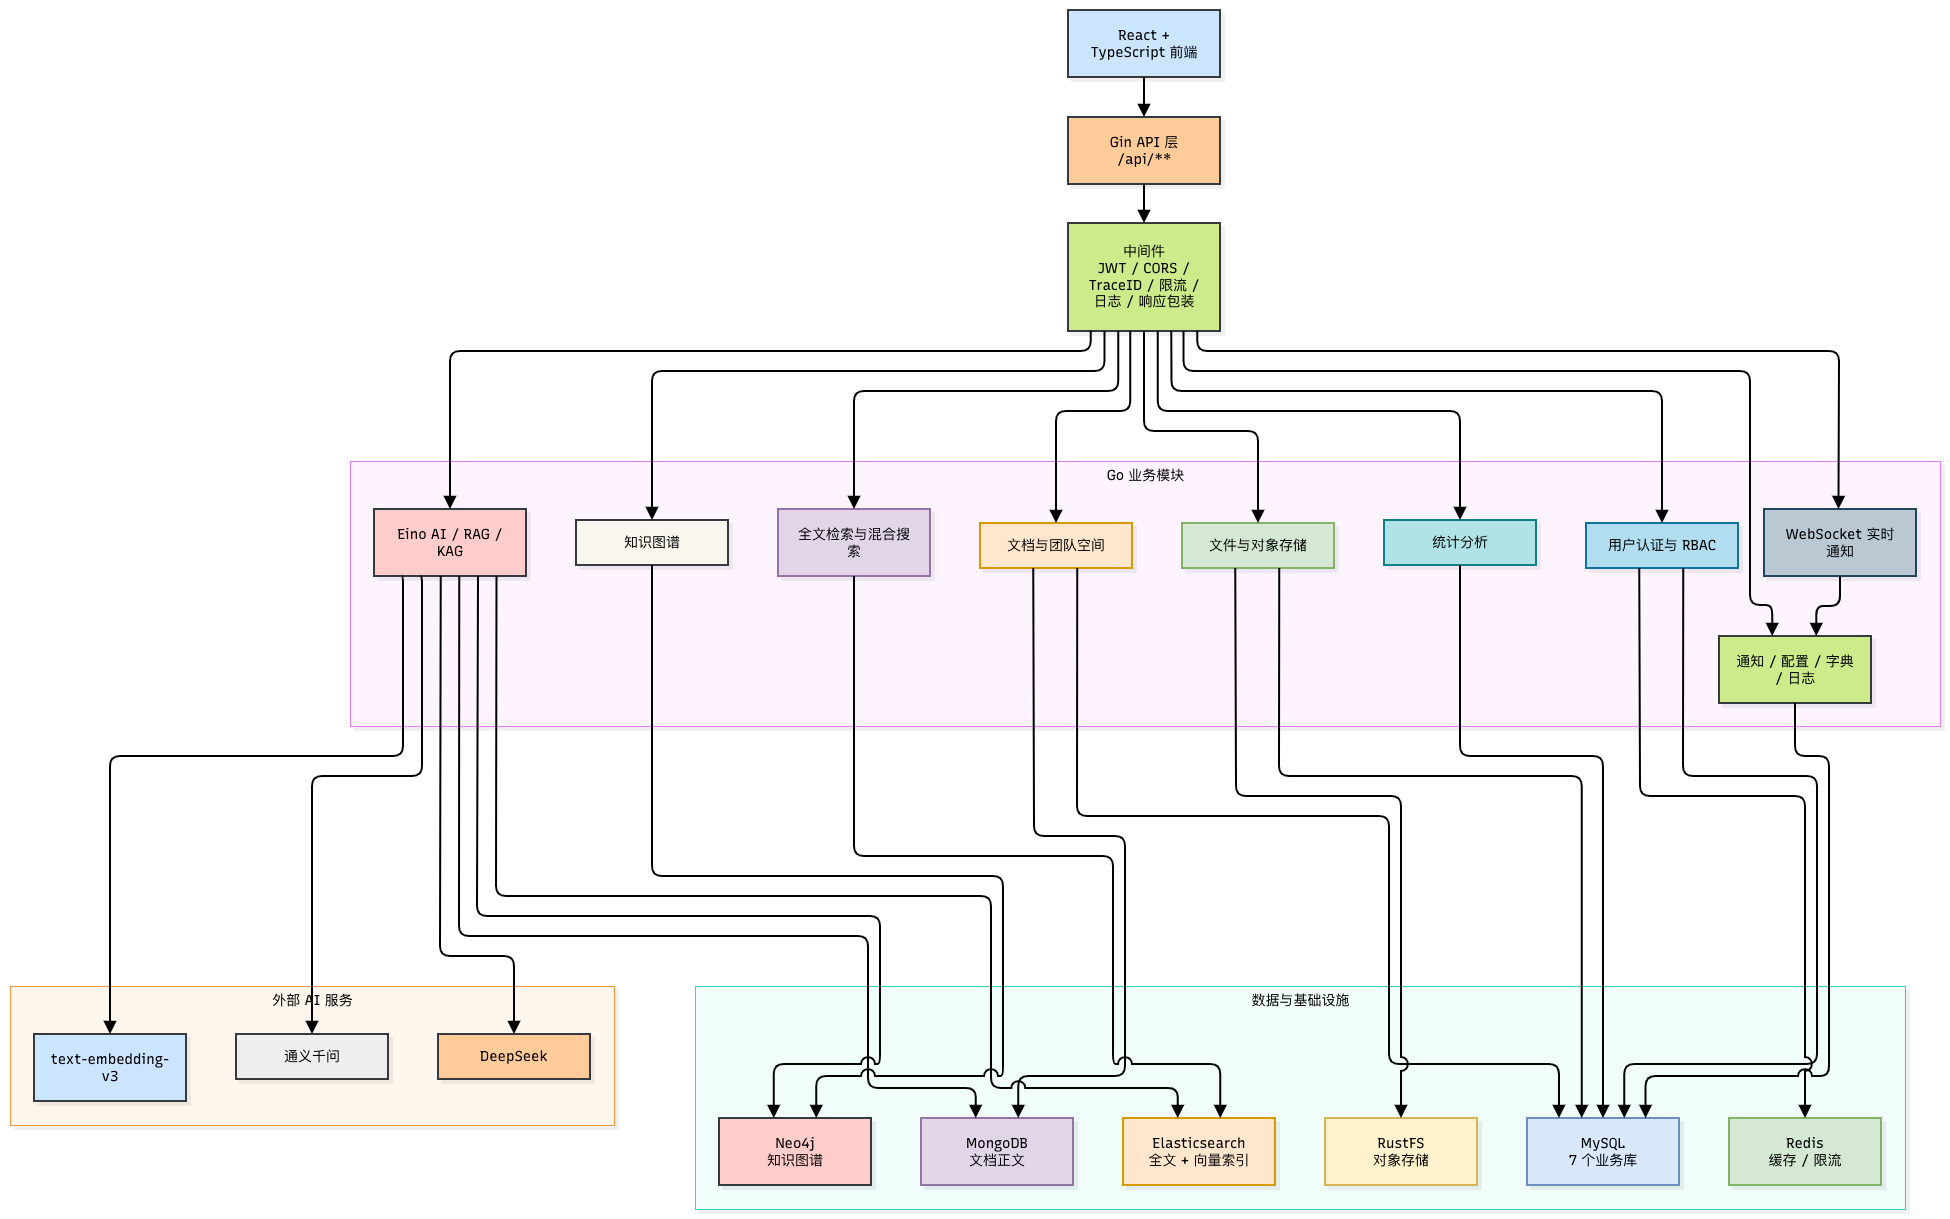
3.2 请求处理链路
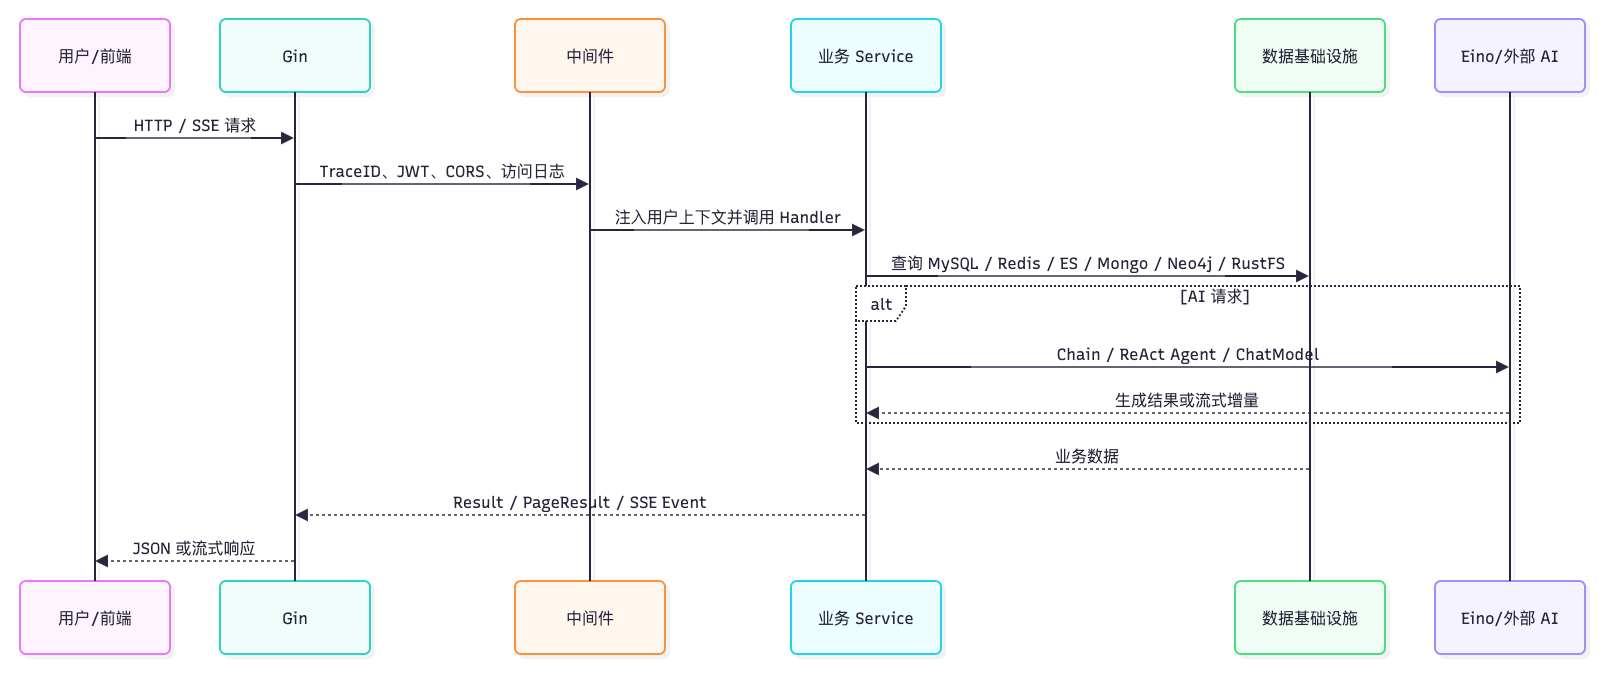
3.3 代码分层
cmd/
  server/          服务入口、依赖装配、优雅退出
  routedump/       路由清单导出工具

internal/
  config/          YAML、环境变量和默认配置
  infra/           MySQL、Redis、ES、Neo4j、Mongo、MQ、RustFS、Nacos
  middleware/      JWT、CORS、日志、TraceID、限流、统一响应、JSON ID
  modules/         业务模块
    userauth/      用户、角色、权限、团队空间
    document/      文档、分类、评论、标签、审核、版本、分享
    file/          文件上传、下载、预览、文件分类
    foundation/    配置、字典、通知、操作日志
    search/        关键词检索、混合搜索、搜索历史
    statistics/    文档、用户、分类、热门内容统计
    graph/         Neo4j 图谱查询与图谱维护
    ai/            Eino、对话、RAG、KAG、AI 写作
    ws/            WebSocket / SockJS 通知
  pkg/             Result、错误码、JWT、Logger、Snowflake、上下文
  router/          路由注册和模块装配
四、核心业务能力
4.1 用户认证与权限
包含完整的用户、角色、权限和团队空间能力:
- 用户名密码登录、JWT 签发、Token 校验、刷新和退出。
- BCrypt 密码哈希,与 Java BCrypt 数据兼容。
- 登录失败次数限制和账号临时锁定。
- 用户、角色、权限的增删改查与角色授权。
用户 → 角色 → 权限RBAC 模型。- 团队空间创建、成员管理、树形结构和当前用户团队查询。
- 文档创建、自动保存和变更团队时校验用户是否属于目标团队。
团队空间采用“一篇文档归属一个团队、一个用户可以加入多个团队”的模型。
4.2 文档中心
文档模块是系统的核心业务域,包含:
- 文档创建、修改、删除、分页和详情。
- 草稿、待审核、已发布、已归档状态流转。
- 自动保存、自动恢复、自动保存历史快照。
- Markdown 正文与 MongoDB 分离存储。
- 分类树、分类移动、标签和团队空间归属。
- 文档审核、通过、驳回、审核历史与待审核列表。
- 版本创建、对比、查看和恢复。
- 文档点赞、取消点赞、收藏、取消收藏。
- 评论、回复、评论点赞与评论删除。
- 文档分享、有效期、访问密码、访问次数限制。
- 最近访问记录、浏览历史和相邻文档。
- 文档级权限校验与团队空间写入校验。
4.3 文件管理
- 单文件上传、批量上传和外部 URL 转存。
- 文件列表、详情、重命名、删除和批量删除。
- 文件分类、分类树、统计和权限设置。
- RustFS 对象存储,兼容 S3 协议。
- 文件下载、流式预览和 HTTP Range。
- PDF、DOCX、XLSX、PPTX 和文本类文件解析。
- 原生 Go PDF 生成、下载和批量 ZIP 导出。
- PPT/PPTX 幻灯片预览可依赖 LibreOffice + Poppler。
- HLS 转码和视频缩略图目前保留明确的“暂未实现”语义,与 Java 版行为一致。
4.4 搜索与混合检索
搜索模块支持:
- Elasticsearch 标题、摘要、正文多字段检索。
- 标题权重高于摘要和正文。
- 关键词高亮和摘要片段。
- 搜索建议、热搜、个人搜索历史。
- 文档级权限过滤,防止私有文档通过搜索泄露。
- 混合智能搜索:BM25 + 向量 kNN + RRF 融合。
- RAG 服务不可用时降级为关键词检索。
4.5 知识图谱
知识图谱基于 Neo4j:
- 节点、关系、实体搜索和关系查询。
- 可变深度路径分析。
- 社区检测、图谱总览和社区列表。
- 按文档删除图谱、孤立节点清理。
- 图谱构建支持单文档、批量和全量任务。
- KAG 检索对不可见文档执行权限过滤。
4.6 通知与基础服务
- 站内通知分页、未读数、全部已读和单条已读。
- 审核提交、审核通过、审核驳回等业务通知。
- WebSocket / SockJS 实时消息推送。
- 通知模板管理和测试发送。
- 字典、字典项、系统配置、分类配置。
- 设置聚合、系统状态、缓存清理和配置备份。
- 操作日志查询、统计和按日期清理。
4.7 接口数量概览
| 路由前缀 | 当前路由数 |
|---|---|
/api/document/** | 99 |
/api/auth/** | 52 |
/api/ai/** | 41 |
/api/notifications/** | 14 |
/api/config/** | 12 |
/api/search/** | 11 |
/api/graph/** | 11 |
/api/file/** | 24 |
/api/statistics/** | 9 |
/api/dicts/** | 9 |
/api/logs/** | 4 |
合计 /api/** | 286 |
另有 /health 和 WebSocket 路由,路由清单总数为 289。
五、AI 能力设计
5.1 为什么使用 Eino
直接通过 HTTP 调用大模型只能完成“输入 Prompt、返回文本”。Eino 在此基础上提供了可组合、可测试、可演进的 AI 编排层:
- 统一
schema.Message和model.ChatModel抽象。 - 同一套业务代码可切换 Qwen、DeepSeek 或其他 OpenAI 兼容模型。
- 用
compose.Chain固化 Prompt、检索上下文和模型节点。 - 用 ReAct Agent 把知识库检索、图谱查询、统计查询变成模型可调用工具。
- 非流式与流式接口共享同一模型抽象。
5.2 三种 AI 对话模式
| 前端模式 | Eino 能力 | 行为 |
|---|---|---|
| 普通对话 | ChatModel.Generate / Stream | 直接由大模型回答 |
| 知识库增强 | Chain + RAG | 先检索文档片段,注入 Prompt,再生成带引用的答案 |
| 图谱推理 | ReAct Agent + Tools | 模型自主决定是否调用知识检索、图谱查询、文档统计工具 |
5.3 RAG 流水线

关键实现:
- 文档按语义边界切分后写入 Elasticsearch。
- BM25 与向量检索并行执行。
- RRF 默认常量
k=60,保留关键词路和向量路原始得分。 - LLM 重排按 1–10 分评分,失败时自动继承 RRF 排序。
- Prompt 明确要求“没有依据时不要编造”,并输出
[1]、[2]引用。 - 检索前计算当前用户不可见文档集,私有文档无法进入 RAG 上下文。
5.4 KAG 与图谱推理
KAG 在图谱增强链路上完成:
- 从问题中提取关键词或实体。
- 在 Neo4j 中匹配实体和关系。
- 进行多跳关系遍历。
- 找到关联文档片段。
- 将 RAG 片段、KAG 路径和用户问题融合后交给模型。
KAG 建图支持:
- 文档分块。
- 规则抽取和 LLM 增强抽取。
- Neo4j 批量
UNWIND写入。 - 文档级、并行 chunk 级和全局 LLM 并发控制。
- 单文档、批量和全量构建。
并发参数示例:
KAG_BUILD_DOC_CONCURRENCY=4
KAG_CHUNK_CONCURRENCY=4
KAG_EXTRACTION_CONCURRENCY=8
Eino Agent 可用工具:
| 工具 | 用途 |
|---|---|
knowledge_search | 检索企业知识库文档片段 |
graph_query | 查询实体、关系和推理路径 |
document_stats | 查询文档总数和已发布数量 |
5.5 AI 文档与写作
AI 模块同时提供:
- 文档摘要、大纲、扩写和优化。
- AI 写作生成、扩写、优化和续写。
- 非流式与 SSE 流式版本。
- 会话创建、历史消息、会话删除。
- 快捷问题、AI 建议、点赞/点踩反馈。
- RAG 按文档、批量和全量重建索引。
- RAG 任务进度查询。
六、数据架构
6.1 数据存储职责
| 存储 | 数据 |
|---|---|
MySQL kb_user | 用户、角色、权限、团队空间 |
MySQL kb_document | 文档元数据、分类、评论、标签、审核、版本、分享、访问历史 |
MySQL kb_file | 文件元数据和文件分类 |
MySQL kb_foundation | 通知、配置、字典、操作日志 |
MySQL kb_search | 搜索历史和搜索统计 |
MySQL kb_statistics | 文档、用户、评论统计 |
MySQL kb_ai | AI 会话、消息、反馈 |
| MongoDB | 文档 Markdown 正文、自动保存历史 |
| Elasticsearch | 文档全文索引、RAG chunk、BM25 和向量索引 |
| Neo4j | 知识实体、关系、文档分块和推理路径 |
| Redis | 缓存、登录失败计数、Token 黑名单、限流 |
| RustFS | 文档附件、图片、PDF 和流式媒体 |
6.2 MySQL 与 MongoDB 分离
文档元数据和正文分开存储:
- MySQL 保存标题、摘要、作者、状态、分类、团队、统计等结构化字段。
- MongoDB 保存 Markdown 正文和自动保存快照。
- MySQL 通过
content_id关联 MongoDB 内容。 - 文档列表查询不加载大段正文,避免 MySQL 行膨胀。
- 正文需要参与 RAG 时,再通过
ContentStore从 MongoDB 读取并分块。
6.3 权限设计
项目包含多层权限:
- 接口层:JWT 鉴权和权限码校验。
- 组织层:用户只能向自己所属团队空间创建文档。
- 文档层:已发布公开、本人文档或管理员可查看。
- 搜索层:排除当前用户不可见的私有文档。
- RAG/KAG 层:检索上下文同样执行文档级权限过滤。
文档权限解析失败时采用 fail-closed 策略:宁可返回空结果,也不返回可能越权的数据。
七、与 Java 后端的关系
7.1 一套前端,多套后端
前端只依赖稳定的 /api/** 接口:
React 前端
   ├── Java Spring Cloud 后端
   ├── Python FastAPI 后端
   └── Go Gin 后端
Go 版重点兼容以下契约:
| 兼容项 | 说明 |
|---|---|
| 接口路径 | /api/auth/**、/api/document/**、/api/file/**、/api/ai/** 等保持不变 |
| 请求字段 | 与 Java DTO 使用相同 camelCase 字段 |
| 响应结构 | Result 和 PageResult 保持一致 |
| Long ID | 统一以字符串输出,避免 JavaScript 精度丢失 |
| JWT | HS512,Token 可与 Java 端互通 |
| 数据表 | 使用同一套 MySQL 表结构和字段名 |
| 错误语义 | 外部调用 HTTP 200 + 业务错误码,保持前端处理方式一致 |
7.2 各实现定位
| 实现 | 主要定位 |
|---|---|
| Java Spring Cloud | 完整微服务治理、Spring 生态与组织级基础设施 |
| Python FastAPI | AI 实验、复杂 NLP 和快速扩展 AI 能力 |
| Go Gin | 单二进制、低资源、高并发,适合云原生部署和 Java 同构替换 |
八、安全与稳定性
8.1 鉴权与安全
- JWT HS512、Access Token 和 Refresh Token。
- BCrypt 密码哈希,兼容 Java 用户数据。
- Token 黑名单支持主动退出。
- 登录失败锁定。
- RBAC 权限码控制。
- 团队空间成员校验。
- 文档列表、详情、搜索、RAG 和 KAG 权限过滤。
- CORS 与统一鉴权白名单。
- 外部请求剥离伪造内部请求头。
8.2 稳定性设计
- MySQL、MongoDB、ES、Neo4j、RustFS 初始化失败时记录明确错误,路由仍可启动。
- Neo4j 不可用时自动不注册图谱工具,避免 Agent 调用不可用能力。
- RAG 混合检索失败时降级为关键词检索。
- 向量批次失败时逐条重试,避免单条异常中断整篇索引。
- 文档发布后的索引和 KAG 构建异步执行,不阻塞主请求。
- API 统一异常包装,避免 panic 直接暴露给调用方。
- 服务支持 SIGINT / SIGTERM 优雅退出并关闭数据库连接。
8.3 日志与排障
日志默认写入:
logs/kb-go/kb-go.log
logs/kb-go/kb-go-error.log
访问日志包含:
TID / HTTP Method / Path / Query / Client IP
Status / Duration / Response Size / User ID
Request Summary / Response Summary
这样可以快速定位一次请求在前端、网关、Go 后端和下游服务之间的执行过程。
九、运行与部署
9.1 环境要求
- Go 1.26+
- MySQL 8.0+
- Redis
- Elasticsearch 8
- MongoDB
- Neo4j 5
- RustFS 或兼容 S3 的对象存储
以下依赖按功能启用:
- Nacos:配置中心,可选。
- RabbitMQ:预留异步消息基础设施,可选。
- LibreOffice + Poppler:PPT/PPTX 幻灯片预览。
- Qwen / DeepSeek API Key:AI 能力。
- SMTP:邮件、激活和密码重置。
9.2 配置方式
配置优先级:
代码默认值 < YAML 配置文件 < .env < 运行环境变量首次运行:
cp .env.example .env敏感信息应只通过环境变量提供:
QWEN_API_KEY=
DEEPSEEK_API_KEY=
MAIL_USERNAME=
MAIL_PASSWORD=
JWT_SECRET=
.env.example 中不应填写真实生产密钥。
9.3 启动命令
# 编译
go build ./...

# 静态检查
go vet ./...

# 启动服务
go run ./cmd/server

# 打印路由清单
go run ./cmd/routedump
一键脚本:
./run.sh
./run.sh build
./run.sh route
Windows:
run.bat
run.bat build
run.bat route
默认端口为 8080,健康检查:
curl http://localhost:8080/health返回:
{"status":"UP"}如果与 Java 网关同时运行,可把 Go 服务切换到其他端口:
SERVER_PORT=18080 ./run.sh总结
企业智能知识库 Go 后端不是简单的语言翻译,而是一套与 Java 版保持业务契约一致、同时充分利用 Go 并发和部署优势的完整实现。
它具备以下特征:
- 统一 API:前端无需修改即可切换 Go 后端。
- 完整业务闭环:用户、团队、文档、文件、审核、搜索、统计、AI 和图谱齐备。
- 企业级权限:接口、组织、文档、搜索和 AI 检索多层校验。
- 原生 Go 能力:多格式解析、PDF 生成、文件流、RAG/KAG 和图谱构建。
- 现代 AI 编排:Eino Chain 与 ReAct Agent,而不是裸调模型接口。
- 云原生交付:单二进制、环境变量配置、结构化日志和可选基础设施降级。
对于希望降低 Java 微服务资源开销、保持现有前端和数据库不变,同时获得 Go 部署效率与 Eino AI 编排能力的企业,这套 Go 后端提供了一条可实际落地、可灰度迁移、可持续演进的技术路线。
