前言
最近挺多球友对Python版本的企业智能知识库系统挺感兴趣的,有些球友要用这个项目去面试。
接下来,给大家解析一下这个项目用到的技术亮点,希望对你会有所帮助。
一、为什么要有 Python 后端
企业智能知识库的第一版后端是 Java Spring Cloud 微服务架构,AI 侧通过 LangChain4j 编排模型、文档切分和检索增强生成。
为了验证技术方案的通用性、降低 AI 模块的实验成本,我们又实现了一套 FastAPI + Python 3.12 后端,与 Java 端的接口、数据库结构、检索参数一一对应。
两套后端不是简单的"翻译",而是各有分工:
| 维度 | Java 后端 | Python 后端 |
|---|---|---|
| 定位 | 生产级微服务,9 个独立服务 | 模块化单体,一个进程承载全部业务域 |
| Web 框架 | Spring Boot 3.2 | FastAPI(ASGI) |
| 数据库访问 | MyBatis Plus + 手写 XML | SQLAlchemy 2.0 Async + Alembic |
| AI 编排 | LangChain4j | LangChain(Python) |
| 检索存储 | Elasticsearch dense\_vector | Elasticsearch Async Client |
| 异步任务 | RabbitMQ + CompletableFuture | RabbitMQ + Celery |
| 流式输出 | SSE | SSE(异步生成器) |
| 响应模型 | Lombok + Jackson | Pydantic v2 |
一句话总结双后端策略:Java 验证"企业级工程化",Python 验证"AI 快速迭代"。业务接口两边保持同一套语义,谁更适合落地谁就上生产。
二、LangChain 在项目里的真实落点
很多教程喜欢"为了用而用"地把整条 RAG 流水线都塞进 LangChain,但本项目只引用了真正有增量价值的组件。查看 pyproject.toml:
langchain-text-splitters>=0.2      # 文档智能分块(已实际使用)
langchain-community>=0.2           # 社区集成(预留)
langchain-openai>=0.1 # OpenAI 兼容模型接入(预留)实际代码中,LangChain 的 RecursiveCharacterTextSplitter 承担了 RAG 的第一环——中文文档智能分块,其余环节(Embedding、向量检索、关键词检索、RRF 融合、LLM 重排、对话补全)由 async 原生客户端直连实现,理由见第七章《选型哲学》。
2.1 Python RAG 子系统结构
apps/ai/rag/
├── chunking_service.py      # ★ LangChain 文本分块(本节主角)
├── embedding_service.py     # 向量嵌入 + Redis 缓存 + 批量 + 降级
├── vector_index_service.py  # ES 索引管理 / kNN 向量检索 / BM25 关键词检索
├── rag_retrieval_service.py # 混合检索编排:kNN + BM25 → RRF → LLM 重排
├── rag_chat_service.py      # RAG 对话:Prompt 构建 / 记忆 / 引用 / SSE
├── models.py                # DocumentChunk / SearchResult / RAGResponse
└── routers/                 # FastAPI 路由层
2.2 核心分块代码
chunking_service.py 只做了三件事:**配置分割器 → 切文本 → 包一层带元数据的 **DocumentChunk。
from langchain_text_splitters import RecursiveCharacterTextSplitter

def _get_splitter(chunk_size: int = 512, overlap: int = 64):
    """按优先级依次尝试以下分隔符:
    \n\n(段落) -> \n(换行) -> 。(中文句号) -> .(英文句号)
    -> ;(中文分号) -> ; -> ,(中文逗号) -> , -> 空格 -> 单字符
    """
    return RecursiveCharacterTextSplitter(
        chunk_size=chunk_size,
        chunk_overlap=overlap,
        separators=["\n\n", "\n", "。", ".", ";", ";", ",", ",", " ", ""],
        length_function=len,
        is_separator_regex=False,
    )
chunk_text 负责真正的切分,并过滤掉空白块:
def chunk_text(text: str, chunk_size: int = 512, overlap: int = 64) -> List[str]:
    if not text or not text.strip():
        return []

    splitter = _get_splitter(chunk_size, overlap)
    chunks = splitter.split_text(text)

    result = [chunk.strip() for chunk in chunks if chunk.strip()]
    logger.debug(
        f"文本分块完成: 原文本长度={len(text)}, 分块数={len(result)}, "
        f"块大小={chunk_size}, 重叠={overlap}"
    )
    return result
chunk_document 则在每个块上附加文档级上下文(标题、章节、分块序号、总块数),这是检索结果"自包含"的关键:
def chunk_document(doc_id, content, chunk_size=512, overlap=64, extra_metadata=None):
    chunks = chunk_text(content, chunk_size, overlap)
    metadata = extra_metadata or {}

    document_title = metadata.pop("document_title", None)
    heading = metadata.pop("heading", None)
    publish_time = metadata.pop("publish_time", None)

    document_chunks = []
    for i, chunk_content in enumerate(chunks):
        chunk = DocumentChunk(
            doc_id=doc_id,
            chunk_id=f"{doc_id}_chunk_{i}",
            content=chunk_content,
            document_title=document_title,
            heading=heading,
            publish_time=publish_time,
            metadata={
                "doc_id": doc_id,
                "chunk_index": i,
                "total_chunks": len(chunks),
                "char_count": len(chunk_content),
                **metadata,
            },
        )
        document_chunks.append(chunk)
    return document_chunks
DocumentChunk 用 dataclass 建模(分块数据存在 ES,不落 MySQL),并内置 to_es_doc() 把对象转成 ES 文档:
@dataclass
class DocumentChunk:
    doc_id: int
    chunk_id: str                 # 唯一标识: "{doc_id}_chunk_{index}"
    content: str
    embedding: Optional[List[float]] = None    # 1024 维向量
    metadata: Dict[str, Any] = field(default_factory=dict)
    document_title: Optional[str] = None
    heading: Optional[str] = None
    publish_time: Optional[str] = None

    def to_es_doc(self) -> Dict[str, Any]:
        doc = {
            "doc_id": self.doc_id,
            "document_id": self.doc_id,
            "chunk_id": self.chunk_id,
            "content": self.content,
            "embedding": self.embedding,
            "metadata": self.metadata,
        }
        if self.document_title:
            doc["document_title"] = self.document_title
        if self.heading:
            doc["heading"] = self.heading
        if self.publish_time:
            doc["publish_time"] = self.publish_time
        return doc
三、LangChain 切分器凭什么"智能":递归分块原理
RecursiveCharacterTextSplitter 不是"数到 512 个字符就一刀切",而是一个递归降级的分隔符栈:它拿着有序分隔符列表,从最"大"的语义边界(段落)开始尝试切分;如果某一块仍然超过阈值,就用下一个更小的分隔符继续切,直到最小粒度(单字符)兜底。
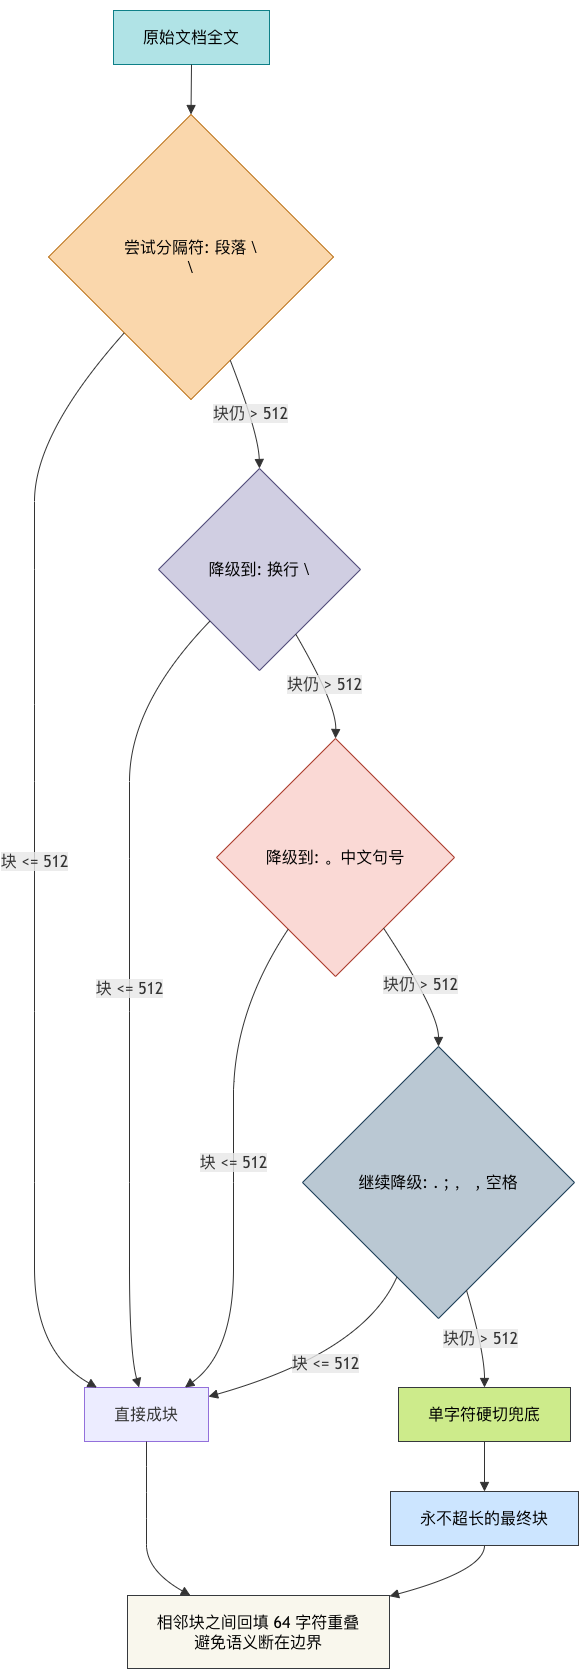
这套机制对中文尤其友好,因为中文的语义边界是"段落 > 句子 > 分句"而不是字符。
如果把分隔符列表顺序写反——先按逗号切,会把本来完整的一句话拆得稀碎,嵌入向量质量断崖式下跌。
3.1 中文分隔符的排序为什么重要
| 优先级 | 分隔符 | 语义粒度 | 实际效果 |
|---|---|---|---|
| 1 | \n\n | 段落 | 尊重 Markdown/自然段边界 |
| 2 | \n | 换行 | 代码块、列表项不被打散 |
| 3 | 。 | 中文句号 | 中文句级切分 |
| 4 | . | 英文句号 | 兼容英文/代码文档 |
| 5 | ; ; | 分号 | 长句内的并列分句 |
| 6 | , , | 逗号 | 实在超长时的次优边界 |
| 7 | 空格 | 单词边界 | 兜底 |
| 8 | 空字符串 | 单字符 | 最终保底,保证不超上限 |
3.2 重叠(overlap)解决了什么问题
一个完整的论点经常横跨两个块的切分点。如果没有重叠,第 N 块的向量"缺下半句",第 N+1 块"缺上半句",两边都不完整,检索召回和 LLM 理解都会打折。chunk_overlap=64 让相邻块共享边界上下文,用约 12.5% 的存储冗余换回明显的召回收益——这个比例正是业界推荐的 10%–20% 区间。
工程细节:LangChain 的RecursiveCharacterTextSplitter默认length_function=len,即按字符数而非 token 数计算块大小。本项目 512/64 是字符口径,与 Java 版"512 token ≈ 1024 字符 + 128 字符重叠"处于同一量级;若要严格按 token 切分,可替换为TokenTextSplitter并接入分词器,这就是下一阶段的优化点。
四、从"切好的块"到"可检索的向量":Embedding 与索引
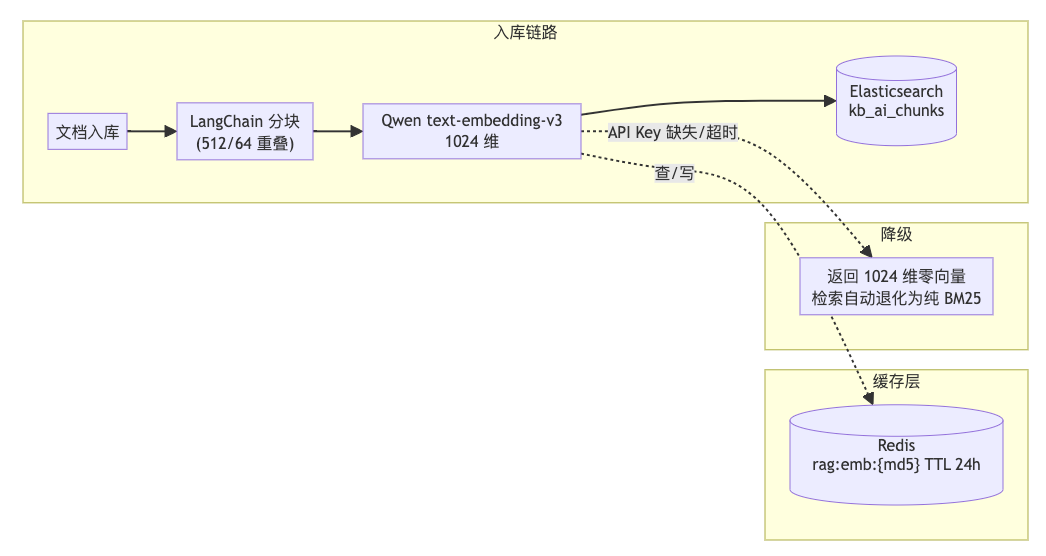
分块只是 RAG 的第一环,接下来经历 chunk → embedding → ES 三步:
4.1 Embedding 的三个工程化设计
- Redis 缓存命中优先:缓存 Key 为
rag:emb:+ 文本 MD5,TTL 24 小时。同一份文档反复入库、增量更新时相同块直接命中,批量场景可省掉大量 API 费用。
def _build_cache_key(text: str) -> str:
    return "rag:emb:" + hashlib.md5(text.encode("utf-8")).hexdigest()

async def _embed(text: str) -> List[float]:
    if not text:
        return _zero_vector()
    client, _ = await _get_embedding_client()
    if client is None:
        return _zero_vector()

    cache_key = _build_cache_key(text)
    cached = await _cache_get(cache_key)
    if cached is not None:
        return cached

    try:
        vector = await _call_embed_api(text)
        await _cache_set(cache_key, vector)
        return vector
    except Exception as e:
        logger.error("单条嵌入失败: {}", e)
return _zero_vector()- 零向量兜底而不是抛异常:Embedding 失败返回 1024 维全零向量,后续混合检索发现向量不可信时自动退化为纯 BM25,而不是让整条链路报 500。
- Redis 是可选依赖:
RedisManager获取失败就跳过缓存,符合 Java 端@Autowired(required=false)的"缓存坏了不拖垮主流程"思想。
4.2 ES 索引设计
ES 索引 kb_ai_chunks 的关键 mapping:
{
  "mappings": {
    "properties": {
      "chunk_id":    {"type": "keyword"},
      "content":     {"type": "text"},
      "embedding":   {"type": "dense_vector", "dims": 1024, "index": true, "similarity": "cosine"},
      "document_title": {"type": "text", "fields": {"keyword": {"type": "keyword", "ignore_above": 256}}},
      "heading":     {"type": "keyword"},
      "doc_id":      {"type": "long"},
      "metadata":    {"type": "object"}
    }
  }
}
content 走 text(支持 BM25 全文检索),embedding 走 dense\_vector(支持 kNN 语义检索),同一份块同时服务两种检索,这正是混合检索的地基。
五、在线问答:混合检索 → RRF 融合 → LLM 重排 → 生成
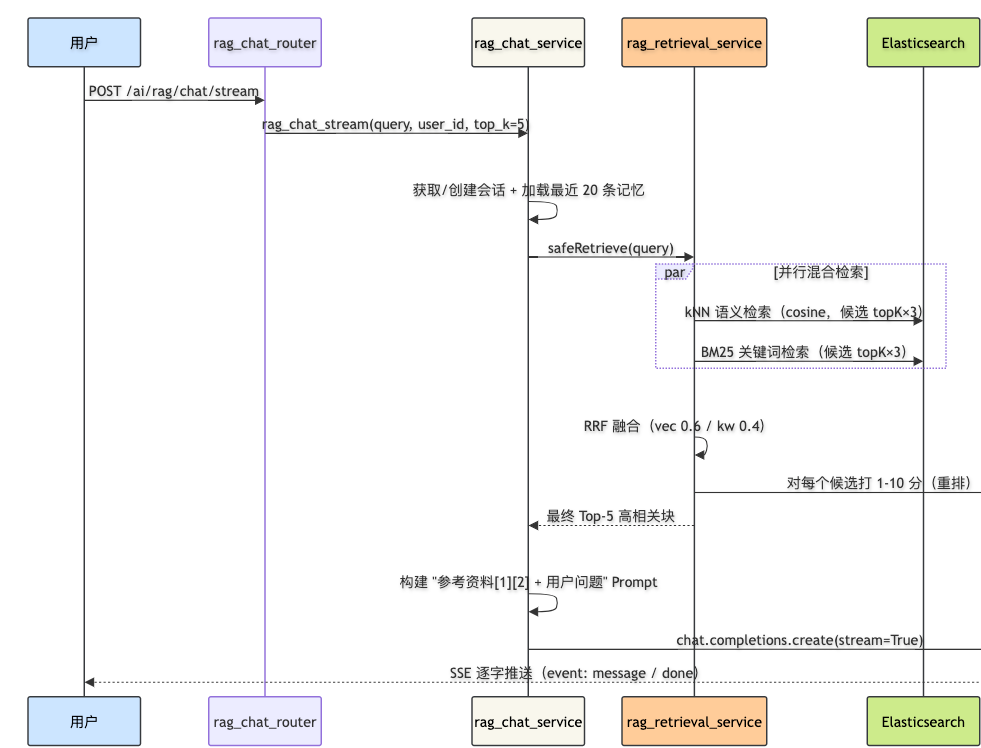
5.1 一次 RAG 问答的完整旅程
5.2 混合检索与 RRF 融合
向量检索能理解"同义词/语义相近",BM25 擅长"精确术语命中",两者互为补充。
Python 侧对每个榜单算倒数排名融合分:
RRF_score(d) = vec_weight / (k + rank_vec(d)) + kw_weight / (k + rank_kw(d))def _rrf_fusion(vec_results, kw_results, k=60, vec_weight=0.5, kw_weight=0.5):
scores = {}
for rank, item in enumerate(vec_results):
cid = item.get("chunk_id")
if cid not in scores:
scores[cid] = {**item, "rrf_score": 0.0}
scores[cid]["rrf_score"] += vec_weight / (k + rank + 1)
scores[cid]["vec_rank"] = rank + 1
scores[cid]["vector_score"] = float(item.get("score", 0))
for rank, item in enumerate(kw_results):
cid = item.get("chunk_id")
if cid not in scores:
scores[cid] = {**item, "rrf_score": 0.0}
scores[cid]["rrf_score"] += kw_weight / (k + rank + 1)
scores[cid]["kw_rank"] = rank + 1
scores[cid]["bm25_score"] = float(item.get("score", 0))
merged = sorted(scores.values(), key=lambda x: x["rrf_score"], reverse=True)
return merged工程细节:
- 融合时只依赖排名,不依赖原始分数,规避了 BM25 与 cosine 得分量纲不一致的问题;
- 每条结果同时保留
bm25_score/vector_score/vec_rank/kw_rank,方便日志排查和效果调优; hybrid_search()里语义权重默认 0.6、关键词 0.4(语义优先),而_rrf_fusion的可调参数让 A/B 实验不用改代码。
5.3 为什么不直接信任 RRF 的 Top-5
RRF 的排序是"关键词+语义"层面的,不一定"对回答问题最有帮助"。混合检索返回的候选会先经过一道 LLM 重排质检:用"搜索相关性评估专家"Prompt 让大模型对每个候选打 1–10 分,过滤低分块后只把高相关块送进生成阶段。
async def _rerank_with_llm(candidates, query, top_k):
    client, model = await AiChatService._get_llm_client("qwen")
    scored = []
    for candidate in candidates:
        prompt = _build_rerank_prompt(query, candidate.get("content", ""))
        response = await client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
            temperature=0,          # 评分要稳定,不开创造
            max_tokens=10,          # 只返回一个整数
        )
        score = _parse_rerank_score(response.choices[0].message.content or "")
        scored.append((candidate, score))
    scored.sort(key=lambda x: x[1], reverse=True)
    return [item for item, _ in scored[:top_k]]
重排 Prompt 写明了评分语义:"10 – 直接完美回答 / 7-9 – 高度相关 / 4-6 – 部分相关 / 1-3 – 基本无关";解析用 \b([1-9]|10)\b 正则,抽不出数字就回退为 5,防止一次打分异常拖垮整条链路。
5.4 Prompt 注入与防幻觉
Python 侧与 Java 保持同一套 Prompt 模板(=== 参考资料 === + === 用户问题 ===),核心约束只有一句话:参考资料没有的内容就明说答不了,绝不编造:
RAG_SYSTEM_PROMPT = """你是一个企业知识库助手。请仅根据以下参考资料回答用户的问题。
如果参考资料中没有相关信息,请说明【根据现有知识库暂时无法回答此问题】,绝对不要编造内容。
回答时,请在引用资料处的末尾标注引用编号,如 [1]、[2]。
回答应当专业、准确、简洁。"""
每个检索块会带上 来源文档 + 章节,LLM 被要求按 [1][2] 标注出处,回答后前端渲染引用面板,实现"有据可查"。
5.5 SSE 流式输出的两个细节
- 换行不能被吞:SSE 协议以换行分隔事件,模型吐出的正文里若含
\n,直接拼进data:会破坏事件流,所以要先转义:
escaped = delta.content.replace("\n", "\ndata: ")
yield f"event: message\ndata: {escaped}\n\n"- 雪花 ID 必须转字符串:Java 端 Snowflake ID 超过 JS
Number.MAX_SAFE_INTEGER,直接进 JSON 会丢精度,done事件统一把 ID 转str:
done_data = json.dumps({
    "conversationId": str(conversation_id),
    "messageId": str(ai_message_id),
    ...
}, ensure_ascii=False)
yield f"event: done\ndata: {done_data}\n\n"
六、重建索引:单文档同步链路 + Celery 异步化预留
apps/ai/rag/routers/rag_reindex_router.py 提供了完整可用的重建索引接口,当前实现为单文档同步链路(删除旧索引 → LangChain 分块 → Embedding → ES 批量写入),接口直接返回 chunks_created / chunks_indexed 统计:
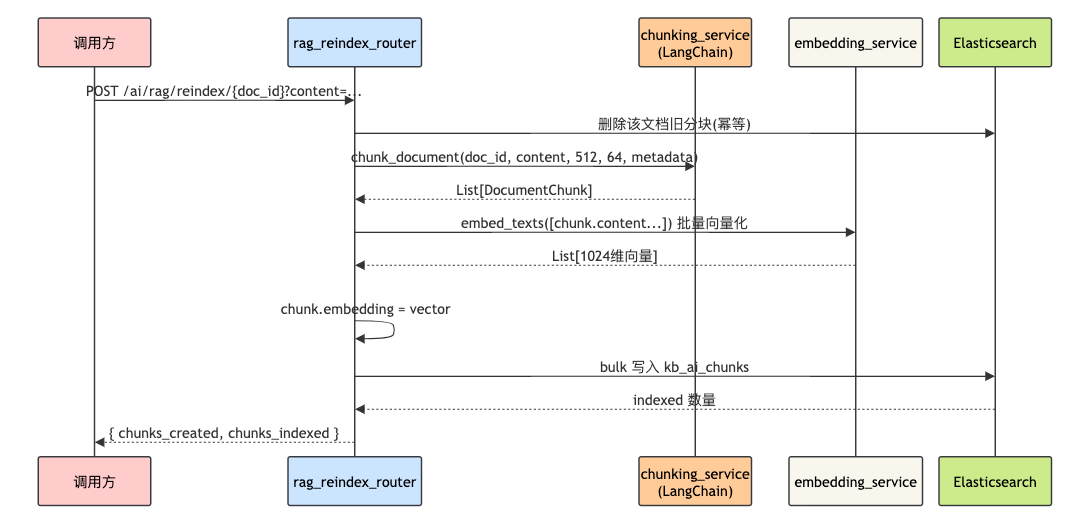
这个接口有三个值得注意的设计点:
- 删除后重建,天然幂等:先
delete_document_chunks(doc_id)清掉旧分块再写入,同一文档重复重建不会产生"幽灵旧块"; - 参数可调且带校验:
chunk_size=512 (ge=128, le=4096)、overlap=64 (ge=0, le=512)作为 Query 参数开放,方便针对不同文档类型做分块参数实验; - 顶层元数据对齐 ES 字段:
document_title / publish_time走 ES top-level 字段而不是塞进 metadata,与 Java 版索引结构一致,前端检索结果格式化零成本。
@router.post("/{doc_id}")
async def reindex_document(
    doc_id: int,
    content: str = Query(..., description="要索引的文档内容"),
    chunk_size: int = Query(512, ge=128, le=4096),
    overlap: int = Query(64, ge=0, le=512),
    document_title: Optional[str] = Query(None),
    ...
):
    deleted = await delete_document_chunks(doc_id)          # 1. 幂等清理
    chunks = chunk_document(doc_id, content, chunk_size, overlap,
                            extra_metadata=metadata or None)  # 2. LangChain 分块
    embeddings = await embed_texts([c.content for c in chunks])  # 3. 批量向量化
    for chunk, embedding in zip(chunks, embeddings):
        chunk.embedding = embedding
    indexed = await index_chunks(chunks)                    # 4. ES bulk 写入
    return Result.success(data={
        "chunks_created": len(chunks),
        "chunks_indexed": indexed,
    }).model_dump()
6.1 Celery:全量重建的异步化方向(已配置、待接线)
单文档同步重建对单篇文档完全够用;但"全量重建几万篇文档"不能塞在一个 HTTP 请求里。项目的处理是先把基础设施备好、代码留好挂载点:
# config.py — Celery Broker / Backend 已配置(Redis 3 号库)
celery_broker_url: str = "redis://:susan123@117.72.88.11:6379/3"
celery_result_backend: str = "redis://:susan123@117.72.88.11:6379/3"
# rag_reindex_router.reindex_all — 当前返回"已提交"确认
# 注释已明确生产路径:此操作触发后台 Celery 异步任务,遍历文档重新索引
return Result.success(data={
"message": "全量重建索引已提交",
"current_stats": stats,
}).model_dump()未来的接线方式(也是面试时可以展开的演进方案):

设计要点:Celery 自带 ack + 重试(分块/向量化失败不丢任务)、Worker 数量可随吞吐独立扩容;Java 端对应的异步消费由 RabbitMQ ReindexConsumer 承担——两套后端都保留了"单篇可同步、全量可异步"的伸缩路径,这正是架构演进时最舒服的状态:先跑通正确性,再把耗时路径搬进队列。
七、LangChain 选型哲学:不"为用而用"
这是本文最想传达的工程判断。LangChain 的价值是抽象层与生态,但它也带来黑盒、升级破坏、调试困难等成本。本项目的取舍是:
| LangChain 能力 | 本项目是否采用 | 原因 |
|---|---|---|
RecursiveCharacterTextSplitter | ✅ 实际使用 | 分块质量直接决定 RAG 上限,LangChain 的递归切分成熟、可配分隔符,性价比最高 |
langchain-openai ChatOpenAI | ⚠️ 预留,未直接使用 | 对话走 AsyncOpenAI 原生客户端:全异步、SSE 逐 token 更可控、prompt 组装只有几十行,不需要框架包装 |
langchain-community | ⚠️ 预留 | 若后续要接 Chroma/FAISS 等本地向量库,可直接复用社区封装 |
| LangChain LCEL 链式编排 | ❌ 未使用 | 本项目检索/重排/生成顺序固定且需要精细的异常分支,原生代码可读性更好 |
| 内置向量库 VectorStore | ❌ 未使用 | 生产环境需要 ES 的 BM25 + dense\_vector 混检,向量库由 ES 承担 |
结论一句话:把 LangChain 当"工具箱"而不是"框架"——能显著提效的组件(分块器)直接采用,其余环节保留原生控制力。这既拿到了生态红利,又不被框架绑架,是团队在 Java 与 Python 两套后端沉淀出的统一经验。
八、常见面试题(Python + LangChain 视角)
Q1 LangChain 的 RecursiveCharacterTextSplitter 和固定长度切分有什么区别?
固定长度切分在字符中间硬切,中文语义会被从中间截断;递归切分维护一个"段落 → 换行 → 句号 → 分号 → 逗号 → 空格"的分隔符栈,优先在完整语义边界切分,超长时才逐步降级到更细的分隔符,最后才用单字符兜底。叠加重叠窗口,边界语义不丢失。
Q2 chunk\_size 和 chunk\_overlap 是怎么定的?
取决于"语义完整"与"检索精度"的平衡:块太小,语义单元装不下、向量被稀释;块太大,一个向量混合多个主题、检索精度下降。项目取 512 + 64 重叠(约 12.5% 冗余),同时块大小必须与嵌入模型、LLM 上下文预算一起考虑;上线后应针对业务语料做 recall@k 与回答质量评测再微调。
Q3 为什么对话直接调 OpenAI 兼容客户端,而不用 LangChain 的 ChatOpenAI?
因为本项目需要:全异步、SSE 流式逐字推送、细粒度异常降级、以及和 Java 端完全一致的 prompt 语义。原生 AsyncOpenAI 在这些场景下代码量更少、行为更透明;LangChain 的价值集中在分块和生态集成上。框架用不用,取决于它是否真的降低复杂度。
Q4 中英文混排文档切分有什么坑?
中文没有空格分词,默认按字符切会切断语义;必须把 。;, 等中文标点显式加入分隔符,且顺序要按语义粒度从大到小。另外 token 估算不能照搬英文"4 字符 ≈ 1 token",需要为中文单独校准(本 Java 端经验系数为 2.0 字符/token)。
Q5 RRF 融合为什么能混排向量分和 BM25 分?
向量相似度与 BM25 得分量纲不同,直接相加没有意义。RRF 只看每个文档在两个榜单中的名次,1/(k+rank) 把名次变成可比较的分值,规避了跨检索器分数不可比的问题。k=60 是常用平滑常数。
Q6 LLM 打分不稳定怎么办?
三个手段:temperature=0 关闭随机性;max_tokens=10 限制输出,配合 \b([1-9]|10)\b 正则提取;解析失败回退为中等分 5,而不是中断整条检索。
Q7 Redis 缓存 Embedding 的 Key 怎么设计?
rag:emb: + 文本 MD5。文本相同(内容完全一致)才能命中,天然对"重复文档/相同段落重新入库"友好;TTL 24 小时控制脏数据生命周期;Redis 故障时跳过缓存直接调 API。
Q8 Python 端和 Java 端怎么保证检索行为一致?
两边共用一套参数语义:candidate_k = max(top_k * 2, hybrid_top_k)、RRF 常数、Prompt 模板、字段映射(document_id/document_title/heading/publish_time)、重排截断 1000 字符。Python 端对每个 Java 类都有"对应 Java XXX"的注释锚点,方便双端对照评审。
九、技术亮点速览
- LangChain 精准落地:只引入真正带来增量的
RecursiveCharacterTextSplitter,中文分隔符栈 + 512/64 重叠,其余链路保持原生 async 控制力。 - 全异步 RAG:FastAPI +
AsyncElasticsearch+AsyncOpenAI,检索、重排、生成全程协程化,SSE 逐字推送。 - 混合检索工程化:kNN + BM25 并行取
max(top_k×3, 30)候选 → RRF(权重可调、保留双榜原始分)→ LLM 重排质检 → Top-5 入 Prompt。 - 成本与可用性双优:Embedding 走
rag:emb:{md5}Redis 缓存 24h;失败降级零向量/纯 BM25;Redis 可选依赖,坏缓存不坏主链路。 - 双后端对齐:字段、Prompt、检索参数与 Java 微服务版一一对应,代码注释保留 Java 锚点,跨语言可评审、可迁移。
- 引用可追溯:检索块带文档标题与章节,LLM 强制标注
[1][2],回答有据可查、前端有引用面板。
如果说 Java 版证明了"企业级 AI 系统的工程化能力",那么 Python 版 LangChain 的落地则证明了"用最少框架成本,把 RAG 每一环做扎实"的产品判断力——这正是 AI 工程里最稀缺的能力。
