前言
KAG(Knowledge-Augmented Generation,知识图谱增强推理)是企业智能知识库系统中比 RAG 更进一步的 AI 能力。
它的本质是:在 RAG 向量检索之外,引入知识图谱的结构化推理能力,让 LLM 不仅知道"文档说了什么",还能理解"知识之间如何关联"。
为什么有了 RAG 还需要 KAG?
- RAG 的平面化局限:RAG 将知识视为"平面文档片段集合",不理解片段之间的关联。用户问"Spring Boot 的事务管理器和 DataSource 是什么关系?"时,RAG 只能分别找到包含这两个概念的片段,却无法表达它们之间的依赖链路。
- 多跳推理的需求:企业知识之间存在大量间接关联。例如"用户认证 → JWT Token → Redis 缓存 → 连接池配置",用户可能只提到了起点,但答案需要跨越多个知识点才能完整。
- 知识的结构化表达:技术文档中的实体(API、配置项、技术栈)和关系(依赖、使用、配置)天然适合用图结构表达,图遍历比文本匹配更适合回答"A 和 B 的关系是什么"这类问题。
本系统实现了一条完整的 KAG 链路:LLM 实体抽取 → 实体归一化去重 → Neo4j 图谱构建 → 多跳图遍历检索 → 向量+图谱双引擎融合 → 增强 Prompt 构建 → 流式生成回答。
整条链路通过 RabbitMQ 异步构建、Redis 缓存加速、独立可降级。
本文将从实体抽取开始,逐层拆解这条链路的每一步。
1. 一次 KAG 问答走完发生了什么
用户在 AI 助手中输入问题并同时开启"知识库增强"和"图谱推理"开关,后端执行以下流水线:
用户问题:"Spring Boot 的事务管理器是如何获取数据库连接的?"
  → RAG 向量检索(BM25 + kNN + RRF 融合,并行执行)
  → KAG 图检索(并行执行)
       ├── LLM 从问题中提取实体关键词(如 "Spring Boot", "事务管理器", "数据库连接")
       ├── Neo4j 模糊匹配实体(支持别名搜索)
       ├── 多跳图遍历(maxHops=2,找到实体间的路径)
       └── 反向查找关联的文档分块(MENTIONS 关系)
  → HybridRetrievalService 融合:RAG 权重 0.5 + KAG 权重 0.5
  → 构建 KAG 增强 Prompt(系统指令 + 匹配实体 + 推理路径 + 文档片段 + 用户问题)
  → LLM 流式生成回答(SSE,逐字返回前端)
  → 回答下方展示"知识图谱推理"面板(关联实体 + 推理路径 + 跳数)
完整流水线序列图见 8.3 双引擎融合完整序列图。
这条链路涉及 3 个微服务(kb-ai、kb-graph、kb-document)、2 种数据存储(Neo4j 图数据库、Elasticsearch 向量索引)、1 个 LLM 对话模型、以及 RabbitMQ 消息队列。下面逐层拆解。
2. 配置体系:KAGProperties 全集
2.1 配置类结构
// kb-ai/src/main/java/com/knowledge/base/ai/config/KAGProperties.java
@ConfigurationProperties(prefix = "kag")
public class KAGProperties {
    private boolean enabled = true;          // 总开关,关闭后退化为纯 RAG 模式

    // ========== 抽取配置 ==========
    public static class Extraction {
        int batchSize = 5;                   // 每批处理的分块数
        int maxEntitiesPerChunk = 10;        // 每块最多抽取的实体数
        int maxRelationsPerChunk = 15;       // 每块最多抽取的关系数
        String model = "qwen";               // 抽取使用的 LLM 模型
        int maxRetries = 2;                  // 抽取失败重试次数
        double similarityThreshold = 0.85;   // 实体名称合并的编辑距离阈值
    }

    // ========== 图谱写入配置 ==========
    public static class Graph {
        String database = "neo4j";
        boolean clearBeforeBuild = false;    // 重建前是否清空旧数据
        int batchWriteSize = 50;             // Neo4j 批量写入大小
    }

    // ========== 图检索配置 ==========
    public static class Retrieval {
        int maxHops = 2;                     // 多跳遍历的最大深度
        int maxEntitiesPerQuery = 10;        // 每次查询最多匹配的实体数
        int maxChunksPerEntity = 3;          // 每个实体最多关联的分块数
        int timeoutSeconds = 10;             // 查询超时时间
    }

    // ========== 融合配置 ==========
    public static class Fusion {
        boolean rerankEnabled = true;
        double ragWeight = 0.5;              // RAG 融合权重
        double kagWeight = 0.5;              // KAG 融合权重
    }

    // ========== 异步构建配置 ==========
    public static class Async {
        boolean enabled = true;              // 是否启用 RabbitMQ 异步构建
        int buildBatchSize = 5;              // 异步批处理大小
        int maxRetries = 3;                  // 异步重试次数
    }
}
2.2 条件装配
// kb-ai/src/main/java/com/knowledge/base/ai/config/KAGAutoConfiguration.java
@ConditionalOnProperty(name = "kag.enabled", havingValue = "true", matchIfMissing = true)
@ComponentScan(basePackages = "com.knowledge.base.ai.rag.kag")
public class KAGAutoConfiguration { }
当 kag.enabled = false 时,整个 KAG 模块的 Bean 不会被加载,系统完全退化为纯 RAG 模式。这是 KAG 最重要的一级降级开关——部署时不需要 KAG 的团队只需在配置文件中设置 kag.enabled: false 即可,Neo4j 不再是必需依赖。
3. 实体抽取:LLM 驱动的结构化知识提取
3.1 为什么用 LLM 做实体抽取
传统的 NER(命名实体识别)模型只能识别预定义实体类型(人名、地名、机构名等),无法理解技术文档中的特定知识概念。本系统使用 LLM 做开放域实体抽取,可以识别:
| 实体类型 | 示例 |
|---|---|
| TECH\_STACK | Spring Boot, Redis, Elasticsearch, Nacos |
| API | DataSource.getConnection(), PUT /documents/{id} |
| CONFIG | spring.datasource.url, redis.timeout |
| CONCEPT | 事务传播机制, RRF 融合排序, 降级策略 |
| TOOL | Maven, Docker, Jenkins, Postman |
| PROCESS | 文档审核流程, 发布索引流水线, OAuth2 认证流程 |
3.2 抽取服务接口
// kb-ai/src/main/java/com/knowledge/base/ai/rag/kag/extraction/ExtractionService.java
public interface ExtractionService {
    /**
     * 从单个文本块中抽取实体和关系
     * @param content       分块文本内容(截断至 3000 字符)
     * @param heading       分块所属的 Markdown 标题(用于提供上下文)
     * @param docId         所属文档 ID(用于溯源)
     * @param documentTitle 文档标题(用于关联展示)
     * @return 包含实体列表和关系列表的抽取结果
     */
    ExtractionResult extract(String content, String heading, Long docId, String documentTitle);

    /** 批量抽取,减少 LLM 调用次数 */
    List<ExtractionResult> extractBatch(List<ExtractionInput> contents);

    record ExtractionInput(String content, String heading, Long docId, String documentTitle) {}
}
3.3 LLM 抽取实现
// kb-ai/src/main/java/com/knowledge/base/ai/rag/kag/extraction/impl/LLMExtractionServiceImpl.java
public ExtractionResult extract(String content, String heading, Long docId, String documentTitle) {
    // Step 1: 构建 System Prompt —— 定义 6 种实体类型 + 5 种关系类型
    String systemPrompt = """
        你是一个技术文档知识抽取专家。请从以下技术文档片段中:

        1. 识别关键的知识实体(技术栈、API、配置项、概念、工具、流程)
        2. 识别实体之间的关系(依赖、使用、配置、包含、关联)

        请严格按 JSON 格式输出:
        {
          "entities": [
            {"name": "实体名称", "type": "TECH_STACK/API/CONFIG/CONCEPT/TOOL/PROCESS",
             "description": "简要说明", "aliases": ["别名1", "别名2"]}
          ],
          "relations": [
            {"source": "源实体名", "target": "目标实体名",
             "relation": "DEPENDS_ON/USES/CONFIGURES/HAS_PART/RELATED_TO",
             "description": "关系说明"}
          ]
        }

        要求:
        - 每个分块最多抽取 10 个实体和 15 个关系
        - 别名必须是文档中实际出现的等价表述
        - 不要编造不存在的实体或关系
        """;

    String userPrompt = String.format("""
        文档标题:%s
        所属章节:%s

        文档内容:
        %s
        """, documentTitle, heading, truncateContent(content, 3000));

    // Step 2: 调用 LLM,失败重试
    for (int attempt = 0; attempt <= maxRetries; attempt++) {
        try {
            String response = modelProvider.getModel(extractionModel)
                .generate(SystemMessage.from(systemPrompt), UserMessage.from(userPrompt))
                .content().text();
            return parseResponse(response, docId);      // 解析 JSON 响应
        } catch (Exception e) {
            if (attempt == maxRetries) throw new ExtractionException(docId, chunkId, e);
            log.warn("实体抽取失败,重试 {}/{}", attempt + 1, maxRetries);
        }
    }
}
3.4 JSON 响应解析
// parseResponse() —— 处理 LLM 返回的多种格式
private ExtractionResult parseResponse(String response, Long docId) {
    // 1. 尝试提取 ```json ... ``` 代码块
    String json = extractJsonBlock(response);
    // 2. 如果无代码块,直接使用整段响应
    if (json == null) json = response;

    JsonNode root = objectMapper.readTree(json);
    List<ExtractedEntity> entities = parseEntities(root.get("entities"));
    List<ExtractedRelation> relations = parseRelations(root.get("relations"));

    return new ExtractionResult(chunkId, docId, entities, relations);
}
LLM 可能返回 ```json {...} ``` 包裹的内容,也可能直接返回 JSON,甚至可能在 JSON 前后加解释性文字。parseResponse() 使用正则 /\{[\s\S]*\}/ 提取 JSON 块,兼容这些情况。
3.5 抽取结果的数据结构
// kb-ai/src/main/java/com/knowledge/base/ai/dto/kag/extraction/ExtractedEntity.java
public class ExtractedEntity {
    private String name;               // 实体名称
    private String type;               // TECH_STACK / API / CONFIG / CONCEPT / TOOL / PROCESS
    private String description;        // 简要说明
    private List<String> aliases;      // 别名列表
    private Double confidence = 0.8;   // 置信度(归一化阶段会调整)
}

// kb-ai/src/main/java/com/knowledge/base/ai/dto/kag/extraction/ExtractedRelation.java
public class ExtractedRelation {
    // 关系类型常量
    public static final String DEPENDS_ON = "DEPENDS_ON";
    public static final String USES = "USES";
    public static final String CONFIGURES = "CONFIGURES";
    public static final String HAS_PART = "HAS_PART";
    public static final String RELATED_TO = "RELATED_TO";

    private String source;             // 源实体名
    private String target;             // 目标实体名
    private String relation;           // 关系类型
    private Double weight = 0.8;       // 关系权重
}

// kb-ai/src/main/java/com/knowledge/base/ai/dto/kag/extraction/ExtractionResult.java
public class ExtractionResult {
    private String chunkId;
    private Long docId;
    private List<ExtractedEntity> entities;
    private List<ExtractedRelation> relations;

    public boolean isEmpty() {
        return (entities == null || entities.isEmpty())
            && (relations == null || relations.isEmpty());
    }
}
4. 实体归一化:三阶段去重与融合
4.1 为什么需要归一化
LLM 从不同文档分块中抽取实体时,同一个真实世界的实体可能以不同名称出现:
- "Redis 缓存" / "Redis Cache" / "Redis" → 同一个技术栈
- "JWT 认证" / "JWT Token" / "JWT令牌" → 同一个概念
- "Nacos 注册中心" / "Nacos" → 同一个工具
如果不做归一化,Neo4j 中会存在大量"同名不同拼写"的实体节点,导致图遍历时找不到关联路径。
4.2 归一化三阶段流水线
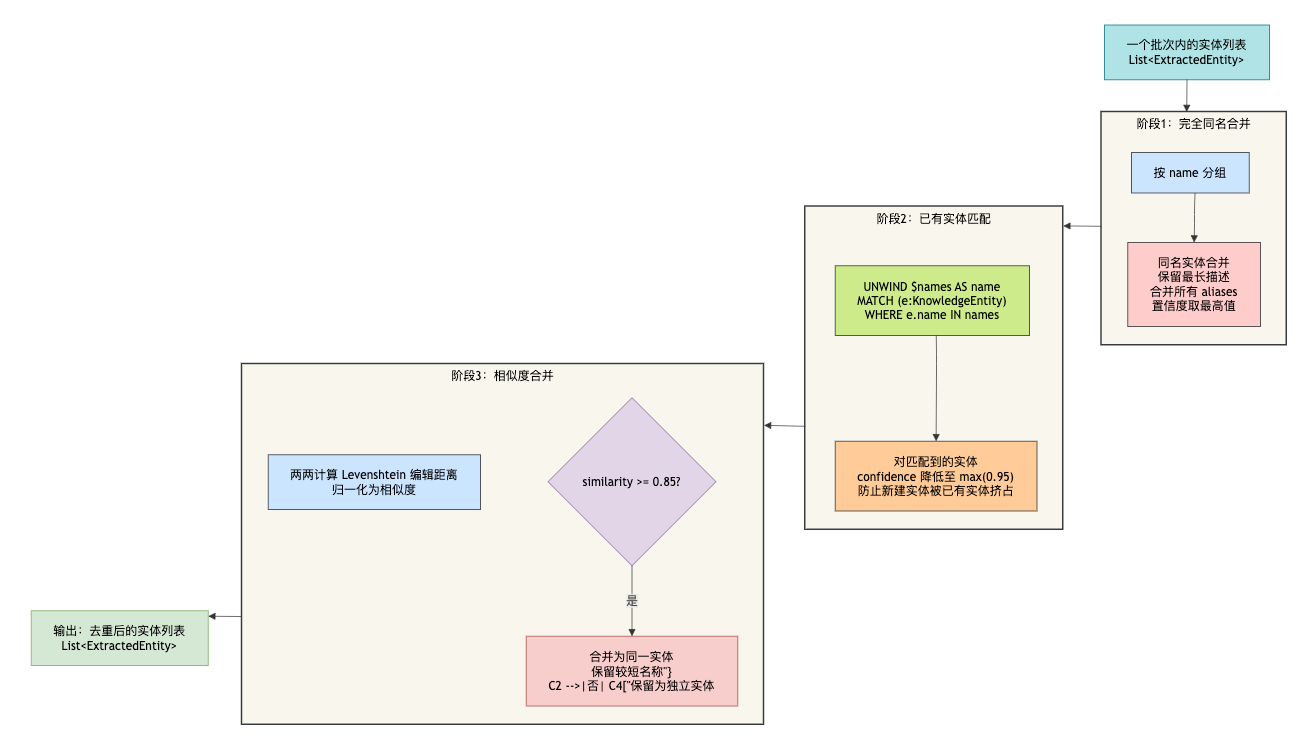
4.3 EntityNormalizer 核心实现
// kb-ai/src/main/java/com/knowledge/base/ai/rag/kag/extraction/EntityNormalizer.java
public class EntityNormalizer {

    private final double similarityThreshold;   // 默认 0.85
    private final Neo4jClient neo4jClient;

    // ===== 阶段1:同批次内同名合并 =====
    private List<ExtractedEntity> mergeDuplicateNames(List<ExtractedEntity> entities) {
        Map<String, ExtractedEntity> merged = new LinkedHashMap<>();
        for (ExtractedEntity entity : entities) {
            merged.merge(entity.getName(), entity, (existing, incoming) -> {
                existing.getAliases().addAll(incoming.getAliases());
                existing.setConfidence(Math.max(existing.getConfidence(), incoming.getConfidence()));
                // 保留更长的描述
                if (incoming.getDescription() != null
                    && incoming.getDescription().length() > existing.getDescription().length()) {
                    existing.setDescription(incoming.getDescription());
                }
                return existing;
            });
        }
        return new ArrayList<>(merged.values());
    }

    // ===== 阶段2:Neo4j 已有实体匹配 =====
    private List<ExtractedEntity> resolveWithExisting(List<ExtractedEntity> entities) {
        if (entities.isEmpty()) return entities;
        List<String> names = entities.stream().map(ExtractedEntity::getName).toList();
        // 批量查询 Neo4j 中是否已存在同名实体
        List<String> existingNames = neo4jClient.query("""
            UNWIND $names AS name
            MATCH (e:KnowledgeEntity)
            WHERE e.name IN $names
            RETURN e.name AS name
            """)
            .bindAll(Map.of("names", names))
            .fetchAs(String.class).all();

        Set<String> existingSet = new HashSet<>(existingNames);
        for (ExtractedEntity entity : entities) {
            if (existingSet.contains(entity.getName())) {
                entity.setConfidence(Math.min(entity.getConfidence(), 0.95));
            }
        }
        return entities;
    }

    // ===== 阶段3:编辑距离相似度合并 =====
    private List<ExtractedEntity> mergeBySimilarity(List<ExtractedEntity> entities) {
        List<ExtractedEntity> result = new ArrayList<>();
        for (ExtractedEntity entity : entities) {
            boolean merged = false;
            for (ExtractedEntity existing : result) {
                double similarity = computeNameSimilarity(entity.getName(), existing.getName());
                if (similarity >= similarityThreshold) {
                    existing.getAliases().add(entity.getName());
                    existing.setConfidence(Math.max(existing.getConfidence(), entity.getConfidence()));
                    merged = true;
                    break;
                }
            }
            if (!merged) {
                result.add(entity);
            }
        }
        return result;
    }

    // Levenshtein 编辑距离 → 归一化相似度
    private double computeNameSimilarity(String a, String b) {
        if (a.equalsIgnoreCase(b)) return 1.0;
        // 包含关系:一个名称是另一个的子串
        if (a.toLowerCase().contains(b.toLowerCase())
            || b.toLowerCase().contains(a.toLowerCase())) {
            return 0.9;
        }
        int distance = levenshteinDistance(a.toLowerCase(), b.toLowerCase());
        int maxLen = Math.max(a.length(), b.length());
        return 1.0 - (double) distance / maxLen;
    }
}
4.4 归一化设计考量
| 维度 | 选择 | 理由 |
|---|---|---|
| 同名合并 | 准召优先 | 同一批次内完全同名的实体一定是同一个,直接合并 |
| 已有匹配 | 降低置信度 | 防止新抽取的实体挤占 Neo4j 中的已有实体属性 |
| 相似度算法 | Levenshtein | 适用于中文短名称,计算开销低 |
| 阈值 | 0.85 | 兼顾合并去重和区分不同实体(如 "Spring Boot" vs "Spring Cloud" = 0.5,不合并) |
| 包含判定 | 直接给 0.9 | "Nacos" 被 "Nacos注册中心" 包含,视为同一实体 |
5. 图谱构建:从抽取结果到 Neo4j 的全流程
5.1 构建服务接口
// kb-ai/src/main/java/com/knowledge/base/ai/rag/kag/graph/GraphBuildService.java
public interface GraphBuildService {
    int buildForDocument(Long docId);            // 同步构建单个文档
    void deleteForDocument(Long docId);          // 同步删除文档图谱
    int buildAll();                              // 同步全量重建(分页遍历)
    int buildBatch(List<Long> docIds);           // 同步批量构建

    // 异步方法(通过 RabbitMQ)
    String publishBuildTask(Long docId);
    String publishBuildBatchTask(List<Long> docIds);
    String publishBuildAllTask();
    String publishDeleteTask(Long docId);
}
5.2 单文档完整构建流程
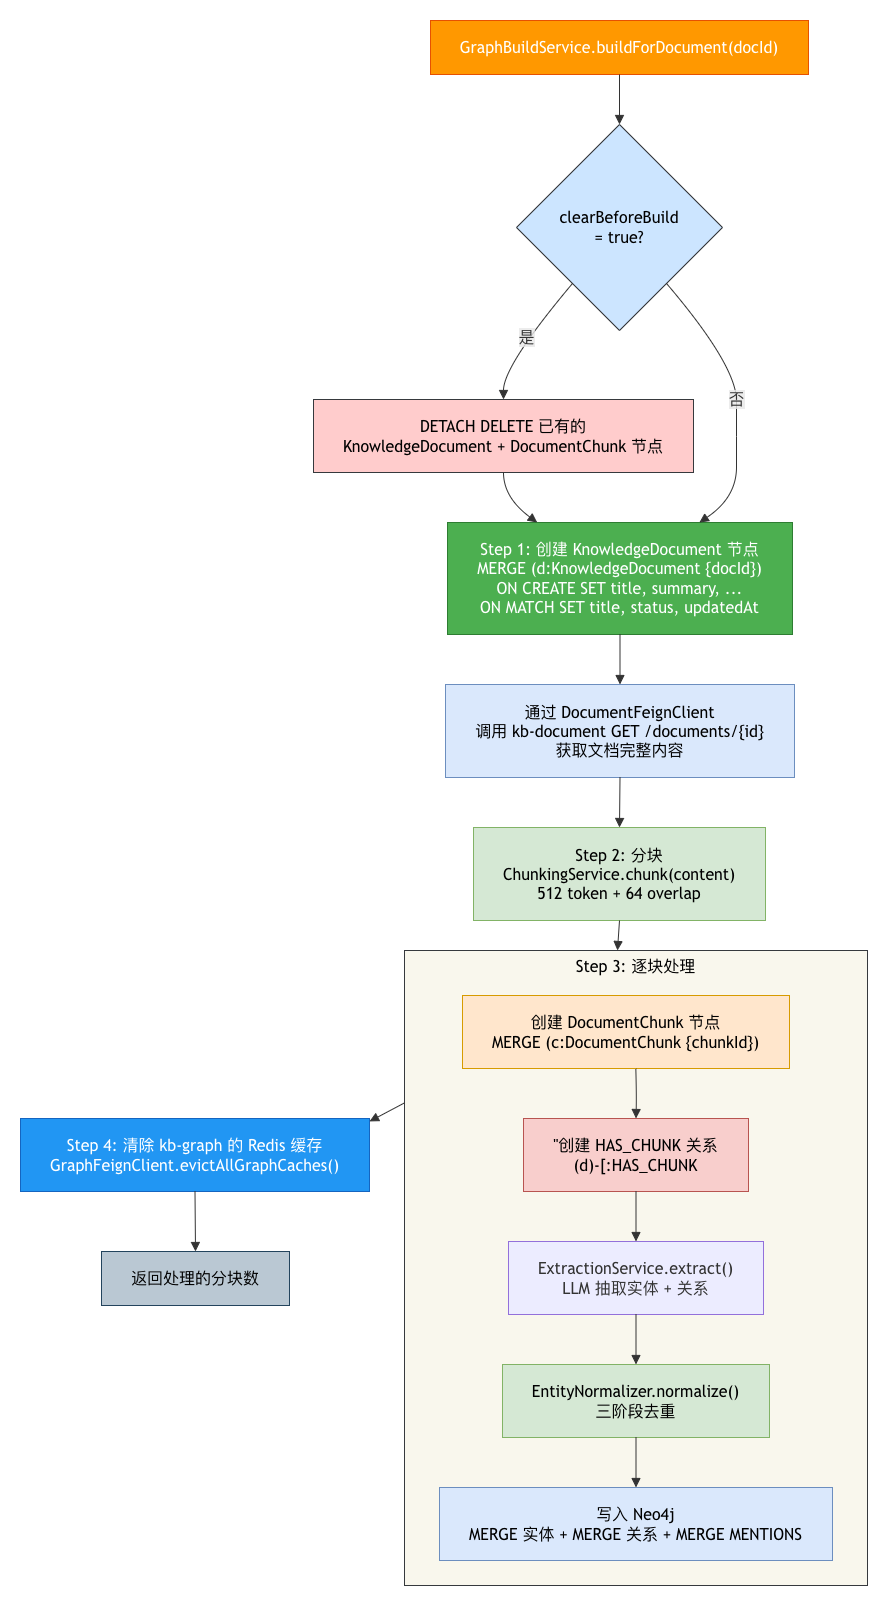
5.3 Neo4j 写入操作详解
创建 KnowledgeDocument 节点
MERGE (d:KnowledgeDocument {docId: $docId})
ON CREATE SET d.title = $title,
              d.summary = $summary,
              d.categoryId = $categoryId,
              d.authorId = $authorId,
              d.authorName = $authorName,
              d.status = $status,
              d.documentType = $documentType,
              d.tags = $tags,
              d.publishTime = $publishTime,
              d.createdAt = $createdAt,
              d.updatedAt = $updatedAt
ON MATCH SET d.title = $title,
             d.summary = $summary,
             d.status = $status,
             d.updatedAt = $updatedAt
创建 DocumentChunk 节点
MERGE (c:DocumentChunk {chunkId: $chunkId})
ON CREATE SET c.docId = $docId,
              c.content = $content,
              c.heading = $heading,
              c.chunkIndex = $chunkIndex,
              c.totalChunks = $totalChunks,
              c.categoryId = $categoryId,
              c.createdAt = $createdAt
创建 HAS\_CHUNK 关系
MATCH (d:KnowledgeDocument {docId: $docId})
MATCH (c:DocumentChunk {chunkId: $chunkId})
MERGE (d)-[r:HAS_CHUNK]->(c)
ON CREATE SET r.chunkIndex = $chunkIndex
创建 KnowledgeEntity 节点
MERGE (e:KnowledgeEntity {name: $name})
ON CREATE SET e.type = $type,
              e.description = $description,
              e.aliases = $aliases,
              e.createdAt = $createdAt,
              e.updatedAt = $updatedAt
ON MATCH SET e.aliases = CASE WHEN e.aliases IS NULL THEN $aliases
                               ELSE apoc.coll.union(e.aliases, $aliases) END,
             e.description = CASE WHEN e.description IS NULL OR length($description) > length(e.description)
                                  THEN $description ELSE e.description END,
             e.updatedAt = $updatedAt
创建实体间关系
MATCH (a:KnowledgeEntity {name: $sourceName})
MATCH (b:KnowledgeEntity {name: $targetName})
MERGE (a)-[r:RELATED_TO]->(b)
ON CREATE SET r.relation = $relation,
              r.weight = $weight,
              r.createdAt = $createdAt
创建 MENTIONS 关系(连接分块和实体)
MATCH (c:DocumentChunk {chunkId: $chunkId})
MATCH (e:KnowledgeEntity {name: $entityName})
MERGE (c)-[r:MENTIONS]->(e)
ON CREATE SET r.confidence = $confidence,
              r.chunkId = $chunkId
5.4 图谱删除
// GraphBuildServiceImpl.deleteForDocument()
public void deleteForDocument(Long docId) {
    // 1. 删除文档节点及其关联的分块节点
    neo4jClient.query("""
        MATCH (d:KnowledgeDocument {docId: $docId})
        OPTIONAL MATCH (d)-[:HAS_CHUNK]->(c:DocumentChunk)
        DETACH DELETE d, c
        """).bindAll(Map.of("docId", docId)).run();

    // 2. 清理孤立实体:删除不再被任何 MENTIONS 关联的 KnowledgeEntity
    neo4jClient.query("""
        MATCH (e:KnowledgeEntity)
        WHERE NOT EXISTS { MATCH (e)<-[:MENTIONS]-() }
        DETACH DELETE e
        """).run();

    // 3. 清除 Redis 缓存
    graphFeignClient.evictAllGraphCaches();
}
此方法在文档被删除或需要重建时调用。"DETACH DELETE" 会级联删除节点上的所有关联关系。步骤 2 清理了"幽灵实体"——曾经有文档提到、但现在所有文档都已删除的孤立知识实体。
6. 异步构建流水线:RabbitMQ 驱动的文档索引
6.1 为什么需要异步构建
单文档的 KAG 构建涉及:调用 DocumentFeignClient 获取内容 → ChunkingService 分块 → ExtractionService 对每个分块调用 LLM → EntityNormalizer 归一化 → 逐块写入 Neo4j。以一篇 5000 字的文档(约 10 个分块)为例,光 LLM 抽取就需要 10 次 API 调用,耗时可能达到 5-10 秒。
如果这些操作在文档发布请求的主线程中同步执行,用户体验将无法接受。异步构建将这 10 秒延迟转移到后台,不影响文档发布响应。
6.2 RabbitMQ 消息模型
// kb-ai/src/main/java/com/knowledge/base/ai/mq/KAGReindexMessage.java
public class KAGReindexMessage implements Serializable {
    private String taskId;               // UUID,用于日志追踪
    private KAGBuildType type;           // 构建类型
    private List<Long> documentIds;      // 文档 ID 列表

    public enum KAGBuildType {
        BUILD_ALL,           // 全量重建(遍历所有已发布文档)
        BUILD_BY_DOC_IDS,    // 按 ID 列表构建
        DELETE_BY_DOC_IDS    // 删除图谱
    }
}
6.3 RabbitMQ 基础设施
// kb-ai/src/main/java/com/knowledge/base/ai/config/KAGRabbitConfig.java
@Configuration
public class KAGRabbitConfig {

    public static final String EXCHANGE = "kag.graph.exchange";
    public static final String QUEUE = "kag.graph.build.queue";
    public static final String DLQ = "kag.graph.build.dlq";

    @Bean
    public TopicExchange kagGraphExchange() {
        return new TopicExchange(EXCHANGE, true, false);  // durable=true
    }

    @Bean
    public Queue kagGraphBuildQueue() {
        return QueueBuilder.durable(QUEUE)
            .withArgument("x-dead-letter-exchange", "")
            .withArgument("x-dead-letter-routing-key", DLQ)
            .build();
    }

    @Bean
    public Queue kagGraphBuildDlq() {
        return new Queue(DLQ, true);
    }

    @Bean
    public Binding kagGraphBuildBinding() {
        return BindingBuilder.bind(kagGraphBuildQueue())
            .to(kagGraphExchange())
            .with("kag.graph.build.#");      // 匹配所有构建消息
    }
}
Routing Key 设计:
| Routing Key | 用途 | 触发源 |
|---|---|---|
kag.graph.build.all | 全量重建 | POST /kag/build/all |
kag.graph.build.by_ids | 按 ID 列表构建 | POST /kag/build/batch 或文档发布后自动触发 |
kag.graph.delete | 删除文档图谱 | DELETE /kag/build/{docId} |
6.4 消息消费者
// kb-ai/src/main/java/com/knowledge/base/ai/mq/KAGReindexConsumer.java
@Component
@Slf4j
public class KAGReindexConsumer {

    @RabbitListener(queues = "kag.graph.build.queue", ackMode = "MANUAL")
    public void handleBuild(KAGReindexMessage message,
                            Channel channel,
                            @Header(AmqpHeaders.DELIVERY_TAG) long deliveryTag) {
        log.info("收到 KAG 构建任务: taskId={}, type={}", message.getTaskId(), message.getType());

        try {
            switch (message.getType()) {
                case DELETE_BY_DOC_IDS -> {
                    for (Long docId : message.getDocumentIds()) {
                        graphBuildService.deleteForDocument(docId);
                    }
                }
                case BUILD_BY_DOC_IDS -> {
                    graphBuildService.buildBatch(message.getDocumentIds());
                }
                case BUILD_ALL -> {
                    graphBuildService.buildAll();
                }
            }
            channel.basicAck(deliveryTag, false);    // 手动确认
            log.info("KAG 构建任务完成: taskId={}", message.getTaskId());

        } catch (Exception e) {
            log.error("KAG 构建任务失败: taskId={}", message.getTaskId(), e);
            // 不 re-queue,直接进入死信队列
            channel.basicNack(deliveryTag, false, false);
        }
    }
}
6.5 异步发布入口
// KAGReindexController (对外) + GraphBuildService (内部)

// ===== 同步方法(内部调用) =====
int buildForDocument(Long docId) { /* 完整构建 */ }
int buildBatch(List<Long> docIds) { /* 完整批量构建 */ }

// ===== 异步方法(对外暴露) =====
public String publishBuildTask(Long docId) {
    KAGReindexMessage message = new KAGReindexMessage();
    message.setTaskId(UUID.randomUUID().toString());
    message.setType(KAGBuildType.BUILD_BY_DOC_IDS);
    message.setDocumentIds(List.of(docId));

    try {
        rabbitTemplate.convertAndSend(
            KAGRabbitConfig.EXCHANGE,
            "kag.graph.build.by_ids",
            message);
        return message.getTaskId();
    } catch (Exception e) {
        log.warn("RabbitMQ 发送失败,降级为同步构建: docId={}", docId, e);
        buildForDocument(docId);
        return "sync-" + message.getTaskId();
    }
}关键设计:异步发布失败时降级为同步构建。这意味着即使 RabbitMQ 宕机,KAG 构建仍然可用(只是会阻塞发布请求)。
6.6 异步构建完整序列图
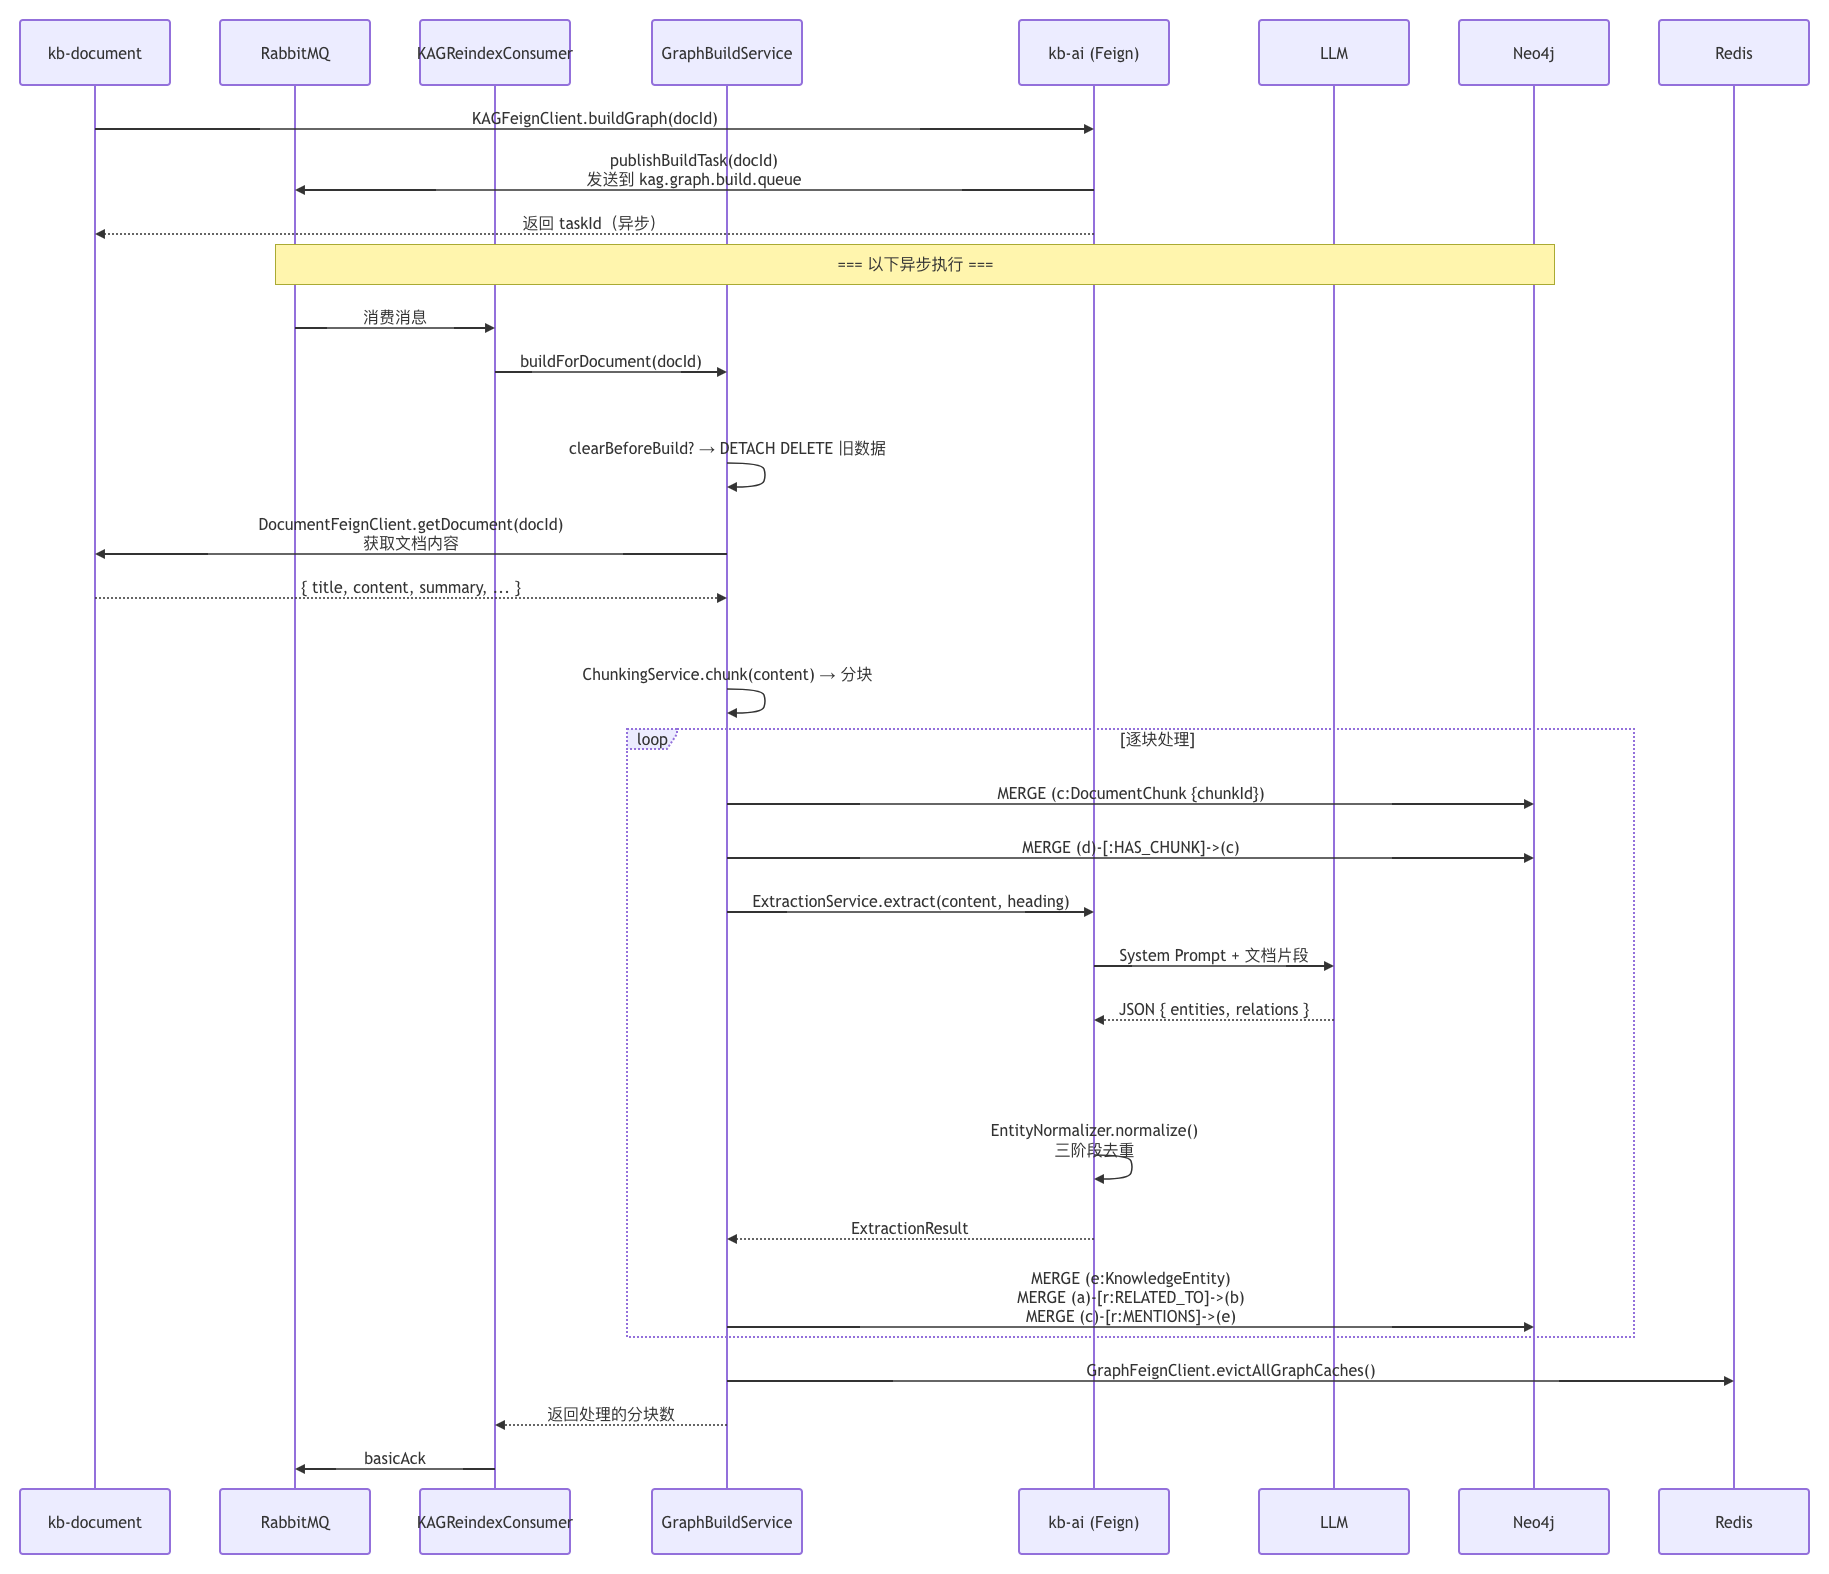
7. 图遍历检索:从问题到图上下文的四步检索
7.1 检索服务接口
// kb-ai/src/main/java/com/knowledge/base/ai/rag/kag/retrieval/KAGRetrievalService.java
public interface KAGRetrievalService {
    GraphContext retrieveGraphContext(String query, int maxEntities, int maxHops, int maxChunks);
    GraphContext retrieveGraphContext(String query);  // 使用配置默认值
}
7.2 四步检索流水线
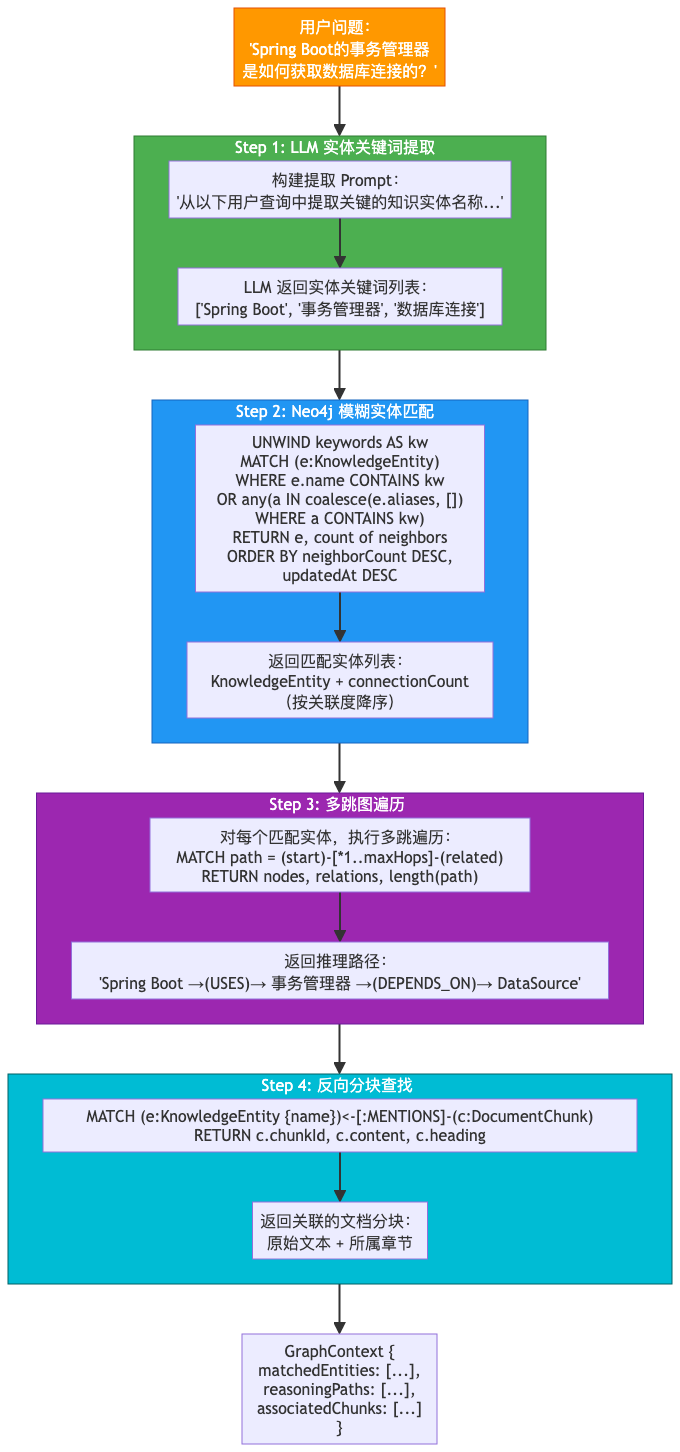
7.3 Step 1:LLM 实体关键词提取
// KAGRetrievalServiceImpl — extractEntityKeywords()
private List<String> extractEntityKeywords(String query) {
    String systemPrompt = """
        你是一个技术实体识别助手。
        请从用户查询中提取关键的知识实体名称,最多提取5个。
        每个实体名应简洁、概括性强(如 Spring Boot, 事务管理器, 数据库连接池)。
        仅返回实体名称列表,每行一个,不要返回任何其他内容。
        """;

    String response = modelProvider.getModel(extractionModel)
        .generate(SystemMessage.from(systemPrompt), UserMessage.from(query))
        .content().text();

    return Arrays.stream(response.split("\\n"))
        .map(String::trim)
        .filter(s -> !s.isEmpty())
        .limit(maxEntitiesPerQuery)     // 默认最多 10 个
        .toList();
}
7.4 Step 2:Neo4j 模糊实体匹配
// KAGRetrievalServiceImpl — matchEntities()
List<GraphEntity> matchEntities(List<String> keywords, int limit) {
    List<Map<String, Object>> rows = neo4jClient.query("""
        UNWIND $keywords AS keyword
        MATCH (e:KnowledgeEntity)
        WHERE e.name CONTAINS keyword
           OR any(a IN coalesce(e.aliases, []) WHERE a CONTAINS keyword)
        OPTIONAL MATCH (e)-[r:RELATED_TO|DEPENDS_ON|USES|CONFIGURES|HAS_PART]-(other)
        WITH e, count(DISTINCT other) AS connectionCount
        RETURN e.name AS name, e.type AS type,
               e.description AS description, connectionCount
        ORDER BY connectionCount DESC, e.updatedAt DESC
        LIMIT $limit
        """)
        .bindAll(Map.of("keywords", keywords, "limit", limit))
        .fetch().all();

    return rows.stream().map(row -> new GraphEntity(
        (String) row.get("name"),
        (String) row.get("type"),
        (String) row.get("description"),
        ((Number) row.get("connectionCount")).intValue()
    )).toList();
}关键设计:模糊匹配 (CONTAINS) 支持部分匹配,别名搜索 (coalesce(e.aliases, [])) 确保"JWT Token"能同时匹配到别名为"JWT Token"的"JWT 认证"实体。排序时优先返回关联度高的实体。
7.5 Step 3:多跳图遍历
// KAGRetrievalServiceImpl — traverseGraph()
List<GraphPath> traverseGraph(String entityName, int maxHops, int limit) {
    List<Map<String, Object>> rows = neo4jClient.query("""
        MATCH (start:KnowledgeEntity {name: $entityName})
        MATCH path = (start)-[:DEPENDS_ON|USES|CONFIGURES|HAS_PART|RELATED_TO*1..""" + maxHops + "]-(related)"
        RETURN [n IN nodes(path) | n.name] AS nodeNames,
               [r IN relationships(path) | coalesce(r.relation, type(r))] AS relationTypes,
               length(path) AS hops
        ORDER BY hops ASC
        LIMIT $limit
        """)
        .bindAll(Map.of("entityName", entityName, "limit", limit))
        .fetch().all();

    return rows.stream().map(row -> new GraphPath(
        (List<String>) row.get("nodeNames"),
        (List<String>) row.get("relationTypes"),
        ((Number) row.get("hops")).intValue()
    )).toList();
}多跳遍历的核心价值:
假设用户问:"Redis 连接池的配置需要改动哪些地方?"
路径1: Redis →(USES)→ Jedis →(CONFIGURES)→ spring.redis.jedis.pool →(RELATED_TO)→ 连接池大小配置
路径2: Redis →(DEPENDS_ON)→ 网络连接 →(CONFIGURES)→ spring.redis.timeout →(RELATED_TO)→ 超时配置
路径3: Redis →(USES)→ Lettuce →(CONFIGURES)→ spring.redis.lettuce.pool →(DEPENDS_ON)→ 线程池配置
这些路径告诉 LLM:改 Redis 连接池不只是改一个地方,还涉及 Jedis/Lettuce 客户端选择、超时配置、线程池配置等多个关联配置项。纯 RAG 不会提供这种关联关系。
7.6 Step 4:反向分块查找
// KAGRetrievalServiceImpl — findMentioningChunks()
List<GraphChunk> findMentioningChunks(String entityName, int limit) {
    List<Map<String, Object>> rows = neo4jClient.query("""
        MATCH (e:KnowledgeEntity {name: $entityName})<-[:MENTIONS]-(c:DocumentChunk)
        OPTIONAL MATCH (c)<-[:HAS_CHUNK]-(d:KnowledgeDocument)
        WHERE d.status = 1          // 只查找已发布文档的分块
        RETURN c.chunkId AS chunkId, c.content AS content,
               c.heading AS heading, d.docId AS docId,
               d.title AS docTitle, e.name AS entityName
        ORDER BY c.chunkIndex ASC
        LIMIT $limit
        """)
        .bindAll(Map.of("entityName", entityName, "limit", limit))
        .fetch().all();

    return rows.stream().map(row -> new GraphChunk(
        (String) row.get("chunkId"),
        (Long) row.get("docId"),
        (String) row.get("docTitle"),
        (String) row.get("content"),
        (String) row.get("heading"),
        (String) row.get("entityName")
    )).toList();
}
7.7 GraphContext 返回结构
// kb-ai/src/main/java/com/knowledge/base/ai/rag/kag/retrieval/GraphContext.java
public class GraphContext implements Serializable {
    private List<GraphEntity> matchedEntities;       // 匹配的实体
    private List<GraphPath> reasoningPaths;          // 推理路径
    private List<GraphChunk> associatedChunks;       // 关联分块
    private boolean hasResults;                      // 是否有结果

    public static class GraphEntity {
        private String name;                         // 实体名称
        private String type;                         // 实体类型
        private String description;                  // 描述
        private int connectionCount;                 // 关联实体数
    }

    public static class GraphPath {
        private List<String> nodes;                  // 路径上的实体名
        private List<String> relations;              // 路径上的关系类型
        private int hops;                            // 跳数
    }

    public static class GraphChunk {
        private String chunkId;
        private Long docId;
        private String docTitle;                     // 来源文档标题
        private String content;                      // 分块内容
        private String heading;                      // 所属章节
        private String entityName;                   // 关联的实体名
    }
}
8. 双引擎融合:RAG 0.5 + KAG 0.5 的混合策略
8.1 融合服务接口
// kb-ai/src/main/java/com/knowledge/base/ai/rag/kag/retrieval/HybridRetrievalService.java
public interface HybridRetrievalService {
    HybridResult retrieveHybrid(String query, int topK, boolean enableRerank, boolean enableKAG);
}

// HybridResult 记录
record HybridResult(
    List<RagSearchResultVO> ragResults,        // RAG 原始结果
    GraphContext kagContext,                   // KAG 图上下文
    List<RagSearchResultVO> fusedResults,      // 融合后的最终结果
    boolean knowledgeGraphEnhanced             // KAG 是否有效贡献了结果
) {}
8.2 融合算法
// kb-ai/.../kag/retrieval/impl/HybridRetrievalServiceImpl.java
public HybridResult retrieveHybrid(String query, int topK, boolean enableRerank, boolean enableKAG) {

    // ===== Step 1: RAG 检索(始终执行) =====
    List<RagSearchResultVO> ragResults = ragRetrievalService.retrieve(query, topK * 2, enableRerank);

    // ===== Step 2: KAG 并行检索(CompletableFuture,带超时控制) =====
    GraphContext kagContext = new GraphContext();   // 默认空结果
    boolean knowledgeGraphEnhanced = false;

    if (enableKAG) {
        try {
            CompletableFuture<GraphContext> kagFuture = CompletableFuture.supplyAsync(
                () -> kagRetrievalService.retrieveGraphContext(query),
                asyncTaskExecutor
            );
            kagContext = kagFuture.get(retrievalTimeoutSeconds, TimeUnit.SECONDS);
            knowledgeGraphEnhanced = kagContext.isHasResults();
        } catch (TimeoutException e) {
            log.warn("KAG 检索超时 ({}s),使用 RAG 结果", retrievalTimeoutSeconds);
        } catch (Exception e) {
            log.warn("KAG 检索失败,降级为纯 RAG", e);
        }
    }

    // ===== Step 3: 融合 =====
    List<RagSearchResultVO> fusedResults = new ArrayList<>();

    if (!knowledgeGraphEnhanced) {
        // KAG 无有效结果,直接使用 RAG 结果
        fusedResults = ragResults;
    } else {
        // 将 KAG 关联的分块转换为搜索结果的格式
        for (GraphChunk chunk : kagContext.getAssociatedChunks()) {
            RagSearchResultVO result = new RagSearchResultVO();
            result.setChunkId(chunk.getChunkId());
            result.setDocumentId(chunk.getDocId());
            result.setDocumentTitle(chunk.getDocTitle());
            result.setContent(chunk.getContent());
            result.setHeading(chunk.getHeading());
            result.setScore(0.65);     // KAG 分块基准分
            result.setSource("kag");   // 标注来源为 KAG
            fusedResults.add(result);
        }

        // 融入 RAG 结果(去重:RAG 优先级 > KAG)
        Set<String> existingChunkIds = fusedResults.stream()
            .map(RagSearchResultVO::getChunkId).collect(Collectors.toSet());

        for (RagSearchResultVO ragResult : ragResults) {
            if (!existingChunkIds.contains(ragResult.getChunkId())) {
                ragResult.setSource("rag");
                fusedResults.add(ragResult);
            }
        }

        // 按分数降序排序,取 Top-K
        fusedResults.sort((a, b) -> Double.compare(b.getScore(), a.getScore()));
        if (fusedResults.size() > topK) {
            fusedResults = fusedResults.subList(0, topK);
        }
    }

    return new HybridResult(ragResults, kagContext, fusedResults, knowledgeGraphEnhanced);
}
8.3 双引擎融合完整序列图
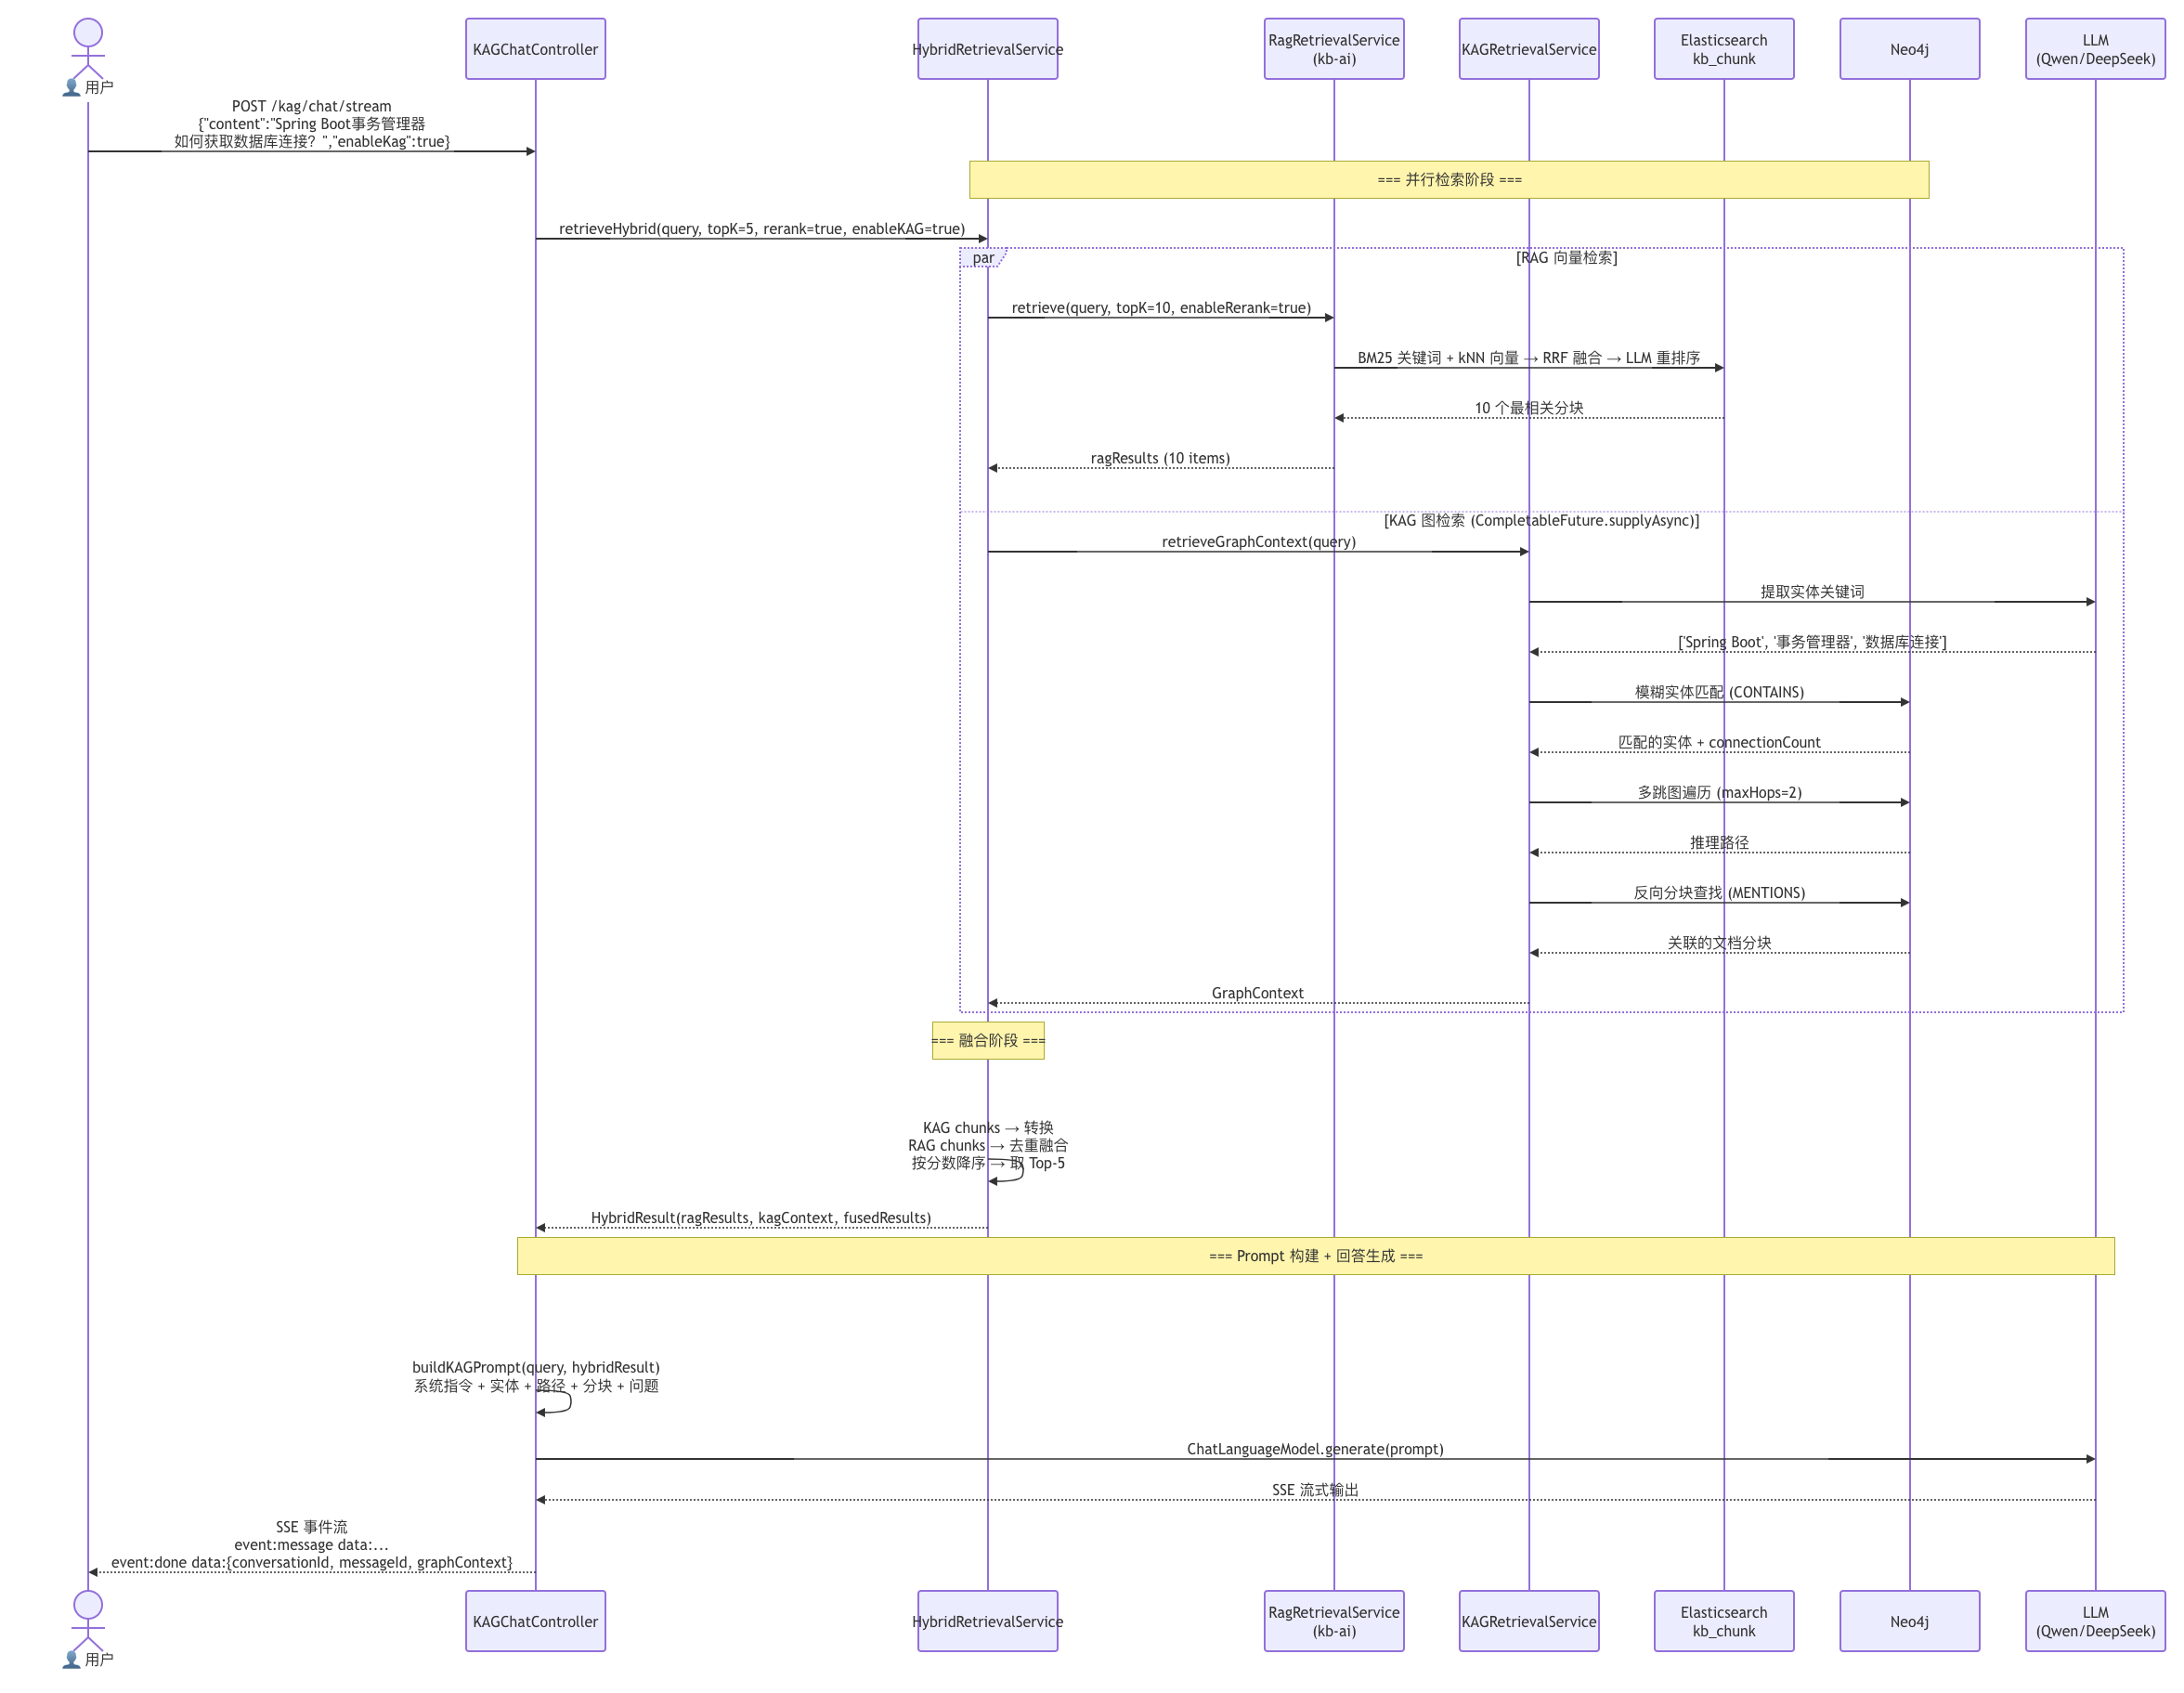
关键设计点:
- RAG 始终执行:即使 KAG 开启,RAG 也并行运行。RAG 结果作为基础,KAG 作为增强
- KAG 分块基准分 0.65:低于 RAG 结果中的高分项(通常 0.8-0.95),但高于低分项。这样 KAG 补充的知识片段不会被 RAG 低分噪音淹没
- 去重策略:RAG 结果去重优先级高于 KAG,同一分块同时出现在两路时保留 RAG 版本(分数更可靠)
- 超时保护:KAG 检索通过
CompletableFuture.get(timeoutSeconds, TimeUnit.SECONDS)控制,默认 10 秒超时后退化为纯 RAG
9. KAG Prompt 构建与上下文注入
9.1 端到端聊天服务
// kb-ai/src/main/java/com/knowledge/base/ai/rag/kag/chat/impl/KAGChatServiceImpl.java
public ChatResponseVO chatWithKnowledgeGraph(ChatRequestDTO requestDTO, Long userId) {
    String query = requestDTO.getContent();

    // Step 1: 混合检索
    HybridResult hybridResult = hybridRetrievalService.retrieveHybrid(
        query, topK = 5, enableRerank = true, enableKAG = requestDTO.getEnableKag()
    );

    // Step 2: 构建 KAG 增强 Prompt
    String prompt = buildKAGPrompt(query, hybridResult);

    // Step 3: LLM 生成
    Response<AiMessage> response = modelProvider.getModel(selectedModel)
        .generate(SystemMessage.from(SYSTEM_INSTRUCTION), UserMessage.from(prompt));

    // Step 4: 构建引用和响应
    List<CitationVO> citations = buildCitations(hybridResult.fusedResults());
    return ChatResponseVO.builder()
        .content(response.content().text())
        .citations(citations)
        .graphContext(hybridResult.kagContext())
        .knowledgeGraphEnhanced(hybridResult.knowledgeGraphEnhanced())
        .build();
}
9.2 KAG Prompt 模板
// KAGChatServiceImpl — buildKAGPrompt()
private String buildKAGPrompt(String query, HybridResult hybridResult) {
    StringBuilder sb = new StringBuilder();

    // ===== 系统指令 =====
    sb.append("你是一个企业知识库助手,具有知识图谱推理能力。\n");
    sb.append("请优先根据以下结构化知识回答用户问题。\n");
    sb.append("如果知识图谱中的推理路径有助于回答,请利用它们。\n");
    sb.append("引用文档资料时,请标注引用编号如 [1]、[2]。\n");
    sb.append("如果没有相关信息,请说明【根据现有知识库暂时无法回答此问题】,不要编造内容。\n");
    sb.append("回答应当专业、准确、简洁。\n\n");

    // ===== 匹配的实体 =====
    GraphContext kag = hybridResult.kagContext();
    if (kag != null && kag.isHasResults()) {
        sb.append("=== 关联的知识实体 ===\n");
        for (GraphEntity entity : kag.getMatchedEntities()) {
            sb.append(String.format("- %s (%s) : %s (关联 %d 个其他实体)\n",
                entity.getName(), entity.getType(),
                entity.getDescription() != null ? entity.getDescription() : "",
                entity.getConnectionCount()));
        }
        sb.append("\n");

        // ===== 推理路径 =====
        if (kag.getReasoningPaths() != null && !kag.getReasoningPaths().isEmpty()) {
            sb.append("=== 知识推理路径 ===\n");
            sb.append("以下是知识图谱中发现的知识关联路径,可能揭示了问题背后隐藏的依赖关系:\n\n");
            for (GraphPath path : kag.getReasoningPaths()) {
                StringBuilder pathStr = new StringBuilder();
                for (int i = 0; i < path.getNodes().size(); i++) {
                    if (i > 0) pathStr.append(" ");
                    pathStr.append(path.getNodes().get(i));
                    if (i < path.getRelations().size()) {
                        pathStr.append(String.format(" →(%s)→", path.getRelations().get(i)));
                    }
                }
                sb.append(String.format("路径 (%.1f跳): %s\n", path.getHops(), pathStr));
            }
            sb.append("\n");
        }
    }

    // ===== 参考资料(融合后分块) =====
    sb.append("=== 参考资料 ===\n");
    List<RagSearchResultVO> context = hybridResult.fusedResults();
    for (int i = 0; i < context.size(); i++) {
        RagSearchResultVO chunk = context.get(i);
        sb.append(String.format("[%d] 来源文档:%s", i + 1, chunk.getDocumentTitle()));
        if (chunk.getHeading() != null && !chunk.getHeading().isEmpty()) {
            sb.append(" | 章节:").append(chunk.getHeading());
        }
        if ("kag".equals(chunk.getSource())) {
            sb.append(" [来自知识图谱]");
        }
        sb.append("\n").append(chunk.getContent()).append("\n\n");
    }

    // ===== 用户问题 =====
    sb.append("=== 用户问题 ===\n");
    sb.append(query);

    return sb.toString();
}
9.3 Prompt 分层对比:标准对话 vs RAG vs RAG+KAG
| Prompt 结构 | 标准对话 | RAG | RAG + KAG |
|---|---|---|---|
| 系统指令 | 基础指令 | + "仅根据参考资料回答" | + "利用推理路径" |
| 关联实体 | — | — | ✓ 实体名 + 类型 + 描述 + 关联数 |
| 推理路径 | — | — | ✓ 多跳路径链 + 关系类型 + 跳数 |
| 参考资料 | — | ✓ 分块 + 来源文档 | ✓ 分块 + 来源 + [kag标记] |
| 用户问题 | ✓ | ✓ | ✓ |
这三者是层层叠加的关系:标准对话 < RAG < RAG + KAG。KAG 的增量价值在于"结构化知识"——告诉 LLM 知识点之间如何关联。
10. 图谱可视化与缓存:Neo4j 读路径全解析
10.1 kb-graph 服务架构
kb-graph 是独立的图谱查询服务,提供两大功能:
- 为 kb-ai 提供图检索数据(通过 Feign 调用,供 KAGRetrievalService 间接使用)
- 为前端提供可视化数据(独立的 GraphController,供 KnowledgeGraphPage 使用)
10.2 Neo4j 节点与关系模型
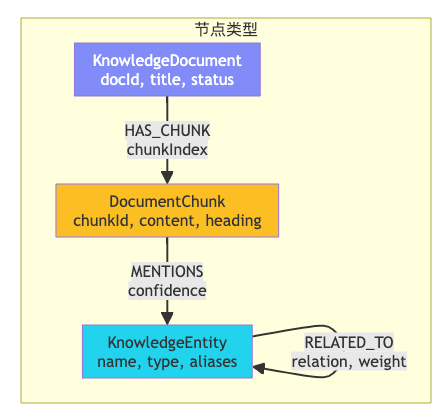
10.3 图谱查询接口
// kb-graph/.../controller/GraphController.java
@RestController
public class GraphController {

    // 获取图谱节点(按类型过滤)
    @GetMapping("/nodes")
    public Result<List<GraphNodeVO>> getNodes(@RequestParam(required = false) String type) {
        // MATCH (n) WHERE labels(n) = type RETURN n, elementId(n) LIMIT 500
    }

    // 获取图谱边(按源/目标类型过滤)
    @GetMapping("/edges")
    public Result<List<GraphEdgeVO>> getEdges(
            @RequestParam(required = false) String sourceType,
            @RequestParam(required = false) String targetType);

    // 获取节点关联(支持 elementId / name / docId 多种查询方式)
    @GetMapping("/node/{nodeId}/relations")
    public Result<List<GraphRelationVO>> getNodeRelations(@PathVariable String nodeId);

    // 全文搜索节点
    @GetMapping("/search")
    public Result<List<GraphNodeVO>> searchGraph(@RequestParam String keyword) {
        // 在 entity.name, entity.aliases, doc.title, chunk.content, chunk.heading 中搜索
    }

    // 路径分析(最短路径 / 指定深度)
    @GetMapping("/path")
    public Result<List<GraphPathVO>> analyzePath(
            @RequestParam String sourceId,
            @RequestParam String targetId,
            @RequestParam(required = false, defaultValue = "3") Integer maxDepth) {
        // shortestPath((a)-[*1..maxDepth]-(b))
    }

    // 社区发现(按度聚类)
    @GetMapping("/community")
    public Result<List<GraphCommunityVO>> detectCommunity(
            @RequestParam(required = false, defaultValue = "degree") String algorithm);

    // 全图数据(nodes + edges)
    @GetMapping("/data")
    public Result<GraphDataVO> getGraphData(
            @RequestParam(required = false) String type);

    // 删除文档的图数据
    @DeleteMapping("/document/{docId}")
    public Result<String> deleteDocumentGraph(@PathVariable Long docId);

    // 清理无效节点
    @PostMapping("/document/cleanup")
    public Result<Integer> cleanupGhostNodes(@RequestBody Map<String, List<Long>> body);

    // 清除所有 Redis 缓存(KAG 重建后调用)
    @PostMapping("/cache/evict")
    public Result<String> evictCache();
}
10.4 Redis 缓存策略
// kb-graph/.../config/CacheConfig.java
@Configuration
@EnableCaching
public class CacheConfig {

    @Bean
    public CacheManager cacheManager(RedisConnectionFactory factory) {
        RedisCacheConfiguration config = RedisCacheConfiguration.defaultCacheConfig()
            .entryTtl(Duration.ofMinutes(30))          // 默认 30 分钟
            .prefixCacheNameWith("kb:graph:")           // 统一前缀
            .serializeValuesWith(
                RedisSerializationContext.SerializationPair
                    .fromSerializer(new Jackson2JsonRedisSerializer<>(Object.class)));

        return RedisCacheManager.builder(factory)
            .cacheDefaults(config)
            .withCacheConfiguration("graphSearch",     // 搜索缓存 10 分钟
                config.entryTtl(Duration.ofMinutes(10)))
            .build();
    }
}
缓存区域与驱逐策略:
| 缓存区域 | TTL | 驱逐触发器 |
|---|---|---|
| graphNodes | 30 min | KAG 构建后 /cache/evict |
| graphEdges | 30 min | KAG 构建后 /cache/evict |
| graphNodeRelations | 30 min | KAG 构建后 /cache/evict |
| graphSearch | 10 min | KAG 构建后 /cache/evict |
| graphPath | 30 min | KAG 构建后 /cache/evict |
| graphCommunity | 30 min | KAG 构建后 /cache/evict |
| graphData | 30 min | KAG 构建后 /cache/evict |
所有缓存方法用 @Cacheable 注解,驱逐用 @CacheEvict(allEntries = true)。特别重要的设计:*KAG 异步构建完成后,通过 *GraphFeignClient.evictAllGraphCaches()** 主动驱逐所有缓存**,确保前端立即看到最新的图谱数据。
10.5 节点可视化映射
// GraphServiceImpl —— 节点样式映射
private String getNodeColor(String type) {
    return switch (type) {
        case "KnowledgeDocument" -> "#818cf8";   // 靛蓝色
        case "KnowledgeEntity"    -> "#22d3ee";   // 青色
        case "DocumentChunk"      -> "#fbbf24";   // 琥珀色
        case "Category"           -> "#a78bfa";   // 紫色
        case "Author"            -> "#f472b6";   // 粉红色
        default                  -> "#6b7280";   // 灰色
    };
}

private int resolveNodeSize(String type) {
    return switch (type) {
        case "KnowledgeDocument" -> 30;
        case "KnowledgeEntity"   -> 25;
        case "DocumentChunk"     -> 20;
        default                  -> 15;
    };
}
前端 KnowledgeGraphPage 使用 ECharts 力导向图渲染:repulsion=200, edgeLength=[80,160], gravity=0.15,支持缩放(20%-300%)、节点悬浮放大(1.4x)、点击查看详情。
11. 降级与容错:每一步都有退路
KAG 链路涉及 LLM API 调用、Neo4j 图查询、RabbitMQ 消息、Redis 缓存等多个外部依赖。
任何一个环节出问题都不能导致系统不可用。
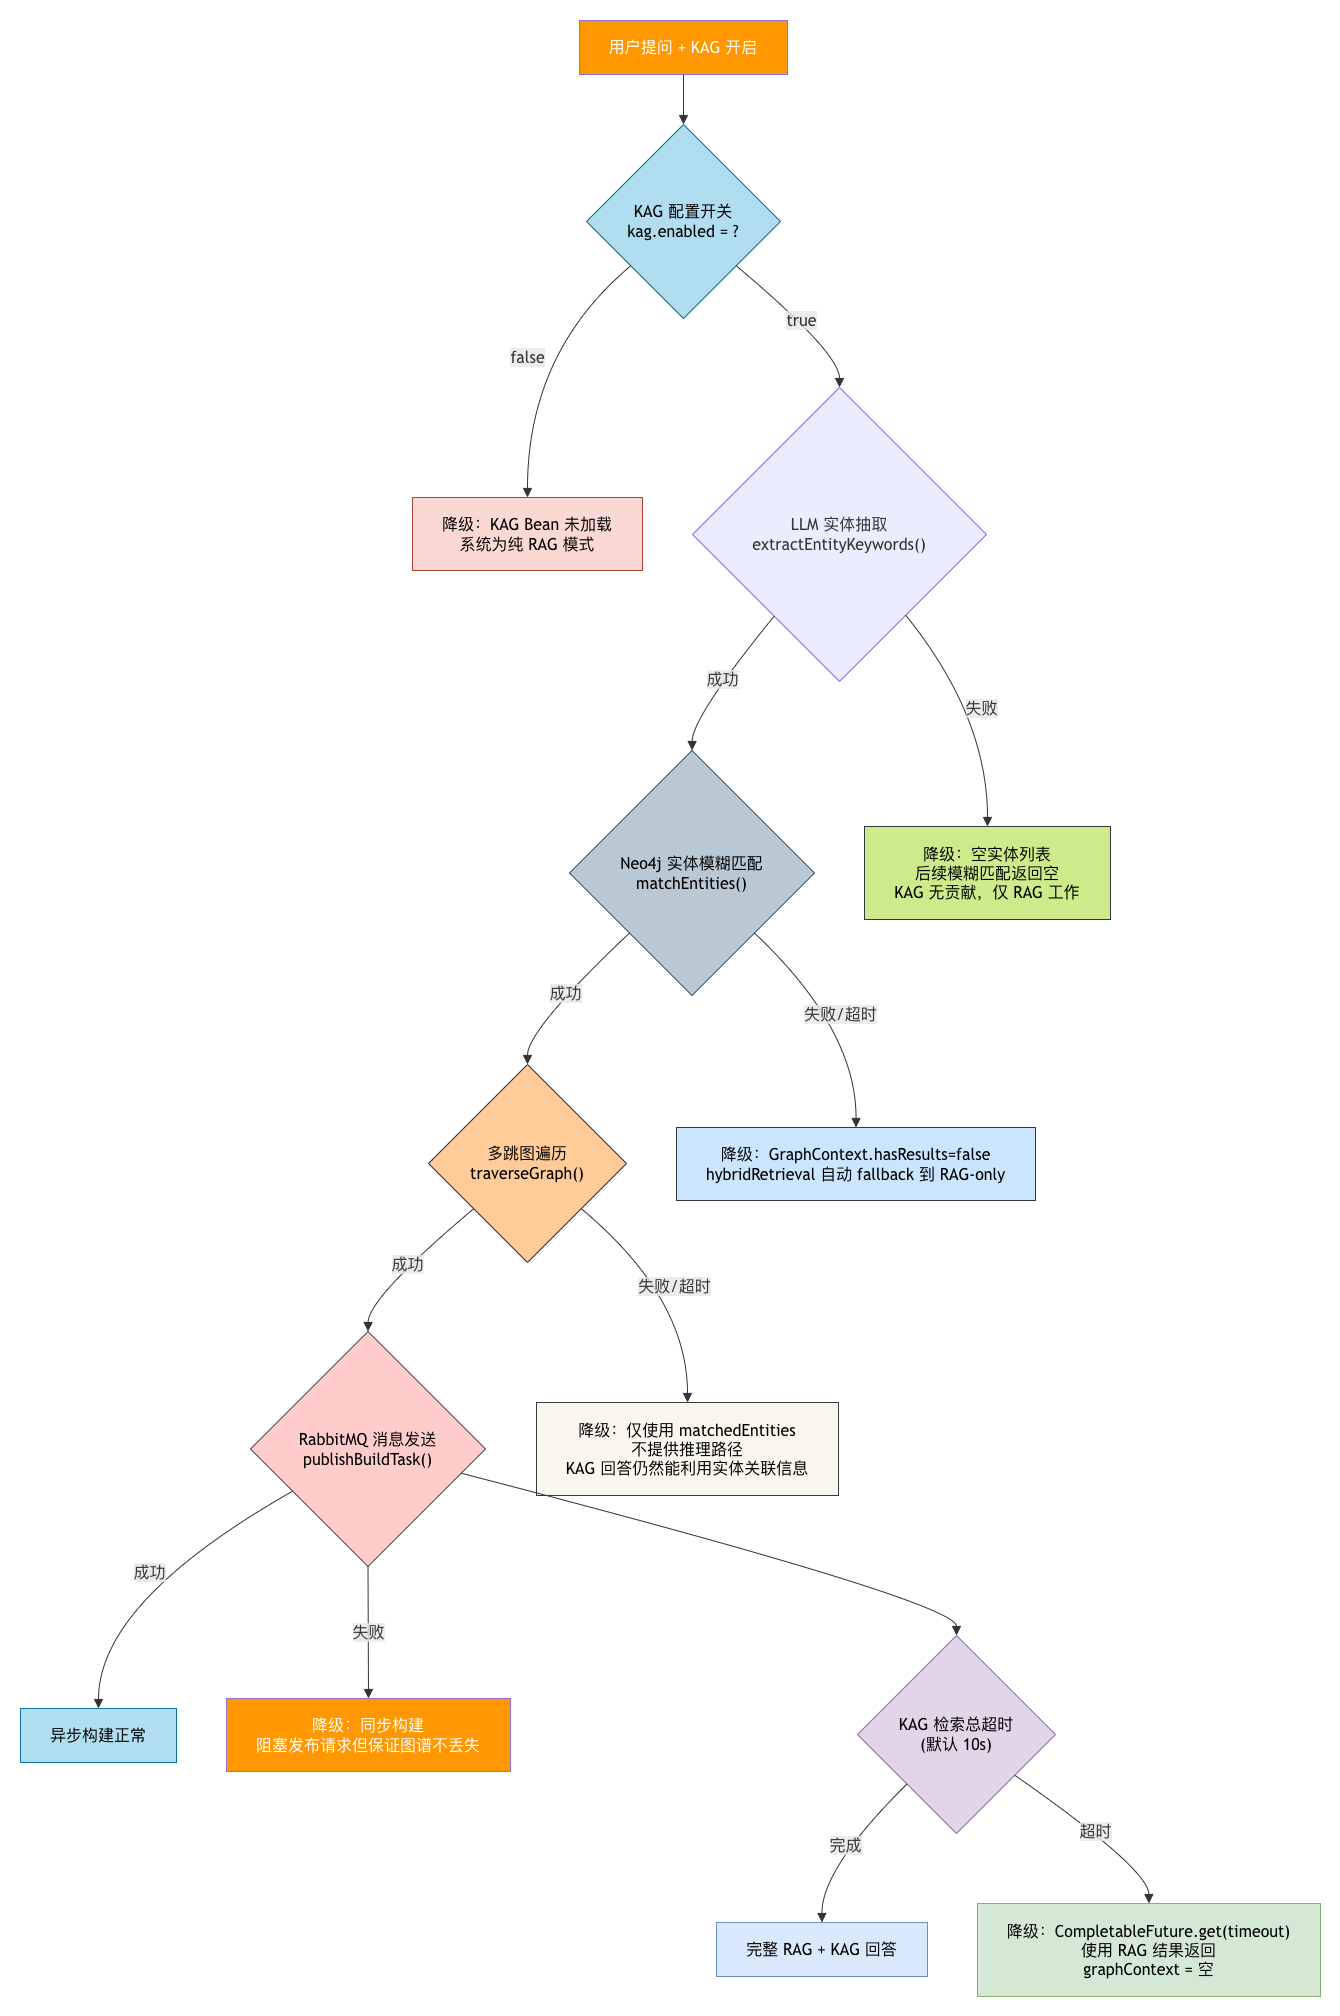
降级层级总结:
| 层级 | 故障点 | 降级行为 | 用户感知 |
|---|---|---|---|
| 1 | kag.enabled=false | KAG Bean 不加载 | 前端无"图谱推理"开关 |
| 2 | LLM 抽取失败 | 空实体列表 | 图谱推理无结果 |
| 3 | Neo4j 查询失败 | hasResults=false | 仅 RAG 回答 |
| 4 | 图遍历失败/超时 | 不返回推理路径 | 有实体但无路径链 |
| 5 | RabbitMQ 不可用 | 同步构建 | 发布稍慢但图谱不丢 |
| 6 | KAG 检索总超时 | CompletableFuture.get(timeout) | 仅 RAG 回答 |
核心原则:KAG 是增强,不是必需。任何 KAG 故障都能降级为纯 RAG 或标准对话,用户始终能得到回答。
12. 前端交互:图谱推理的用户体验
12.1 开关与触发
AIAssistantPage 的工具栏中有两个独立开关:
{/* 知识库增强 (RAG) */}
<Tooltip title="开启后AI将从知识库中检索相关文档辅助回答">
  <Space size={4}>
    <Switch size="small" checked={ragEnabled} onChange={toggleRag} />
    <span>知识库增强</span>
  </Space>
</Tooltip>
{/* 图谱推理 (KAG) */}
<Tooltip title="开启后AI将利用知识图谱进行多跳推理,理解知识之间的关联关系">
  <Space size={4}>
    <Switch size="small" checked={kagEnabled} onChange={toggleKag} />
    <span>图谱推理</span>
  </Space>
</Tooltip>
RAG 和 KAG 是两个独立的开关:
- 仅 RAG:传统知识库检索增强
- 仅 KAG:纯图谱推理(RAG 在同一次调用中仍会并行执行作为基础)
- RAG + KAG:双引擎融合,效果最强
- 都不开:标准 LLM 对话
12.2 KAG 结果展示
当 AI 回答中包含 graphContext 且有结果时,在回答下方渲染紫色的"知识图谱推理"卡片:
{graphContext && graphContext.hasResults && (
  <Card className="kag-result-card"
    style={{
      background: 'linear-gradient(135deg, #f5f3ff 0%, #faf9ff 100%)',
      border: '1px solid #d9d0f0',
      borderRadius: 10,
    }}
  >
    {/* 标题 */}
    <div style={{ display: 'flex', alignItems: 'center', gap: 6 }}>
      <ThunderboltOutlined style={{ color: '#6366f1' }} />
      <Text strong style={{ color: '#374151' }}>知识图谱推理</Text>
    </div>
    {/* 关联实体 */
    {graphContext.entities?.map((entity, idx) => (
      <Tag key={idx} color="purple">{entity.name} ({entity.type})</Tag>
    ))}

    {/* 推理路径 */
    {graphContext.paths?.map((path, idx) => (
      <div key={idx} className="reasoning-path">
        {path.nodes.join(' → ')}
        <span className="hop-count">({path.hops}跳)</span>
      </div>
    ))}
  </Card>
)}
12.3 独立图谱可视化页面
KnowledgeGraphPage.tsx 提供独立的图谱可视化界面:
- 力导向图:ECharts force-directed layout,三类节点不同颜色/大小
- 节点过滤:按类型(KnowledgeDocument / KnowledgeEntity / DocumentChunk)切换显示
- 搜索:关键词搜索图谱节点
- 节点详情:点击节点查看属性、描述、关联关系
- 重建图谱:手动触发 KAG 全量重建
- 缩放与布局:20%-300% 缩放、适应画布、重置视图
12.4 KAG 流式响应处理
// ai.service.ts — askStream()
const response = await fetch('/api/ai/chat/stream', {
    body: JSON.stringify({
        content: data.question,
        enableRag: data.context?.knowledgeBase === true,
        enableKag: data.context?.enableKag === true,
        // ...
    }),
});

// SSE 逐 Token 解析
// event:message → data: <token> → onMessage(token)
// event:done   → data: { conversationId, messageId, citations, graphContext }
// event:error  → data: <error message> → onError(msg)
在 done 事件中,后端返回的 graphContext 被存储到 AIMessage.graphContext 字段,供 AIMessageBubble 组件渲染。流式响应过程与标准 RAG 完全一致。
总结
- 真并行双引擎:RAG 和 KAG 通过
CompletableFuture.runAsync在同一请求中并行执行,不是串行等 RAG 结果再做 KAG。用户感知的总延迟 = max(RAG 延迟, KAG 延迟),而非两者之和。 - 配置驱动的降级体系:6 级降级从总开关(
kag.enabled)到子模块超时(retrieval.timeoutSeconds),每一级都可以独立控制。即使在 KAG 完全不可用的情况下,系统退化为纯 RAG 模式,用户不会得到空响应。 - 三阶段实体归一化:同名合并 → 已有匹配 → 相似度合并,从精确到模糊逐步去重。0.85 的 Levenshtein 阈值既能合并等价实体,又不会错误合并不同的技术概念。
- 异步构建 + 同步兜底:RabbitMQ 发布失败自动回退到同步构建,保证图谱最终一致性。DLQ(死信队列)设计确保失败消息不会丢失。
- Redis 缓存 + 主动驱逐:图谱查询缓存在 Redis 中(30 分钟 TTL),KAG 构建完成后主动调用
/cache/evict使所有缓存失效,避免前端看到旧数据。 - 独立的 KAG 检索检索服务:
KAGRetrievalService既可以作为KAGChatService的子模块,也可以独立被POST /kag/search调用。这使得图谱检索能力可以脱离对话单独使用。
适用场景
KAG 最适合以下场景:
- 关系型查询:"A 和 B 是什么关系?"、"X 依赖哪些组件?"
- 多跳推理:"要实现 Y 功能,需要配置哪些模块?"
- 知识探索:从某个概念出发,探索其在整个知识体系中与其他概念的关联
在这些场景中,RAG + KAG 双引擎融合的效果远超纯 RAG。
