前言
企业智能知识库系统的检索需求不同于简单的数据库 LIKE 查询。
随着知识文档的积累,用户需要:
- 中文分词精准匹配:"人工智能应用" 匹配到 "AI 技术在实际业务中的应用" —— 需要分词器理解中文语义
- 相关度排序:标题命中比内容命中更相关,摘要命中权重居中
- 关键词高亮:搜索结果中预匹配词高亮,帮助用户快速定位
- 语义理解:用户搜索 "怎么提高效率" → 向量检索匹配到包含 "工作效率提升方法" 的文档
- 实时索引同步:文档发布/更新/删除后立即同步到搜索引擎
本系统的检索架构采用 Elasticsearch 8.x + IK 中文分词(关键词搜索) + 向量嵌入(混合智能搜索) 双模设计。kb-search 服务提供全文检索、搜索建议、热门搜索和搜索历史管理;kb-ai 服务提供 BM25 + kNN 向量 + RRF 融合 + LLM 重排序的混合智能搜索能力。
1. 先结论:一次搜索请求走了什么链路
以用户在搜索框输入"知识图谱应用",选择"关键词搜索"模式为例:
用户在 SearchPage 输入 "知识图谱应用",按回车
  → 前端 POST /search { keyword: "知识图谱应用", searchMode: "keyword", current: 1, size: 10 }
  → SearchController.search(dto)
       ├── searchService.search(dto)
       │     └── searchMode = "keyword" → searchKeyword(dto)
       │           ├── 构建 ES native query(co.elastic.clients)
       │           │     └── multi_match: "知识图谱应用"
       │           │           fields: ["title^2", "summary^1.5", "content"]
       │           │           filter: docStatus = 1(仅已发布文档)
       │           ├── ES 返回 hits(BM25 评分排序)
       │           │     ├── hit_1: title="知识图谱在金融领域的应用" → score 18.5
       │           │     ├── hit_2: title="企业知识管理方案" → content中含"知识图谱" → score 12.3
       │           │     └── ...
       │           ├── 提取 highlight 片段
       │           │     ├── title: "<em>知识图谱</em>在金融领域的<em>应用</em>"
       │           │     ├── content fragments: ["本文介绍<em>知识图谱</em>的构建...", ...]
       │           │     └── mergeAdjacentEmTags() 合并 IK 分词造成的碎片化标签
       │           └── 组装 SearchResultVO 列表 → 分页结果
       └── searchHistoryService.saveSearchHistoryAsync(userId, keyword)
             → 异步保存搜索历史到 MySQL kb_search_history 表

  → 前端收到响应,渲染搜索结果卡片:
       ├── 标题(含 <em> 高亮标签渲染为黄色标记)
       ├── 摘要/正文高亮片段
       ├── 元数据(分类、作者、发布时间、浏览量)
       └── 相关度得分(带颜色标识:>80% 绿色, >60% 琥珀色, >40% 橙色, 其余灰色)
2. Elasticsearch 集群与索引设计
2.1 ES 客户端配置
kb-search 和 kb-ai 各自维护独立的 ES 客户端 Bean:
// kb-search/.../config/ElasticsearchConfig.java
@Configuration
public class ElasticsearchConfig {

    @Value("${spring.elasticsearch.host:117.72.88.11}")
    private String host;

    @Value("${spring.elasticsearch.port:9200}")
    private int port;

    @Bean
    public ElasticsearchClient elasticsearchClient() {
        RestClient restClient = RestClient.builder(
                new HttpHost(host, port, "http")).build();
        ElasticsearchTransport transport = new RestClientTransport(
                restClient, new JacksonJsonpMapper());
        return new ElasticsearchClient(transport);
    }

    // kb-ai 另有独立的 ElasticsearchConfig,条件创建(rag.enabled=true)
}
2.2 两个 ES 索引
| 索引 | 所属服务 | 用途 | 关键字段 |
|---|---|---|---|
kb_document | kb-search (8083) | 文档全文检索 | title, summary, content (ik\_max\_word), 元数据字段 |
kb_chunk | kb-ai (8086) | RAG 语义检索 | content, embedding (dense\_vector 1024d), document\_title |
2.3 kb\_document 索引——文档实体
// kb-search/.../entity/DocumentIndex.java
@Data
@Builder
@NoArgsConstructor
@AllArgsConstructor
@Document(indexName = "kb_document", createIndex = false)
public class DocumentIndex {

    @Id
    private String id;

    @Field(type = FieldType.Text, analyzer = "ik_max_word")
    private String title;                     // 标题(IK 分词)

    @Field(type = FieldType.Text, analyzer = "ik_max_word")
    private String summary;                   // 摘要(IK 分词)

    @Field(type = FieldType.Text, analyzer = "ik_max_word")
    private String content;                   // 正文(IK 分词)

    @Field(type = FieldType.Long)
    private Long categoryId;

    @Field(type = FieldType.Keyword)
    private String categoryName;

    @Field(type = FieldType.Long)
    private List<Long> tagIds;

    @Field(type = FieldType.Keyword)
    private List<String> tagNames;

    @Field(type = FieldType.Long)
    private Long creatorId;

    @Field(type = FieldType.Keyword)
    private String creatorName;

    @Field(type = FieldType.Long)
    private Long teamId;

    @Field(type = FieldType.Keyword)
    private String teamName;

    @Field(type = FieldType.Integer)
    private Integer docStatus;               // 文档状态(1=已发布)

    @Field(type = FieldType.Integer)
    private Integer viewCount;

    @Field(type = FieldType.Integer)
    private Integer likeCount;

    @Field(type = FieldType.Integer)
    private Integer commentCount;

    @Field(type = FieldType.Boolean)
    private Boolean isPublic;

    @Field(type = FieldType.Keyword)
    private String publishAt;

    @Field(type = FieldType.Keyword)
    private String createdAt;

    @Field(type = FieldType.Keyword)
    private String updatedAt;
}
2.4 kb\_chunk 索引——向量检索
kb-ai 服务的 kb_chunk 索引同时存储文本和向量:
// kb-ai/.../rag/entity/KbChunkDoc.java
@Document(indexName = "kb_chunk", createIndex = false)
public class KbChunkDoc {
    @Id
    private String chunkId;
    private Long documentId;
    private String documentTitle;    // text + keyword 子字段
    private String content;          // text
    private String heading;          // keyword
    private Integer chunkIndex;
    private Integer totalChunks;
    private Long categoryId;
    private Long authorId;
    private Long teamId;
    private Integer docStatus;
    private Date publishTime;
    private Date indexedAt;
    // embedding 字段通过低级 ES client 操作:dense_vector(1024d, cosine)
}
索引创建时的 mappings 配置:
// VectorIndexServiceImpl.createIndexIfNotExists()
.properties("content", p -> p.text(t -> t))
.properties("embedding", p -> p.denseVector(dv -> dv
    .dims(1024)                         // Qwen text-embedding-v3 输出维度
    .index(true)
    .similarity("cosine")))             // 余弦相似度
2.5 索引设置
| 参数 | kb\_document | kb\_chunk |
|---|---|---|
| 分片数 (shards) | 1 | 3 |
| 副本数 (replicas) | 0 | 1 |
| 刷新间隔 (refresh\_interval) | 5s | 5s |
| 分词器 | ik\_max\_word(中文) | standard(默认) |
| 日期格式 | keyword(字符串存储,避免日期格式解析冲突) | date |
设计考量:
| 决策 | 理由 |
|---|---|
publishAt/createdAt 使用 keyword 而非 date | 避免 MySQL datetime 格式与 ES date 解析不一致导致的映射异常 |
title 同时建 keyword 子字段 | 用于搜索建议的 prefix 查询 |
| kb\_document 1 分片 0 副本 | 单机 ES,减少资源浪费;可随数据量增长调整 |
| kb\_chunk 3 分片 1 副本 | 向量检索开销大,多分片分散查询负载 |
3. 关键词搜索:BM25 + IK 分词 + 多字段加权
3.1 IK 分词器
中文搜索的核心挑战是分词。ES 内置的 standard 分词器对中文按字切分,无法理解词级语义。因此系统引入 **IK Analysis 插件**(ik_max_word 模式),将中文文本切分为有意义的词组:
输入:"企业智能知识库系统之全文检索设计"
standard → [企, 业, 智, 能, 知, 识, 库, 系, 统, 之, 全, 文, 检, 索, 设, 计]
ik_max_word → [企业, 智能, 知识库, 知识, 库系统, 系统, 全文检索, 全文, 检索, 设计]
在 DocumentIndex 实体中,title、summary、content 三个字段均标注了 analyzer = "ik_max_word",写入时按此分词建立倒排索引。
3.2 多字段加权查询
// SearchServiceImpl.searchKeyword() 第 119 行
SearchResponse<Map> response = esClient.search(s -> {
    s.index(INDEX_NAME)
     .from((dto.getCurrent() - 1) * dto.getSize())
     .size(dto.getSize());

    // 有关键词时:multi_match 加权 + 已发布过滤
    if (StringUtils.hasText(keyword)) {
        s.query(q -> q.bool(b -> b
                .must(m -> m.multiMatch(mm -> mm
                        .query(keyword)
                        .fields("title^2", "summary^1.5", "content")))
                .filter(f -> f.term(t -> t.field("docStatus").value(1)))));
    } else {
        // 无关键词时:仅过滤已发布
        s.query(q -> q.bool(b -> b
                .filter(f -> f.term(t -> t.field("docStatus").value(1)))));
    }

    return s;
}, Map.class);查询结构解析:
bool query:
  ├── must: multi_match("知识图谱应用", fields=["title^2", "summary^1.5", "content"])
  │       └── title 命中权重 × 2,summary 命中权重 × 1.5,content 默认权重
  └── filter: term(docStatus = 1)
            └── 只返回已发布文档,不参与评分
filter 子句不参与 \_score 计算,确保只有已发布文档被返回,同时保持排序由 must 子句的 BM25 评分主导。
3.3 高亮配置
s.highlight(h -> h
    .preTags("<em>").postTags("</em>")
    .fields("title", hf -> hf.numberOfFragments(0))    // 返回完整字段
    .fields("summary", hf -> hf.numberOfFragments(0))   // 返回完整字段
.fields("content", hf -> hf.fragmentSize(150).numberOfFragments(3))); // 3个片段title和summary:numberOfFragments(0)返回字段全文,适合短文本content:fragmentSize(150)+numberOfFragments(3)返回 3 个 150 字符的上下文片段
3.4 高亮后处理
由于 IK 分词器可能将一个词切分为多个 token,ES highlight 可能产生碎片化的 <em> 标签:
原文:知识图谱在金融领域的应用
IK 分词:[知识图谱, 在, 金融, 领域, 的, 应用]
ES 高亮:<em>知识图谱</em>在<em>金融</em><em>领域</em>的<em>应用</em>
系统使用 mergeAdjacentEmTags() 合并相邻标签:
// SearchServiceImpl.java 第 680 行
private String mergeAdjacentEmTags(String text) {
    return text.replace("</em><em>", "");
    // 结果:<em>知识图谱</em>在<em>金融领域</em>的<em>应用</em>
}
当 ES 未返回高亮时(如通配符搜索),使用简单正则兜底:
// SearchServiceImpl.java 第 692 行
private String highlightSimple(String text, String keyword) {
    String escaped = Pattern.quote(keyword);
    return text.replaceAll("(?i)" + escaped, "<em>$0</em>");
}
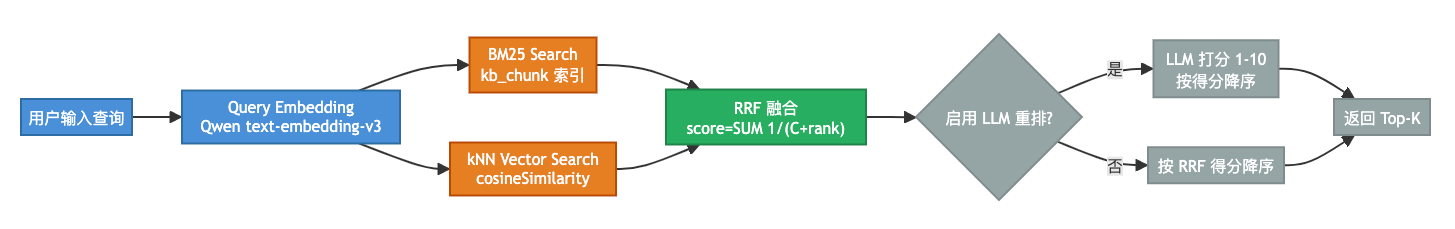
4. 混合智能搜索:BM25 + kNN + RRF + LLM 重排序
4.1 总体流程
混合智能搜索入口在 kb-search 的 searchHybrid() 方法中,通过 Feign 调用 kb-ai 服务的 /rag/search 接口:
4.2 查询 embedding
// RagRetrievalServiceImpl.retrieve() 第 48 行
public List<RagSearchResultVO> retrieve(String query, int topK, boolean enableRerank) {
    // 1. 创建索引(如果不存在)
    vectorIndexService.createIndexIfNotExists();

    // 2. 生成查询向量(失败时降级为 BM25-only 搜索)
    float[] queryEmbedding = null;
    try {
        queryEmbedding = embeddingService.embed(query);
        // 调用 Qwen text-embedding-v3 → 输出 1024 维浮点向量
    } catch (Exception e) {
        log.warn("查询嵌入失败,降级为 BM25-only 搜索:{}", e.getMessage());
    }

    // 3. 混合搜索(BM25 + kNN + RRF),取 2 倍 topK 作为候选
    int candidateK = Math.max(topK * 2, hybridTopK);
    List<RagSearchResultVO> candidates = vectorIndexService.searchHybrid(
            query, queryEmbedding, candidateK, hybridTopK, rrfC);

    // 4. LLM 重排序(可选)
    if (enableRerank && candidates.size() > topK) {
        candidates = rerank(candidates, query, topK);
    }
    return candidates;
}
关键设计——embedding 失败降级:如果 Qwen embedding 服务不可达,queryEmbedding 为 null,kNN 搜索的 script_score 查询不执行,仅执行 BM25 搜索。整个搜索流程不会因 AI 服务故障而阻断。
4.3 BM25 + kNN 并行搜索
// VectorIndexServiceImpl.searchHybrid() 第 124 行
// BM25 和 kNN 并行执行
CompletableFuture<List<RagSearchResultVO>> bm25Future =
    CompletableFuture.supplyAsync(() -> searchBM25(query, topK));

CompletableFuture<List<RagSearchResultVO>> knnFuture =
    CompletableFuture.supplyAsync(() -> {
        if (queryEmbedding == null) return List.of();
        return searchKnn(queryEmbedding, topK);
    });

// 等待两个结果并 RRF 融合
List<RagSearchResultVO> bm25Results = bm25Future.get(5, TimeUnit.SECONDS);
List<RagSearchResultVO> knnResults = knnFuture.get(5, TimeUnit.SECONDS);
List<RagSearchResultVO> fused = rrfFusion(bm25Results, knnResults, rrfC);
kNN 搜索使用 ES script_score 查询,计算余弦相似度:
{
  "script_score": {
    "query": { "match_all": {} },
    "script": {
      "source": "cosineSimilarity(params.query_vector, 'embedding') + 1.0",
      "params": { "query_vector": [0.12, -0.34, ..., 0.78] }
    }
  }
}
+ 1.0 将余弦相似度从 [-1, 1] 映射到 [0, 2],确保分数为正数,便于 RRF 融合。
4.4 RRF(Reciprocal Rank Fusion)融合
RRF 是一种简单有效的多路召回融合算法,不需要归一化分数:
RRF_score(d) = SUM_{r ∈ {bm25, knn}} 1 / (C + rank_r(d))其中 C = 60(可配置)。RRF 只使用排名而非原始分数,避免了 BM25 和余弦相似度两种不同量纲分数直接相加的问题。
// VectorIndexServiceImpl.java
private List<RagSearchResultVO> rrfFusion(
        List<RagSearchResultVO> bm25Results,
        List<RagSearchResultVO> knnResults, int C) {
    Map<String, Double> rrfScores = new ConcurrentHashMap<>();

    // 收集 BM25 排名
    for (int i = 0; i < bm25Results.size(); i++) {
        String id = bm25Results.get(i).getChunkId();
        rrfScores.merge(id, 1.0 / (C + i + 1), Double::sum);
    }

    // 收集 kNN 排名
    for (int i = 0; i < knnResults.size(); i++) {
        String id = knnResults.get(i).getChunkId();
        rrfScores.merge(id, 1.0 / (C + i + 1), Double::sum);
    }

    // 按 RRF 分数降序排列
    return rrfScores.entrySet().stream()
        .sorted(Map.Entry.<String, Double>comparingByValue().reversed())
        .map(e -> buildResult(e.getKey(), e.getValue(), bm25Results, knnResults))
        .collect(Collectors.toList());
}
4.5 LLM 重排序
对于融合后的候选集,可选调用 LLM 进行精排:
// RagRetrievalServiceImpl.rerank() 第 89 行
private List<RagSearchResultVO> rerank(List<RagSearchResultVO> candidates,
                                        String query, int topK) {
    ChatLanguageModel model = modelProvider.getDefaultModel();

    List<ScoredChunk> scored = new ArrayList<>();
    for (RagSearchResultVO candidate : candidates) {
        String prompt = """
            你是一个搜索相关性评估专家。请根据查询和文档片段的相关程度打分。
            评分范围 1-10(1=完全不相关,10=完全相关)。
            只输出一个数字。

            查询:%s
            文档片段:%s
        """.formatted(query, candidate.getContent());

        String response = model.generate(UserMessage.from(prompt)).content().text();
        int score = parseRelevanceScore(response);  // 正则提取 1-10 数字
        scored.add(new ScoredChunk(candidate, score));
    }

    return scored.stream()
        .sorted(Comparator.comparingInt(ScoredChunk::getScore).reversed())
        .limit(topK)
        .map(ScoredChunk::getCandidate)
        .collect(Collectors.toList());
}
每个候选 chunk 单独调用一次 LLM,获得 1-10 的相关性评分。这种"逐条打分"模式比让 LLM 直接排序更稳定——LLM 在比较任务上容易出现位置偏差。
4.6 混合搜索的自动降级
// SearchServiceImpl.searchHybrid() 第 343 行
} catch (Exception e) {
    log.error("混合智能搜索失败,回退到关键词搜索:{}", e.getMessage(), e);
    return searchKeyword(dto);
}
如果 kb-ai 服务不可达或 Feign 调用超时,自动降级为关键词搜索。用户体验不中断。
5. 搜索建议、热门搜索与搜索历史
5.1 搜索建议(Prefix 查询)
// SearchServiceImpl.suggest() 第 429 行
public List<SearchSuggestVO> suggest(String keyword, Integer size) {
    // 使用 prefix 查询匹配 title.keyword 子字段
    String queryJson = objectMapper.writeValueAsString(
            Map.of("prefix", Map.of("title.keyword", keyword)));
    Query searchQuery = new StringQuery(queryJson);
    searchQuery.setPageable(PageRequest.of(0, size));

    SearchHits<DocumentIndex> searchHits = elasticsearchOperations.search(searchQuery, DocumentIndex.class);

    return searchHits.getSearchHits().stream()
            .map(hit -> SearchSuggestVO.builder()
                    .text(hit.getContent().getTitle())
                    .type("title")
                    .documentId(Long.parseLong(hit.getId()))
                    .build())
            .collect(Collectors.toList());
}
title.keyword 是 title 字段的 keyword 子字段,存储完整原始字符串。prefix 查询匹配前缀,如输入 "知识图谱" → 匹配 "知识图谱在金融领域的应用" 等标题。
5.2 热门搜索
热门搜索基于 MySQL kb_search_history 表中最近 7 天的搜索记录统计:
<!-- SearchHistoryMapper.xml -->
<select id="selectHotKeywordsByUserId" resultType="string">
    SELECT keyword FROM kb_search_history
    WHERE user_id = #{userId}
      AND created_at >= DATE_SUB(NOW(), INTERVAL 7 DAY)
    GROUP BY keyword
    ORDER BY COUNT(*) DESC, MAX(created_at) DESC
    LIMIT #{limit}
</select>
5.3 搜索历史实体
// kb-search/.../entity/SearchHistory.java
@Data
@EqualsAndHashCode(callSuper = true)
@TableName("kb_search_history")
public class SearchHistory extends BaseEntity {
    @TableField("user_id")
    private Long userId;
    @TableField("keyword")
    private String keyword;
    @TableField("search_count")
    private Integer searchCount;
}
CREATE TABLE `kb_search_history` (
`id` BIGINT NOT NULL COMMENT '搜索历史ID',
`user_id` BIGINT NOT NULL COMMENT '用户ID',
`keyword` VARCHAR(200) NOT NULL COMMENT '搜索关键词',
`search_count` INT DEFAULT 0 COMMENT '搜索次数',
`created_at` DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '搜索时间',
PRIMARY KEY (`id`),
KEY `idx_user_id` (`user_id`),
KEY `idx_keyword` (`keyword`(100)),
KEY `idx_create_time` (`created_at`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;历史保存采用异步方式,不阻塞搜索主流程:
// SearchHistoryServiceImpl
public void saveSearchHistoryAsync(Long userId, String keyword) {
    CompletableFuture.runAsync(() -> {
        // ON DUPLICATE KEY UPDATE: 同用户同关键词则增加搜索次数
        searchHistoryMapper.insertOrUpdate(userId, keyword);
    });
}
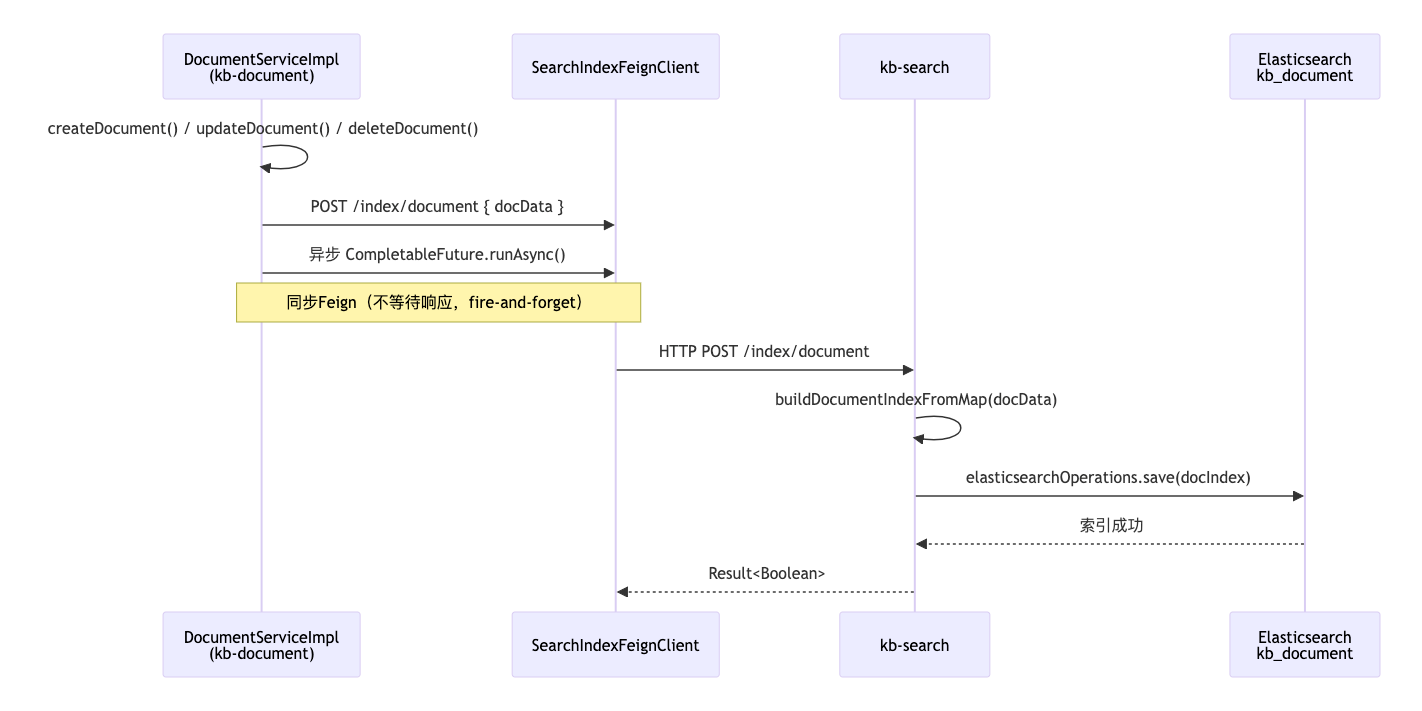
6. 索引同步:文档 CRUD 触发实时索引
6.1 同步 Trigger 调用链
6.2 文档操作触发索引
DocumentServiceImpl 中的每个文档操作完成后,通过异步调用触发三种索引同步:
// kb-document/.../DocumentServiceImpl.java
// 创建文档后(status=1 时触发)
triggerRagReindex(document.getId());     // Feign → kb-ai RAG 向量索引
triggerKAGBuild(document.getId());       // Feign → kb-ai KAG 图谱构建
triggerSearchIndex(document, content);    // Feign → kb-search ES 索引

// 更新文档后(内容变化或草稿→发布时触发)
if (contentChanged || draftToPublished) {
    triggerRagReindex(docId);
    triggerKAGBuild(docId);
    triggerSearchIndex(syncDoc, content);    // 更新 ES 索引
}

// 发布→下架时触发删除
if (publishedToUnpublished) {
    triggerRagDelete(docId);
    triggerKAGDelete(docId);
    triggerSearchDelete(docId);              // 从 ES 删除
}

// 删除文档时触发三个索引的删除
triggerRagDelete(documentId);
triggerKAGDelete(documentId);
triggerSearchDelete(documentId);
6.3 Feign 接口——文档到搜索的桥梁
// kb-document/.../feign/SearchIndexFeignClient.java
@FeignClient(name = "kb-search", path = "/index", contextId = "searchIndexFeignClient")
public interface SearchIndexFeignClient {

    @PostMapping("/document")
    Result<Boolean> indexDocument(@RequestBody Map<String, Object> docData);

    @DeleteMapping("/document/{documentId}")
    Result<Boolean> deleteDocumentIndex(@PathVariable("documentId") Long documentId);
}
// kb-document/.../feign/RagFeignClient.java
@FeignClient(name = "kb-ai", path = "/rag/reindex", contextId = "ragFeignClient")
public interface RagFeignClient {
@PostMapping("/{docId}")
Result<String> reindexDocument(@PathVariable("docId") Long docId);
@DeleteMapping("/{docId}")
Result<String> removeFromIndex(@PathVariable("docId") Long docId);
}// kb-document/.../feign/KAGFeignClient.java
@FeignClient(name = "kb-ai", path = "/kag/build", contextId = "kagFeignClient")
public interface KAGFeignClient {
@PostMapping("/{docId}")
Result<String> buildGraph(@PathVariable("docId") Long docId);
@DeleteMapping("/{docId}")
Result<String> deleteGraph(@PathVariable("docId") Long docId);
}6.4 kb-search 的索引数据接收
// SearchController.java
@PostMapping("/index/document")
public Result<Boolean> indexDocument(@RequestBody Map<String, Object> docData) {
    searchService.indexDocumentData(docData);
    return Result.success(true);
}

// SearchServiceImpl.indexDocumentData()
public void indexDocumentData(Map<String, Object> docData) {
    DocumentIndex docIndex = buildDocumentIndexFromMap(docData);
    elasticsearchOperations.save(docIndex);
}
buildDocumentIndexFromMap() 从 kb-document 传来的 Map 中提取字段,构建 DocumentIndex 对象后写入 ES。使用 elasticsearchOperations.save() 的 upsert 语义——文档 ID 已存在则更新,不存在则新增。
6.5 异步触发确保主流程不受影响
// DocumentServiceImpl 中的所有索引触发均使用 CompletableFuture
private void triggerSearchIndex(Document doc, String content) {
    CompletableFuture.runAsync(() -> {
        try {
            Map<String, Object> data = buildDocDataMap(doc, content);
            searchIndexFeignClient.indexDocument(data);
        } catch (Exception e) {
            log.warn("搜索索引同步失败(不影响文档操作):docId={}, error={}",
                    doc.getId(), e.getMessage());
        }
    }, asyncTaskExecutor);
}
索引同步的失败不影响文档 CRUD 操作的结果返回。异常被捕获并仅记录日志——搜索索引的最终一致性由后续的定时全量重建保证。
7. 索引管理与重建
7.1 单文档索引与删除
// SearchServiceImpl.indexDocumentData()
public void indexDocumentData(Map<String, Object> docData) {
    DocumentIndex docIndex = buildDocumentIndexFromMap(docData);
    elasticsearchOperations.save(docIndex);   // upsert 语义
}

// SearchServiceImpl.deleteDocument()
public void deleteDocument(Long documentId) {
    elasticsearchOperations.delete(String.valueOf(documentId), DocumentIndex.class);
}
7.2 全量索引重建
POST /index/rebuild 接口用于重建整个 kb_document 索引:
// SearchServiceImpl.rebuildIndex() 第 576 行
public void rebuildIndex() {
    // 1. 删除旧索引
    if (esClient.indices().exists(ExistsRequest.of(e -> e.index(INDEX_NAME))).value()) {
        esClient.indices().delete(DeleteIndexRequest.of(d -> d.index(INDEX_NAME)));
    }

    // 2. 创建新索引(显式 mappings 和 settings)
    CreateIndexRequest createRequest = CreateIndexRequest.of(c -> c
            .index(INDEX_NAME)
            .settings(s -> s
                    .numberOfShards("1")
                    .numberOfReplicas("0")
                    .refreshInterval(ri -> ri.time("5s")))
            .mappings(m -> m
                    .properties("title", p -> p.text(t -> t.fields("keyword", f -> f.keyword(k -> k))))
                    .properties("summary", p -> p.text(t -> t))
                    .properties("content", p -> p.text(t -> t))
                    .properties("docStatus", p -> p.integer(i -> i))
                    // ... 其他字段
            ));
    esClient.indices().create(createRequest);

    // 3. 分页从 kb-document 拉取所有已发布文档并逐条索引
    long current = 1;
    long pageSize = 50;
    while (hasMore) {
        // GET /documents/page?current={current}&size={pageSize}&status=1
        String pageUrl = kbDocumentBaseUrl + "/documents/page?current=" + current
                + "&size=" + pageSize + "&status=1";
        ResponseEntity<String> response = restTemplate.exchange(pageUrl, ...);
        // 解析响应,逐条调用 elasticsearchOperations.save()
    }
}重建流程:
- 删除旧索引 → 创建新索引(含完整 mappings)
- 通过 REST API 分页拉取
kb-document中的已发布文档(status=1) - 逐条写入 ES(
elasticsearchOperations.save())
这种方式确保了索引的 mappings 始终与代码一致,避免了动态映射导致的不一致问题(如日期格式冲突)。
7.3 RAG 索引重建(kb\_chunk)
kb-ai 服务中的 RAG 索引重建通过 RabbitMQ 异步进行:
| 接口 | MQ 路由键 | 功能 |
|---|---|---|
POST /rag/reindex/{docId} | rag.reindex.{instanceId}.by_ids | 重索引单个文档 |
POST /rag/reindex/batch | rag.reindex.{instanceId}.by_ids | 批量重索引 |
POST /rag/reindex/all | rag.reindex.{instanceId}.all | 全量重索引 |
DELETE /rag/reindex/{docId} | rag.reindex.{instanceId}.delete | 删除文档向量 |
消费者 ReindexConsumer 处理消息:
- 加载文档详情 → 分块(ChunkingService) → 生成向量(EmbeddingService) → 批量写入 ES(VectorIndexService)
进度通过 Redis key rag:reindex:progress:{taskId} 追踪(1 小时 TTL)。
8. 搜索 REST API
kb-search 服务在 / 路径下提供搜索接口:
| 方法 | 路径 | 功能 | 说明 |
|---|---|---|---|
POST | /search | 全文搜索 | 支持 keyword/hybrid 双模式 |
POST | /search/advanced | 高级搜索 | 预留分类/标签/团队筛选字段 |
GET | /search/suggest?keyword=xxx | 搜索建议 | prefix 匹配标题 |
GET | /search/hot | 热门搜索 | 近 7 天高频关键词 TOP 10 |
GET | /search/history | 搜索历史 | 当前用户历史记录 |
DELETE | /search/history | 清空历史 | 清空当前用户搜索历史 |
POST | /index/rebuild | 重建索引 | 全量重建 kb\_document 索引 |
POST | /index/document | 索引文档 | kb-document 内部调用 |
DELETE | /index/document/{id} | 删除索引 | kb-document 内部调用 |
SearchRequestDTO
@Data
public class SearchRequestDTO {
    @NotBlank(message = "搜索关键词不能为空")
    private String keyword;              // 搜索关键词

    // 高级筛选(当前未接入查询构建,预留字段)
    private List<Long> categoryIds;
    private List<Long> tagIds;
    private List<Long> teamIds;
    private Long creatorId;
    private Integer docStatus;
    private String startTime;
    private String endTime;
    private String sortField;
    private String sortOrder;

    // 分页
    private Integer current = 1;
    private Integer size = 10;

    // 搜索模式
    private String searchMode = "keyword";  // keyword | hybrid
    private int topK = 10;                  // 混合搜索 Top-K
    private boolean enableRerank = true;    // 是否启用 LLM 重排序
}
SearchResultVO
@Data
@Builder
public class SearchResultVO {
    private Long id;
    private String title;            // 标题(高亮后)
    private String summary;          // 摘要(高亮后)
    private List<String> highlights; // 内容高亮片段
    private String categoryName;
    private List<String> tagNames;
    private String creatorName;
    private String teamName;
    private Integer viewCount;
    private Integer likeCount;
    private Integer commentCount;
    private String publishAt;
    private Float score;             // BM25 相关度得分(关键词搜索)

    // 混合搜索特有
    private Double bm25Score;
    private Double vectorScore;
    private Double rerankScore;
    private List<ChunkResult> chunks; // 文档块明细
}
9. 前端搜索页面
9.1 搜索服务层
// src/services/search.service.ts
export const searchService = {
  search: (params: SearchParams) => {
    return http.post<SearchResponse>('/search', {
      keyword: params.keyword,
      searchMode: params.searchMode || 'keyword',
      topK: params.topK || 10,
      enableRerank: params.enableRerank ?? true,
      current: params.page || 1,
      size: params.pageSize || 10,
      sortField: params.sortBy,
    });
  },
  suggestions: (keyword: string) => http.get('/search/suggest', { params: { keyword } }),
  hotSearch: () => http.get('/search/hot'),
  history: () => http.get('/search/history'),
  clearHistory: () => http.delete('/search/history'),
};
9.2 SearchPage 功能特性
SearchPage.tsx 是一个完整的搜索页面组件:
| 特性 | 实现 |
|---|---|
| 搜索输入 | 防抖输入(300ms),触发 suggestions API 显示自动补全下拉 |
| 模式切换 | "关键词搜索" vs "混合智能搜索",选混合模式时显示 topK 和重排开关 |
| 热门搜索 | 卡片展示热门关键词(有 API 数据时用 API,否则用默认兜底列表) |
| 搜索历史 | 显示当前用户最近搜索记录,一键清空 |
| 结果卡片 | 标题(<em> 高亮)+ 摘要 + 内容高亮片段 + 分类/作者/时间元数据 |
| 混合搜索展示 | 每个结果含 BM25/Vector/Rerank 三种得分 + 可展开的 chunk 列表 |
| 得分色卡 | >80% 绿色、>60% 琥珀色、>40% 橙色、<40% 灰色 |
| 排序 | 相关度 / 最新 / 浏览量 三种排序 |
| 分页 | Ant Design Pagination |
| 空状态 | 引导用户换个关键词或切换到混合搜索模式 |
| 功能开关 | 读取 enableFullTextSearch 配置,关闭时展示 "搜索功能已禁用" |
10. 总结
| 维度 | 评价 |
|---|---|
| 双模检索 | 关键词搜索(BM25 + IK 分词)+ 混合智能搜索(BM25 + kNN + RRF + LLM Rerank),满足从精确匹配到语义理解的多种需求 |
| 中文分词 | IK ik_max_word 分词器实现词级中文语义匹配,告别按字切分的 "企/业/智/能/知/识/库" |
| 多字段加权 | title^2(标题最重要)> summary^1.5(摘要次之)> content(正文兜底),合理的相关度排序 |
| 高亮后处理 | mergeAdjacentEmTags() 合并 IK 分词造成的碎片化高亮标签,前端渲染美观 |
| 自动降级 | 混合搜索失败自动回退到关键词搜索,embedding 失败自动降级为 BM25-only,服务可用性不受 AI 组件影响 |
| 索引实时同步 | 文档 CRUD → Feign 异步触发 → ES 实时索引,搜索所见即所得 |
| 全量重建 | /index/rebuild 接口支持一键重建索引,分页拉取 + 逐条写入,适合索引结构变更后的全量迁移 |
| 搜索建议 | prefix 查询标题实现输入联想,300ms 防抖减少 ES 查询压力 |
| 搜索历史 | 异步保存不阻塞搜索主流程 + ON DUPLICATE KEY UPDATE 合并同关键词记录 |
| 向量检索 | 1024 维 Qwen text-embedding-v3 向量 + cosine 相似度,支持语义级 "意思相近" 的匹配 |
技术栈总结
搜索引擎:Elasticsearch 8.x(co.elastic.clients Java Client + Spring Data Elasticsearch)
中文分词:IK Analysis 插件(ik_max_word 模式)
关键词检索:BM25 算法(multi_match 多字段加权 + multi_filter 状态过滤)
语义检索:Qwen text-embedding-v3(1024 维向量)+ cosine 相似度
融合算法:RRF(Reciprocal Rank Fusion,C=60)
重排序:LLM 逐条相关性评分(1-10 分)
索引同步:Feign 同步(fire-and-forget) + RAG 异步(RabbitMQ DLQ)
搜索历史:MySQL kb_search_history + CompletableFuture.runAsync 异步写入
索引管理:REST API 驱动分页全量重建
前端:React + Zustand + Ant Design(SearchPage, Pagination, Drawer)