前言
RAG(Retrieval-Augmented Generation,检索增强生成)是企业智能知识库系统中最核心的 AI 能力之一。
它的本质是:让 LLM 在回答用户问题之前,先从企业知识库中检索到最相关的文档片段,再将这些片段作为"参考资料"注入 Prompt,引导 LLM 基于真实资料作答。
为什么需要 RAG?
- LLM 的知识截止日期问题:通用 LLM 的训练数据有截止日期,不知道企业内部的最新文档内容。
- LLM 的幻觉问题:在没有背景资料的情况下,LLM 可能"编造"听起来合理但实际上不存在的配置参数、API 接口或业务流程。
- 企业数据的私密性:企业内部文档不能上传到公有 LLM 训练集,RAG 在推理阶段动态检索私有知识库,数据不出企业边界。
本系统实现了一条完整的 RAG 链路:文档分块 → 向量嵌入 → 混合检索(BM25 + kNN + RRF) → LLM 重排序 → 结构化 Prompt 构建 → 流式生成回答 → 引用溯源。
这条链路中的每一个环节都不是简单的"调 API",而是包含了缓存优化、并行执行、多级降级等工程化设计。
本文将从分块策略开始,逐层拆解这条链路的每一步。
1. 一次 RAG 问答走完发生了什么
用户在前端 AI 助手中输入问题并打开"知识库增强"开关,后端执行以下流水线:
用户问题:"如何配置 Redis 连接池?"
  → Query Embedding(Qwen text-embedding-v3, 1024 维向量)
  → 混合检索(BM25 文本匹配 + kNN 向量相似度,并行执行)
  → RRF 融合排序(C=60,BM25 和 kNN 各取 Top-20)
  → LLM 重排序(Qwen 对候选片段逐个打分 1-10)
  → 取 Top-5 作为最终上下文
  → 构建结构化 Prompt(系统指令 + [1][2]...引用标注 + 参考资料 + 用户问题)
  → LLM 生成回答(流式 SSE,逐字返回前端)
  → 回答末尾附引用列表(文档标题 + 片段摘录 + 相关度分数)
完整流水线图见 5.5 混合检索完整序列图。
这条链路涉及 2 个 ES 索引(kb_document 文档级、kb_chunk 分块级)、1 个 Embedding 服务、1 个 LLM 对话模型、以及 Redis 缓存层。下面逐层拆解。
2. 文档分块策略:三段式混合分块
2.1 分块参数
// kb-ai/src/main/java/com/knowledge/base/ai/config/RagProperties.java
chunkSize = 512      // 每个块的目标 Token 数
chunkOverlap = 64    // 相邻块之间的重叠 Token 数
paragraphAware = true // 段落感知切分
实际字符数估算使用 CHARS_PER_TOKEN = 2.0:
maxChars = 512 * 2.0 = 1024字符/块overlapChars = 64 * 2.0 = 128字符的重叠
2.2 三段式分块流程
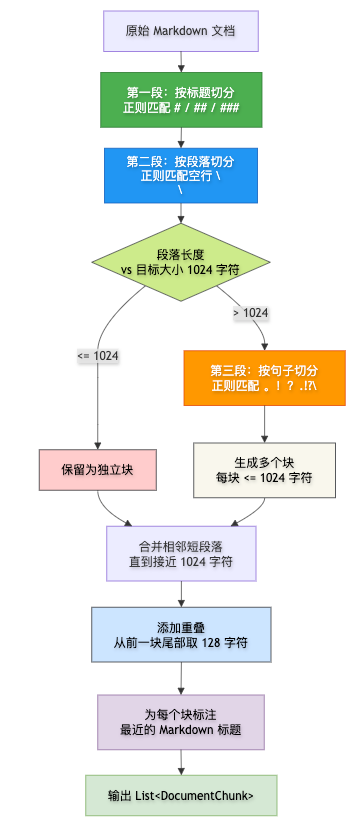
源码参考:
kb-ai/src/main/java/com/knowledge/base/ai/rag/service/impl/ChunkingServiceImpl.java
2.3 分块策略的设计考量
| 维度 | 选择 | 理由 |
|---|---|---|
| 块大小 | 512 tokens | 兼顾检索精度与上下文完整性 |
| 重叠 | 64 tokens | 防止关键信息被切分到块边界 |
| 标题感知 | 有 | 每个块携带所属章节标题,提升检索上下文可读性 |
| 段落感知 | 有 | 优先在段落边界切分,保持语义完整性 |
| 句子兜底 | 有 | 超长段落按句子切分,保证每块不超过目标大小 |
2.4 分块后的数据结构
// kb-ai/src/main/java/com/knowledge/base/ai/rag/entity/DocumentChunk.java
public class DocumentChunk {
    private String chunkId;          // UUID,唯一标识
    private Long documentId;         // 所属文档 ID
    private String documentTitle;    // 文档标题(用于引用标注)
    private String content;          // 分块文本
    private String heading;          // 所属 Markdown 标题
    private Integer chunkIndex;      // 在文档中的序号(0-based)
    private Integer totalChunks;     // 文档总分块数
    private float[] embedding;       // 1024 维向量(写入时计算)
}
3. Embedding 向量化:缓存优先的批量嵌入
3.1 Embedding 模型配置
// kb-ai/src/main/java/com/knowledge/base/ai/config/EmbeddingConfig.java
@Bean
@ConditionalOnProperty(name = "rag.enabled", havingValue = "true", matchIfMissing = true)
public EmbeddingModel embeddingModel() {
    return OpenAiEmbeddingModel.builder()
        .apiKey(qwenApiKey)
        .baseUrl(qwenBaseUrl)
        .modelName("text-embedding-v3")   // Qwen Embedding 模型
        .build();
}
通过 LangChain4j 的 OpenAiEmbeddingModel 调用 Qwen 兼容的 OpenAI API 格式,输出维度 1024。
3.2 嵌入服务实现
// kb-ai/src/main/java/com/knowledge/base/ai/rag/service/impl/EmbeddingServiceImpl.java

// 单条嵌入(优先走 Redis 缓存)
public float[] embed(String text) {
    String cacheKey = "rag:emb:" + DigestUtils.md5Hex(text);
    // 1. 查 Redis 缓存
    String cached = redisTemplate.opsForValue().get(cacheKey);
    if (cached != null) { return deserializeCache(cached); }
    // 2. 调用 Embedding 服务
    float[] vector = embeddingModel.embed(text).vector();
    // 3. 写入缓存(TTL = 86400 秒 = 24 小时)
    redisTemplate.opsForValue().set(cacheKey, serialize(vector), cacheTtlSeconds, TimeUnit.SECONDS);
    return vector;
}批量嵌入:每批 20 条(可配置),减少 API 调用次数。
3.3 嵌入过程的数据流
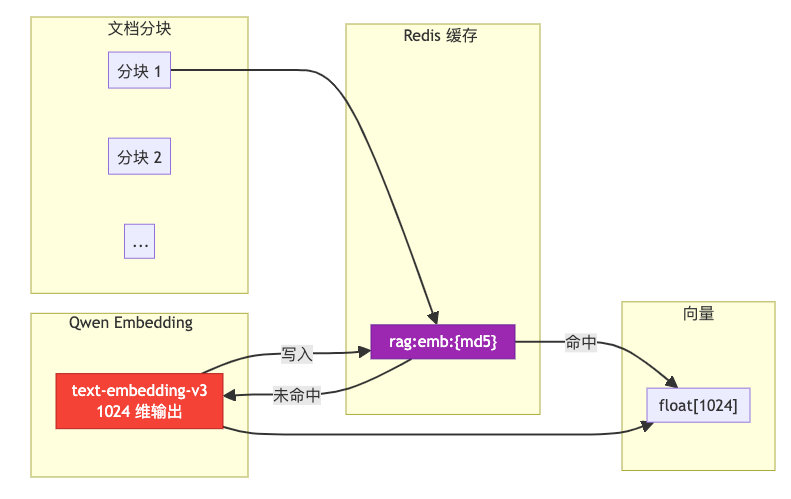
3.4 降级处理
当 Embedding 模型不可用时:
// 返回零向量作为降级策略
if (embeddingModel == null) {
    return new float[1024];  // 全零向量
}
零向量会导致 kNN 搜索对所有文档返回相同分数,此时搜索完全依赖 BM25。虽不理想,但系统不会崩溃。
4. 向量索引:HNSW + 余弦相似度
4.1 ES 索引结构
RAG 使用独立的 ES 索引 kb_chunk,与文档搜索索引 kb_document 物理隔离:
// kb-ai/.../rag/service/impl/VectorIndexServiceImpl.java
CreateIndexRequest.of(c -> c
    .index("kb_chunk")
    .settings(s -> s
        .numberOfShards("3")           // 3 个分片
        .numberOfReplicas("1")         // 1 个副本
        .refreshInterval(ri -> ri.time("5s")))
    .mappings(m -> m
        .properties("embedding", p -> p.denseVector(dv -> dv
            .dims(1024)                // 向量维度
            .index(true)               // 启用 HNSW 索引
.similarity("cosine"))))); // 余弦相似度| 配置项 | 值 | 说明 |
|---|---|---|
| 索引名 | kb_chunk | 分块级别,每个文档可能对应几十个分块 |
| 分片数 | 3 | 支持中等规模并发写入 |
| 副本数 | 1 | 数据可靠性与查询吞吐的均衡 |
| 向量维度 | 1024 | 由 text-embedding-v3 模型决定 |
| 相似度 | cosine | 余弦相似度,归一化后等价于点积 |
| 索引算法 | HNSW | ES 默认,index(true) 自动构建 |
4.2 两个 ES 索引的职责分离
kb_document (kb-search) | kb_chunk (kb-ai) | |
|---|---|---|
| 粒度 | 文档 | 分块(~512 tokens) |
| 向量字段 | 无 | embedding (1024d cosine) |
| 搜索方式 | BM25 only | BM25 + kNN + RRF |
| 用途 | 文档列表页关键词搜索 | RAG 上下文检索 |
| 分词器 | ik\_max\_word | 默认(ik\_max\_word) |
4.3 索引写入方式
向量写入不走 Spring Data ES 的 @Document 映射,而是通过低层 ElasticsearchClient 的 Bulk API 直接写入 Map<String, Object>:
// VectorIndexServiceImpl - indexChunks()
for (DocumentChunk chunk : chunks) {
    Map<String, Object> docMap = buildDocMap(chunk);  // 包含 embedding float[]
    bulkBuilder.operations(op -> op
        .index(idx -> idx.index("kb_chunk").id(chunk.getChunkId()).document(docMap)));
}原因:Spring Data ES 对 dense_vector 的序列化支持有限,直接在文档 Map 中传入 float[] 更可靠。
5. 混合检索:BM25 + kNN + RRF 三阶段融合
5.1 为什么需要混合检索
| 检索方式 | 优势 | 劣势 |
|---|---|---|
| BM25(关键词) | 精确匹配术语、缩写、代码 | 不理解语义,"连接池配置" vs "连接池参数" 匹配不到 |
| kNN(向量) | 语义理解,同义词泛化 | 对数字、专有名词不敏感,可能召回不相关内容 |
混合检索取长补短:BM25 找精确 + kNN 找语义 → RRF 融合 → 综合排序。
5.2 BM25 检索
// VectorIndexServiceImpl - bm25Search()
Criteria criteria = new Criteria("content").matches(queryText)
        .or(new Criteria("document_title").matches(queryText));
CriteriaQuery query = new CriteriaQuery(criteria);
query.setMaxResults(hybridTopK);  // 默认 20
SearchHits<KbChunkDoc> hits = esOperations.search(query, KbChunkDoc.class);
在 content 和 document_title 两个字段上进行全文匹配,返回 Top-K 个最相关分块。
5.3 kNN 向量检索
// VectorIndexServiceImpl - knnSearch()
Query scriptScoreQuery = Query.of(q -> q
    .scriptScore(ss -> ss
        .query(sq -> sq.matchAll(m -> m))
        .script(s -> s.inline(i -> i
            .source("cosineSimilarity(params.query_vector, 'embedding') + 1.0")
            .params("query_vector", JsonData.of(toFloatList(queryEmbedding)))))));
使用 script_score 方式计算余弦相似度,+1.0 将所有分数映射到 [0, 2] 区间。
5.4 RRF 融合
// VectorIndexServiceImpl - rrfFuse()
// RRF 公式:score(d) = Σ_{r in {bm25, knn}} 1 / (C + rank_r(d))
// C = 60 (默认)
Map<String, SearchResult> fused = new ConcurrentHashMap<>();
// BM25 结果:按 score 降序排名
for (int rank = 0; rank < bm25Sorted.size(); rank++) {
    double rrfScore = 1.0 / (rrfC + rank + 1);  // rank 从 0 开始,+1 对齐公式
    // 累加到融合 Map
}
// kNN 结果:同理累加
RRF(Reciprocal Rank Fusion)是一种无监督融合算法:
- 不关心分数的绝对值,只关心排名
- 一个文档同时在 BM25 和 kNN 中排名靠前,RRF 分数就高
- C=60 是经验值,越大两个排名的权重越接近
5.5 混合检索完整序列图
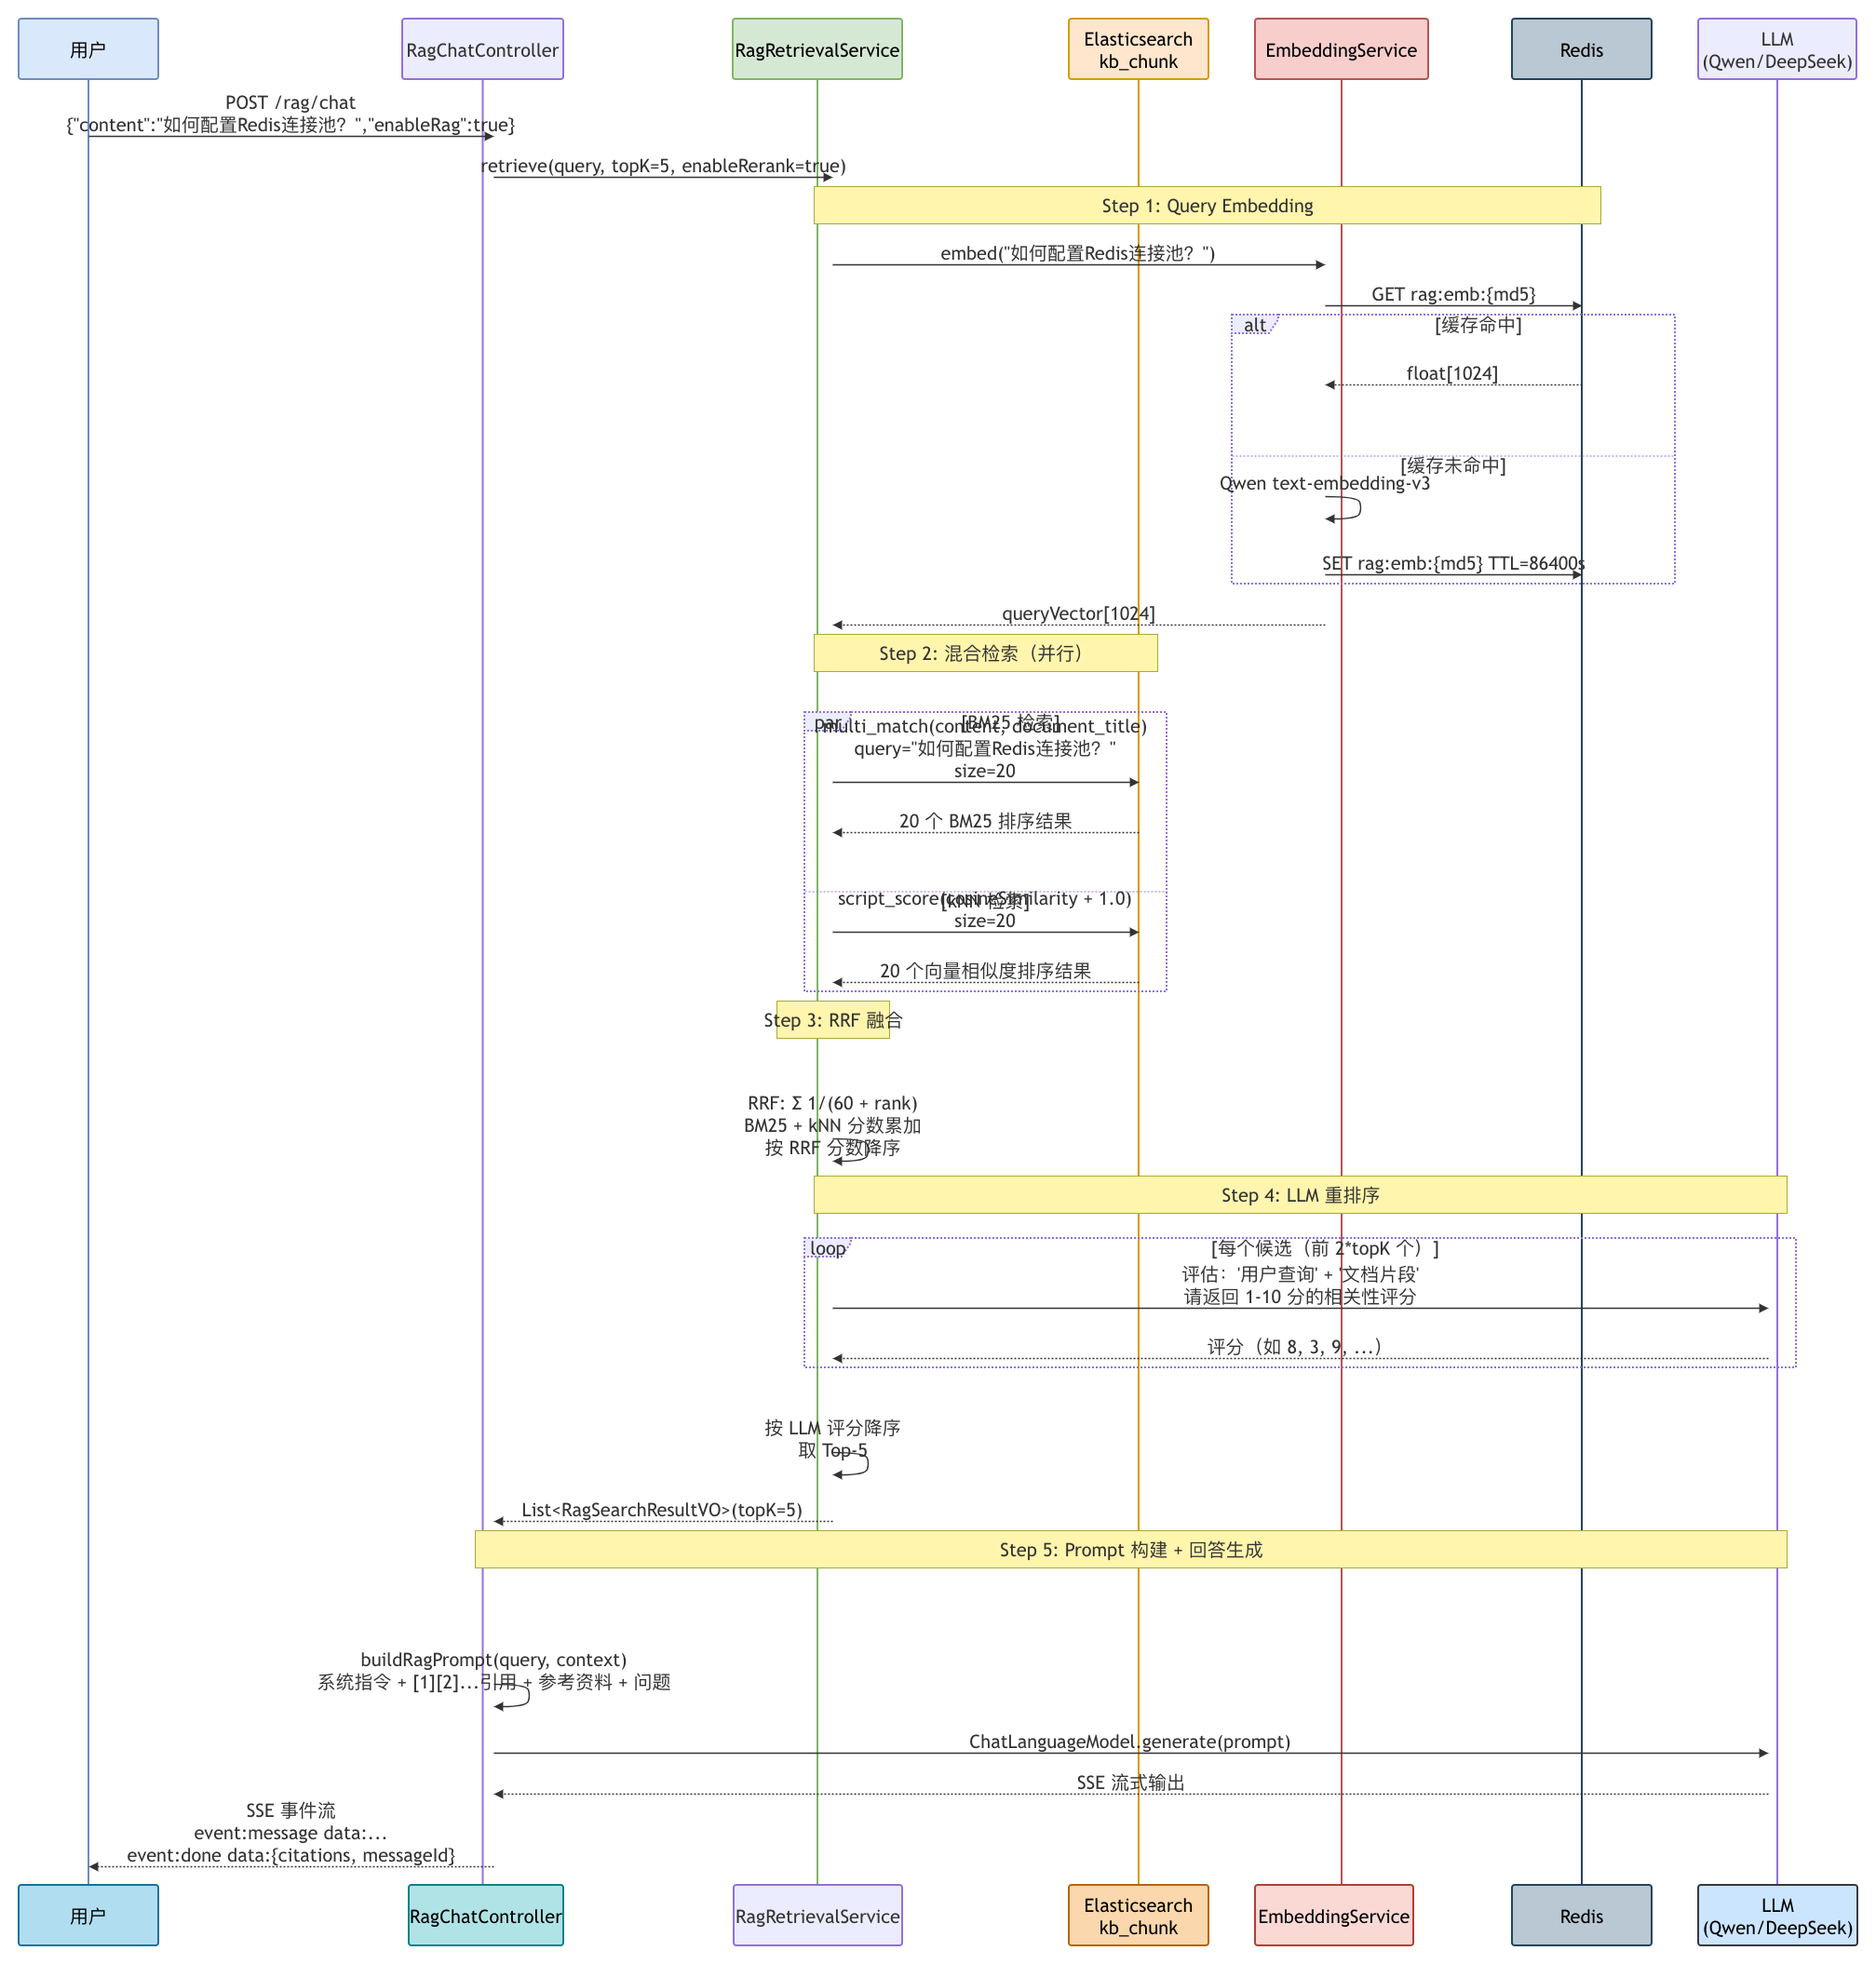
源码参考:
kb-ai/src/main/java/com/knowledge/base/ai/rag/service/impl/RagRetrievalServiceImpl.javakb-ai/src/main/java/com/knowledge/base/ai/rag/service/impl/VectorIndexServiceImpl.java:269-370kb-ai/src/main/java/com/knowledge/base/ai/rag/service/impl/EmbeddingServiceImpl.java
6. LLM 重排序:相关性精排
6.1 为什么需要重排序
RRF 融合只考虑了相对排名,没有使用语义理解。一个在 BM25 和 kNN 中都排名靠前的文档,可能只是"提到了"而不是真正"回答了"用户问题。LLM 重排序使用语义理解对候选结果做精细化评分。
6.2 重排序实现
// RagRetrievalServiceImpl - rerank()
for (RagSearchResultVO candidate : candidates) {
    String prompt = String.format("""
        你是一个搜索相关性评估专家。
        请根据以下"用户查询"和"文档片段",评估该文档片段对回答用户查询的相关程度。

        用户查询:%s
        文档片段:%s

        请仅返回一个整数评分(1-10分),不要返回其他内容。
        10 - 直接完美回答
        7-9 - 高度相关
        4-6 - 部分相关
        1-3 - 基本无关
        """, query, truncateForRerank(candidate.getContent()));

    String response = chatModel.generate(prompt);
    int score = extractScore(response);  // 正则提取 \b([1-9]|10)\b
    // 如果 LLM 返回了其他内容(如 "得分:8"),正则提取第一个数字
}
6.3 重排序降级
// 如果 LLM 重排序失败(API 异常 / 返回非数字)
if (score <= 0 || score > 10) {
    log.warn("重排序失败,使用 RRF 原始分数: {}", candidate.getScore());
    score = (int) Math.min(10, Math.round(candidate.getScore() * 10));
}
每个候选片段截断到 1000 字符,避免重排序开销过大。重排序失败时回退到 RRF 原始分数。
7. RAG Prompt 构建与引用标注
7.1 Prompt 模板
// kb-ai/.../rag/service/impl/RagChatServiceImpl.java - buildRagPrompt()
StringBuilder sb = new StringBuilder();
sb.append("你是一个企业知识库助手。请仅根据以下参考资料回答用户的问题。\n");
sb.append("如果参考资料中没有相关信息,请说明【根据现有知识库暂时无法回答此问题】,绝对不要编造内容。\n");
sb.append("回答时,请在引用资料处的末尾标注引用编号,如 [1]、[2]。\n");
sb.append("回答应当专业、准确、简洁。\n\n");

sb.append("=== 参考资料 ===\n");
for (int i = 0; i < context.size(); i++) {
    RagSearchResultVO chunk = context.get(i);
    sb.append(String.format("[%d] 来源文档:%s", i + 1, chunk.getDocumentTitle()));
    if (chunk.getHeading() != null && !chunk.getHeading().isEmpty()) {
        sb.append(" | 章节:").append(chunk.getHeading());
    }
    sb.append("\n").append(chunk.getContent()).append("\n\n");
}

sb.append("=== 用户问题 ===\n");
sb.append(query);
7.2 引用生成
生成回答后,从检索结果构建 CitationVO 列表返回前端:
// CitationVO: index, documentId, documentTitle, excerpt, relevanceScore
for (int i = 0; i < context.size(); i++) {
    CitationVO citation = new CitationVO();
    citation.setIndex(i + 1);                       // [1], [2], ...
    citation.setDocumentId(chunk.getDocumentId());
    citation.setDocumentTitle(chunk.getDocumentTitle());
    citation.setExcerpt(truncate(chunk.getContent(), 200));  // 前 200 字
    citation.setRelevanceScore(chunk.getScore());
    citations.add(citation);
}
前端在回答末尾渲染引用面板,展示每个引用文档的标题、摘录和相关度百分比。
7.3 防幻觉约束
三条关键指令直接内嵌在 Prompt 中:
请仅根据以下参考资料回答— 限定回答范围如果参考资料中没有相关信息,请说明【根据现有知识库暂时无法回答此问题】— 强制诚实回答绝对不要编造内容— 显式防幻觉
8. 流式响应:SSE 逐字输出
8.1 后端 SSE 实现
// RagChatServiceImpl - chatWithContextStream()
@PostMapping("/rag/chat/stream")
public SseEmitter chatWithContextStream(@RequestBody ChatRequestDTO requestDTO) {
    SseEmitter emitter = new SseEmitter(30 * 60 * 1000L);  // 30 分钟超时

    CompletableFuture.runAsync(() -> {
        try {
            // 1. 准备对话上下文
            RagChatContext ctx = prepareConversation(requestDTO, userId);
            // 2. 检索相关片段
            List<RagSearchResultVO> context = safeRetrieve(query);
            // 3. 构建 Prompt
            String prompt = buildRagPrompt(query, context);
            // 4. 流式调用 LLM
            chatModel.generate(prompt, new StreamingResponseHandler<>() {
                @Override
                public void onNext(String token) {
                    emitter.send(SseEmitter.event().name("message").data(token));
                }
                @Override
                public void onComplete(Response<AiMessage> response) {
                    // 发送引用列表和元信息
                    emitter.send(SseEmitter.event().name("done").data(resultMap));
                    emitter.complete();
                }
                @Override
                public void onError(Throwable error) {
                    emitter.send(SseEmitter.event().name("error").data(error.getMessage()));
                    emitter.complete();
                }
            });
        } catch (Exception e) {
            emitter.completeWithError(e);
        }
    });

    return emitter;
}
8.2 前端 SSE 消费
// ai.service.ts - askStream()
const response = await fetch('/api/ai/chat/stream', {
    method: 'POST',
    headers: { 'Content-Type': 'application/json', 'Authorization': token },
    body: JSON.stringify({ content, conversationId, model, enableRag: true })
});

const reader = response.body.getReader();
const decoder = new TextDecoder();
let buffer = '';

while (true) {
    const { done, value } = await reader.read();
    if (done) break;
    buffer += decoder.decode(value, { stream: true });
    // 按行解析 SSE 事件:event: message / event: done / event: error
    // event:message → data: <token> → onMessage(token)
    // event:done → data: { conversationId, messageId, citations } → onDone(data)
}
8.3 流式响应流程
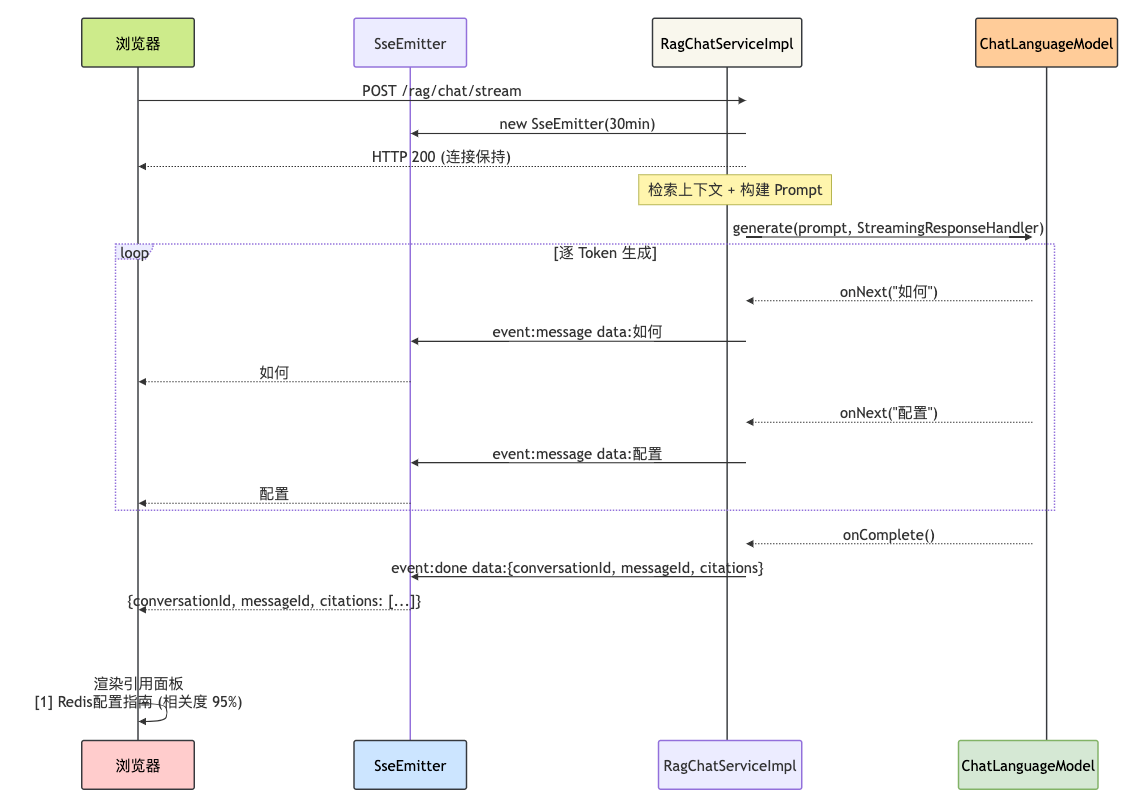
9. 异步重建索引:RabbitMQ 驱动的文档索引流水线
9.1 触发时机
RAG 索引在以下时机触发:
| 触发时机 | 触发方 | 方式 |
|---|---|---|
| 文档审核通过 / 直接发布 | kb-document → Feign → kb-ai | POST /rag/reindex/{docId} |
| 手动全量重建 | 管理员调用 | POST /rag/reindex/all |
| 手动批量重建 | 管理员调用 | POST /rag/reindex/batch |
| 文档删除 | kb-document → Feign → kb-ai | DELETE /rag/reindex/{docId} |
9.2 异步流水线
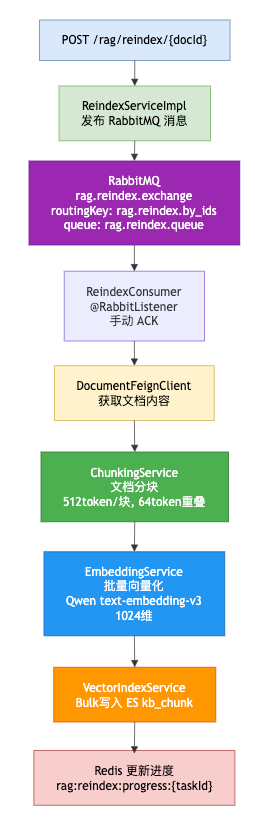
进度追踪:使用 Redis Hash rag:reindex:progress:{taskId} 存储进度状态(RUNNING / COMPLETED / FAILED),可通过 GET /rag/reindex/progress/{taskId} 查询。
9.3 消息确认模式
消费者使用手动 ACK:
@RabbitListener(queues = "rag.reindex.queue", ackMode = "MANUAL")
public void handleReindex(Message message, Channel channel) {
    try {
        // 执行分块 + 嵌入 + 索引
        channel.basicAck(message.getMessageProperties().getDeliveryTag(), false);
    } catch (Exception e) {
        channel.basicNack(message.getMessageProperties().getDeliveryTag(), false, true); // requeue
    }
}
处理失败时 requeue,让 RabbitMQ 重新投递,实现自动重试。
10. 降级策略:每一步都有退路
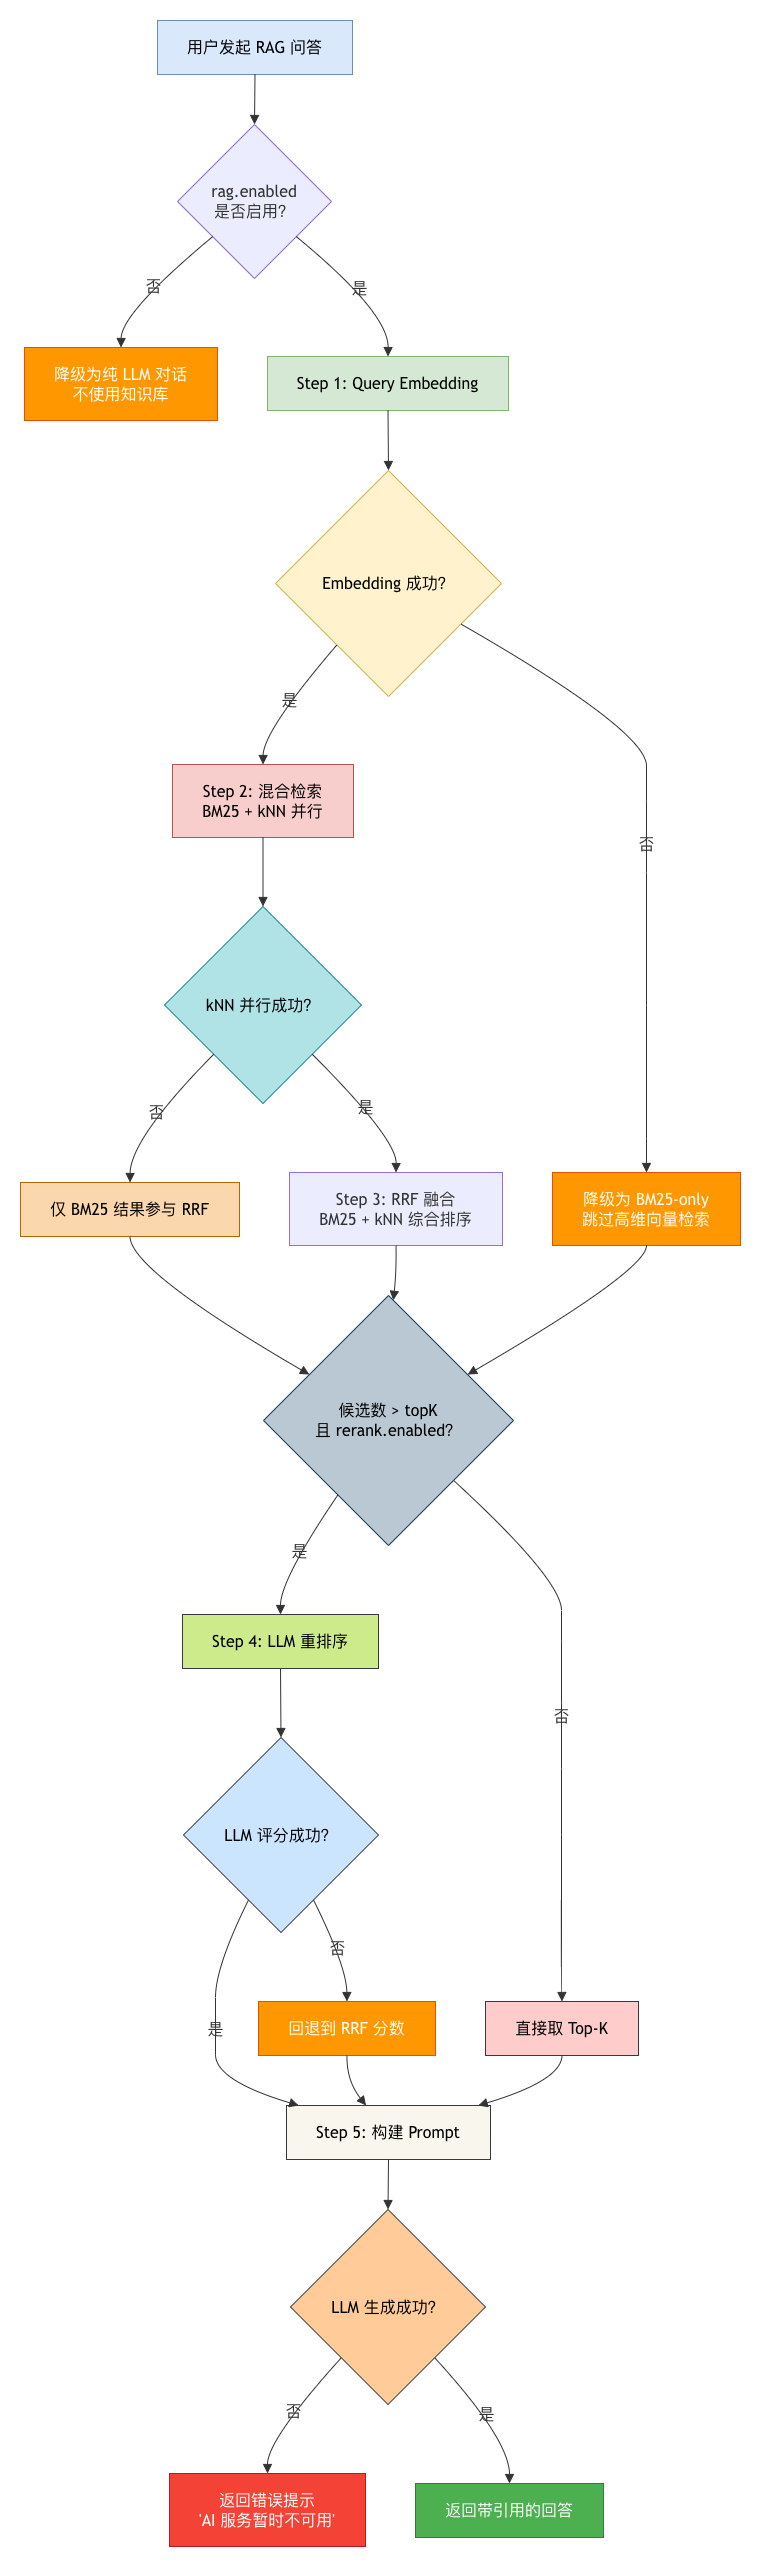
四级降级链路总结:
| 降级点 | 触发条件 | 降级行为 | 影响 |
|---|---|---|---|
| Embedding 服务故障 | API 不可用或超时 | 返回零向量,kNN 对所有文档等分 | 检索退化为纯 BM25,语义匹配丧失 |
| kNN 搜索失败 | ES 超时或索引异常 | 仅 BM25 结果进入 RRF | 缺失语义相似度维度 |
| LLM 重排序失败 | 评分 API 异常 | 使用 RRF 原始分数 | 候选排序精度下降 |
| Chat LLM 不可用 | Qwen/DeepSeek 全部故障 | 返回错误提示 | AI 回答完全不可用 |
核心原则:RAG 链路中任何一个环节失败都不会导致整个请求崩溃,系统会逐级降级到可用状态。
11. 前端交互:知识库增强对话体验
11.1 RAG / KAG 双开关
在 AIAssistantPage 中,两个 Switch 开关控制:
// AIAssistantPage.tsx
const { ragEnabled, kagEnabled, toggleRag, toggleKag } = useAIStore();

<Switch checked={ragEnabled} onChange={toggleRag} />
// 标签:知识库增强

<Switch checked={kagEnabled} onChange={toggleKag} />
// 标签:图谱推理
enableRag 和 enableKag 作为参数传入 SSE 流式请求:
body: JSON.stringify({
    content: question,
    conversationId,
    model: selectedModel,
    enableRag: ragEnabled,    // 知识库增强
    enableKag: kagEnabled,    // 图谱推理
})
11.2 回答中的引用展示
AI 回答气泡内包含三个区域:
┌─ 回答内容(Markdown 渲染)───────────────┐
│ 配置 Redis 连接池需要在 application.yml  │
│ 中设置以下参数 [1]:                    │
│ ...                                     │
└─────────────────────────────────────────┘
┌─ 引用列表 ──────────────────────────────┐
│ [1] Redis配置指南 (相关度 95%)          │
│     "Redis 连接池通过 spring.redis...  │
│ [2] 中间件最佳实践 (相关度 82%)         │
│     "建议连接池大小设置为 CPU 核数..."  │
└─────────────────────────────────────────┘
┌─ 参考实体(KAG 模式)───────────────────┐
│ 实体: RedisConnectionPool → 连接池配置  │
│ 推理路径: Redis →(DEPENDS_ON)→ Jedis   │
└─────────────────────────────────────────┘
// AIMessageBubble - 引用渲染
{message.citations?.map(citation => (
<div key={citation.index}>
[{citation.index}] {citation.documentTitle}
(相关度 {Math.round(citation.relevanceScore * 100)}%)
<p>{citation.excerpt}</p>
</div>
))}11.3 知识库搜索页的混合模式
搜索页(SearchPage)的"混合智能搜索"模式与 RAG 检索共享同一后端管线。区别在于:搜索页返回分块级结果供用户浏览,不经过 LLM 生成环节。前端展示 BM25 分数、向量分数和重排序分数的明细:
{result.chunks?.map(chunk => (
    <ChunkCard>
        <ScoreBar bm25={chunk.bm25Score} vector={chunk.vectorScore} score={chunk.score} />
        <p>{chunk.content}</p>
    </ChunkCard>
))}
源码参考:
src/pages/AIAssistantPage.tsx:1296-1361src/pages/SearchPage.tsx:432-453src/services/ai.service.ts:askStream()src/stores/ai.store.ts
总结
- 分层清晰的分块策略:标题 → 段落 → 句子 的三段式切分保证了语义完整性,重叠机制防止了边界信息丢失。每个块携带所属章节标题,显著提升了检索结果的可解释性。
- BM25 + kNN + RRF 的三层混合检索:不是简单的"先做 BM25 再做 kNN 再合并",而是并行执行 + 无监督融合 + 有监督重排序。RRF 的 C=60 常数是业界验证过的参数值。
- Embedding 缓存设计:
rag:emb:{md5}的 Redis 缓存避免了重复嵌入相同文本(如频繁搜索相似的查询),TTL 24 小时的设置合理。 - 流式 SSE 输出:用户不需要等待完整的 RAG 管线执行完毕才看到第一个字。检索完成后,LLM 逐 token 输出,改善了体感响应速度。
- 重排序的精细化控制:候选片段截断到 1000 字符,LLM 评分失败时回退到 RRF 分数 —— 在精度和性能之间取得了平衡。
- 两个 ES 索引职责分离:
kb_document面向文档列表搜索(低延迟、无向量),kb_chunk面向 RAG 检索(向量索引、混合查询),互不干扰。 - 异步索引重建:RabbitMQ 手动 ACK + 失败 requeue,避免了索引重建阻塞文档发布流程。
