前言
企业智能知识库系统集成了 AI 对话、AI 写作、AI 文档处理、知识库增强检索(RAG)、图谱增强推理(KAG)等多种 AI 能力。不同场景对模型的需求不同:对话需要流畅自然,写作需要创意丰富,代码生成需要逻辑严密,文档摘要需要准确精炼。
本系统支持多模型接入与运行时切换:用户可以在前端自由选择"通义千问"或"DeepSeek",也可以由后端根据场景自动选择最合适的模型。所有模型通过统一的 LangChain4j 接口接入,增加新模型只需修改配置和一处 switch 分支,无需改动业务逻辑。
本文将介绍系统的多模型架构设计、模型生命周期管理、前端切换交互和扩展新模型的方法。
1.一次模型切换走完发生了什么
用户在前端将模型从"通义千问"切换到"DeepSeek",发送一条消息,后端执行以下流程:
用户选择"DeepSeek",输入"Spring Boot 事务管理器如何获取数据库连接?"
  → 前端 aiService.askStream({ model: "deepseek", content: "...", enableRag: true })
  → POST /ai/chat/stream → AiChatController
  → AiChatServiceImpl.chatStream()
       ├── 读取 requestDTO.getModel() → "deepseek"
       ├── RAG 开关打开 → RagChatService.chatWithContextStream()
       │     ├── 向量检索(ES BM25 + kNN + RRF 融合)
       │     ├── 构建 RAG Prompt
       │     └── modelProvider.getModel("deepseek") → 获取 DeepSeek ChatLanguageModel
       ├── ChatLanguageModel.generate(prompt) → 调用 DeepSeek API
       └── SseEmitter → 流式返回前端
  → 前端解析 SSE 事件流,逐 Token 展示回答
  → 回答标注来源:[DeepSeek] + 引用编号
完整模型切换序列图见 5.2 运行时模型切换序列图。
这条链路涉及 1 个核心组件(ModelProvider)、7 个服务类、2 个外部 LLM API、以及前端的模型选择交互。下面逐层拆解。
2. 配置体系:application.yml 与环境变量
2.1 配置类全景
系统将所有模型配置集中管理,不使用 Spring @ConfigurationProperties 绑定,而是通过 ModelProvider 中的 @Value 注入:
# kb-ai/src/main/resources/application.yml

# ======================== 通义千问(阿里云 DashScope) ========================
qwen:
  api-key: ${QWEN_API_KEY:}
  base-url: ${QWEN_BASE_URL:https://dashscope.aliyuncs.com/compatible-mode/v1}
  chat:
    options:
      model: ${QWEN_MODEL:qwen3-max}
      temperature: 0.3
      max-tokens: 4000

# ======================== DeepSeek ========================
deepseek:
  api-key: ${DEEPSEEK_API_KEY:}
  model: deepseek-chat
  base-url: https://api.deepseek.com/v1
  max-tokens: 4096
  temperature: 0.7

# ======================== 默认模型 ========================
ai:
  default-model: qwen

# ======================== RAG 嵌入模型(通义千问 text-embedding-v3) ========================
rag:
  embedding:
    model: text-embedding-v3

# ======================== KAG 抽取模型 ========================
kag:
  extraction:
    model: qwen
2.2 环境变量覆盖
通过 .env 文件或系统环境变量传入 API Key,避免硬编码:
# .env.example
QWEN_API_KEY=your-qwen-api-key-here
QWEN_MODEL=qwen3-max
DEEPSEEK_API_KEY=your-deepseek-api-key-here
AI_DEFAULT_MODEL=qwen
2.3 配置设计考量
| 维度 | 选择 | 理由 |
|---|---|---|
| API Key 注入 | @Value + 环境变量 | 不在配置文件中暴露密钥,部署时通过环境变量注入 |
| 默认值策略 | api-key: ${VAR:} — 空字符串为未配置 | 空字符串表示 Skip,不注册该模型 |
| base-url 可配置 | Qwen 支持自定义 | 允许内网代理或 DashScope 地域切换 |
| 服务级模型差异 | RAG/KAG 有独立模型配置 | RAG 可始终使用响应最快/最便宜的模型,无需跟随对话切换 |
3. ModelProvider:核心模型路由器
3.1 组件职责
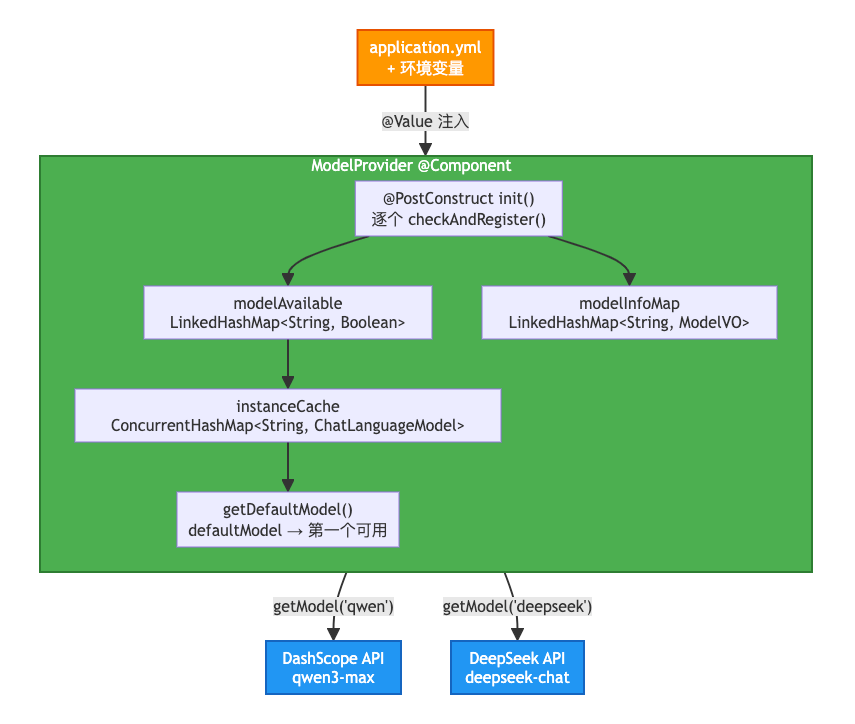
ModelProvider 是整个模型体系的中心组件,承担三个职责:
- 注册:启动时扫描配置,只注册 API Key 已配置的模型
- 缓存:按
ConcurrentHashMap懒加载模型实例,重复请求不重复创建 - 路由:根据请求中的
model字段返回对应的ChatLanguageModel
3.2 核心代码
// kb-ai/src/main/java/com/knowledge/base/ai/config/ModelProvider.java
@Slf4j
@Component
public class ModelProvider {

    // ======================== 配置注入 ========================

    @Value("${qwen.api-key:}")
    private String qwenApiKey;

    @Value("${qwen.base-url:https://dashscope.aliyuncs.com/compatible-mode/v1}")
    private String qwenBaseUrl;

    @Value("${qwen.chat.options.model:qwen3-max}")
    private String qwenModel;

    @Value("${qwen.chat.options.temperature:0.3}")
    private Double qwenTemperature;

    @Value("${qwen.chat.options.max-tokens:4000}")
    private Integer qwenMaxTokens;

    @Value("${deepseek.api-key:}")
    private String deepseekApiKey;

    @Value("${deepseek.model:deepseek-chat}")
    private String deepseekModel;

    @Value("${deepseek.base-url:https://api.deepseek.com/v1}")
    private String deepseekBaseUrl;

    @Value("${deepseek.max-tokens:4096}")
    private Integer deepseekMaxTokens;

    @Value("${deepseek.temperature:0.7}")
    private Double deepseekTemperature;

    @Value("${ai.default-model:qwen}")
    private String defaultModel;

    // ======================== 三张内部表 ========================

    /** 模型实例缓存:key=模型名, value=ChatLanguageModel */
    private final Map<String, ChatLanguageModel> instanceCache = new ConcurrentHashMap<>();

    /** 模型可用性:按注册顺序排列 */
    private final Map<String, Boolean> modelAvailable = new LinkedHashMap<>();

    /** 模型展示信息:供前端 API 查询 */
    private final Map<String, ModelVO> modelInfoMap = new LinkedHashMap<>();

    // ======================== 初始化:注册所有模型 ========================

    @PostConstruct
    public void init() {
        checkAndRegister("qwen", "通义千问",
            "阿里云大语言模型,支持多轮对话、文本生成等", qwenApiKey);
        checkAndRegister("deepseek", "DeepSeek",
            "深度求索大语言模型,擅长代码生成和深度推理", deepseekApiKey);

        if (modelAvailable.isEmpty()) {
            log.error("FATAL: 没有可用的 AI 模型(所有 API Key 都未配置)");
        }
    }

    /**
     * 注册模型:仅当 apiKey 非空时注册
     */
    private void checkAndRegister(String key, String displayName,
                                   String description, String apiKey) {
        if (apiKey != null && !apiKey.trim().isEmpty()) {
            modelAvailable.put(key, true);
            modelInfoMap.put(key, new ModelVO(
                key, displayName, description, key.equals(defaultModel)));
            log.info("已注册 AI 模型:{} ({})", displayName, key);
        } else {
            log.warn("AI 模型未配置 API Key,跳过注册:{} ({})", displayName, key);
        }
    }

    // ======================== 模型获取 ========================

    /**
     * 获取指定模型实例(不带参数则返回默认模型)
     */
    public ChatLanguageModel getModel(String modelName) {
        String key = resolveModelKey(modelName);
        if (!modelAvailable.containsKey(key)) {
            throw new IllegalStateException(
                "模型 " + key + " 的 API Key 未配置,请检查环境变量");
        }
        return instanceCache.computeIfAbsent(key, this::buildModel);
    }

    /**
     * 模型名解析:空 → 默认模型
     */
    private String resolveModelKey(String modelName) {
        if (modelName == null || modelName.trim().isEmpty()) {
            return getDefaultModelName();
        }
        return modelName.trim().toLowerCase();
    }

    /**
     * 默认模型名:配置值 → 第一个可用模型 → "qwen"
     */
    public String getDefaultModelName() {
        if (modelAvailable.containsKey(defaultModel)) {
            return defaultModel;
        }
        if (!modelAvailable.isEmpty()) {
            return modelAvailable.keySet().iterator().next();
        }
        return "qwen";
    }

    /**
     * 获取可用模型列表(供前端下拉框使用)
     */
    public List<ModelVO> getAvailableModels() {
        return new ArrayList<>(modelInfoMap.values());
    }
}
3.3 关键设计点
- 懒加载策略:
instanceCache.computeIfAbsent()确保只有在第一次调用getModel()时才创建模型实例,应用启动时不依赖 API Key 可达性 - LinkedHashMap 维护顺序:
modelAvailable使用LinkedHashMap,保证前端模型列表按注册顺序排列 - 空 API Key 跳过注册:没有配置 API Key 的模型不会出现在
modelAvailable中,前端看不到,后端也不会尝试调用 - FATAL 日志:所有模型都不可用时打印 FATAL 级别日志,方便运维发现配置遗漏
4. 模型实例化:buildModel 工厂方法
4.1 工厂方法
// ModelProvider.buildModel() —— 模型实例构造
private ChatLanguageModel buildModel(String modelName) {
    switch (modelName) {
        case "qwen" -> {
            return OpenAiChatModel.builder()
                .apiKey(qwenApiKey)
                .baseUrl(qwenBaseUrl)
                .modelName(qwenModel)
                .temperature(qwenTemperature)
                .maxTokens(qwenMaxTokens)
                .build();
        }
        case "deepseek" -> {
            return OpenAiChatModel.builder()
                .apiKey(deepseekApiKey)
                .baseUrl(deepseekBaseUrl)
                .modelName(deepseekModel)
                .temperature(deepseekTemperature)
                .maxTokens(deepseekMaxTokens)
                .build();
        }
        default -> throw new IllegalArgumentException(
            "不支持的模型:" + modelName);
    }
}
4.2 为什么都用 OpenAiChatModel
通义千问和 DeepSeek 都提供了 OpenAI 兼容 API,这意味着它们接受与 OpenAI 相同的请求/响应格式(POST /v1/chat/completions)。LangChain4j 的 OpenAiChatModel 正是针对这种协议的聊天模型实现,只需传入不同的 baseUrl 和 apiKey,即可适配不同的模型供应商。
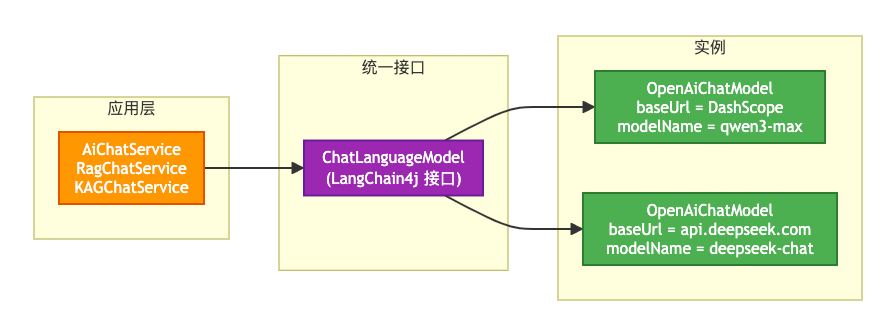
这种设计的一个直接好处是:新增任何 OpenAI 兼容的模型供应商(如 GPT-4o、Claude via Bedrock、Ollama 本地模型等),只需要在 switch 分支中添加一个 buildModel 用例,无需改动任何业务代码。
4.3 Embedding 模型
嵌入模型也用了同样的模式,但它是条件装配的:
// kb-ai/src/main/java/com/knowledge/base/ai/config/EmbeddingConfig.java
@Configuration
@ConditionalOnProperty(name = "rag.enabled", havingValue = "true", matchIfMissing = true)
@ConditionalOnExpression("!'${qwen.api-key:}'.isBlank()")
public class EmbeddingConfig {

    @Value("${qwen.api-key}")
    private String qwenApiKey;

    @Value("${qwen.base-url:https://dashscope.aliyuncs.com/compatible-mode/v1}")
    private String qwenBaseUrl;

    @Value("${rag.embedding.model:text-embedding-v3}")
    private String embeddingModel;

    @Bean
    @ConditionalOnMissingBean
    public EmbeddingModel embeddingModel() {
        return OpenAiEmbeddingModel.builder()
            .apiKey(qwenApiKey)
            .baseUrl(qwenBaseUrl)
            .modelName(embeddingModel)
            .build();
    }
}
@ConditionalOnProperty + @ConditionalOnExpression 双重条件确保:RAG 关闭或 Qwen API Key 未配置时,不创建 Embedding Bean,系统退化为纯对话模式。
5. 运行时模型切换:从请求到 LLM 调用
5.1 请求数据传输
// kb-ai/src/main/java/com/knowledge/base/ai/dto/ChatRequestDTO.java
public class ChatRequestDTO implements Serializable {
    @NotBlank(message = "对话内容不能为空")
    @Schema(description = "用户输入的问题")
    private String content;

    @Schema(description = "AI模型名称:qwen(通义千问)| deepseek(DeepSeek)")
    private String model;

    @Schema(description = "对话标识ID(首次为空,后端自动创建)")
    private Long conversationId;

    @Schema(description = "是否启用知识库增强(RAG)")
    private Boolean enableRag;

    @Schema(description = "是否启用知识图谱推理(KAG)")
    private Boolean enableKag;
}
model 字段是可选的。如果前端不传,后端自动使用 ai.default-model 配置的默认模型。
5.2 运行时模型切换序列图
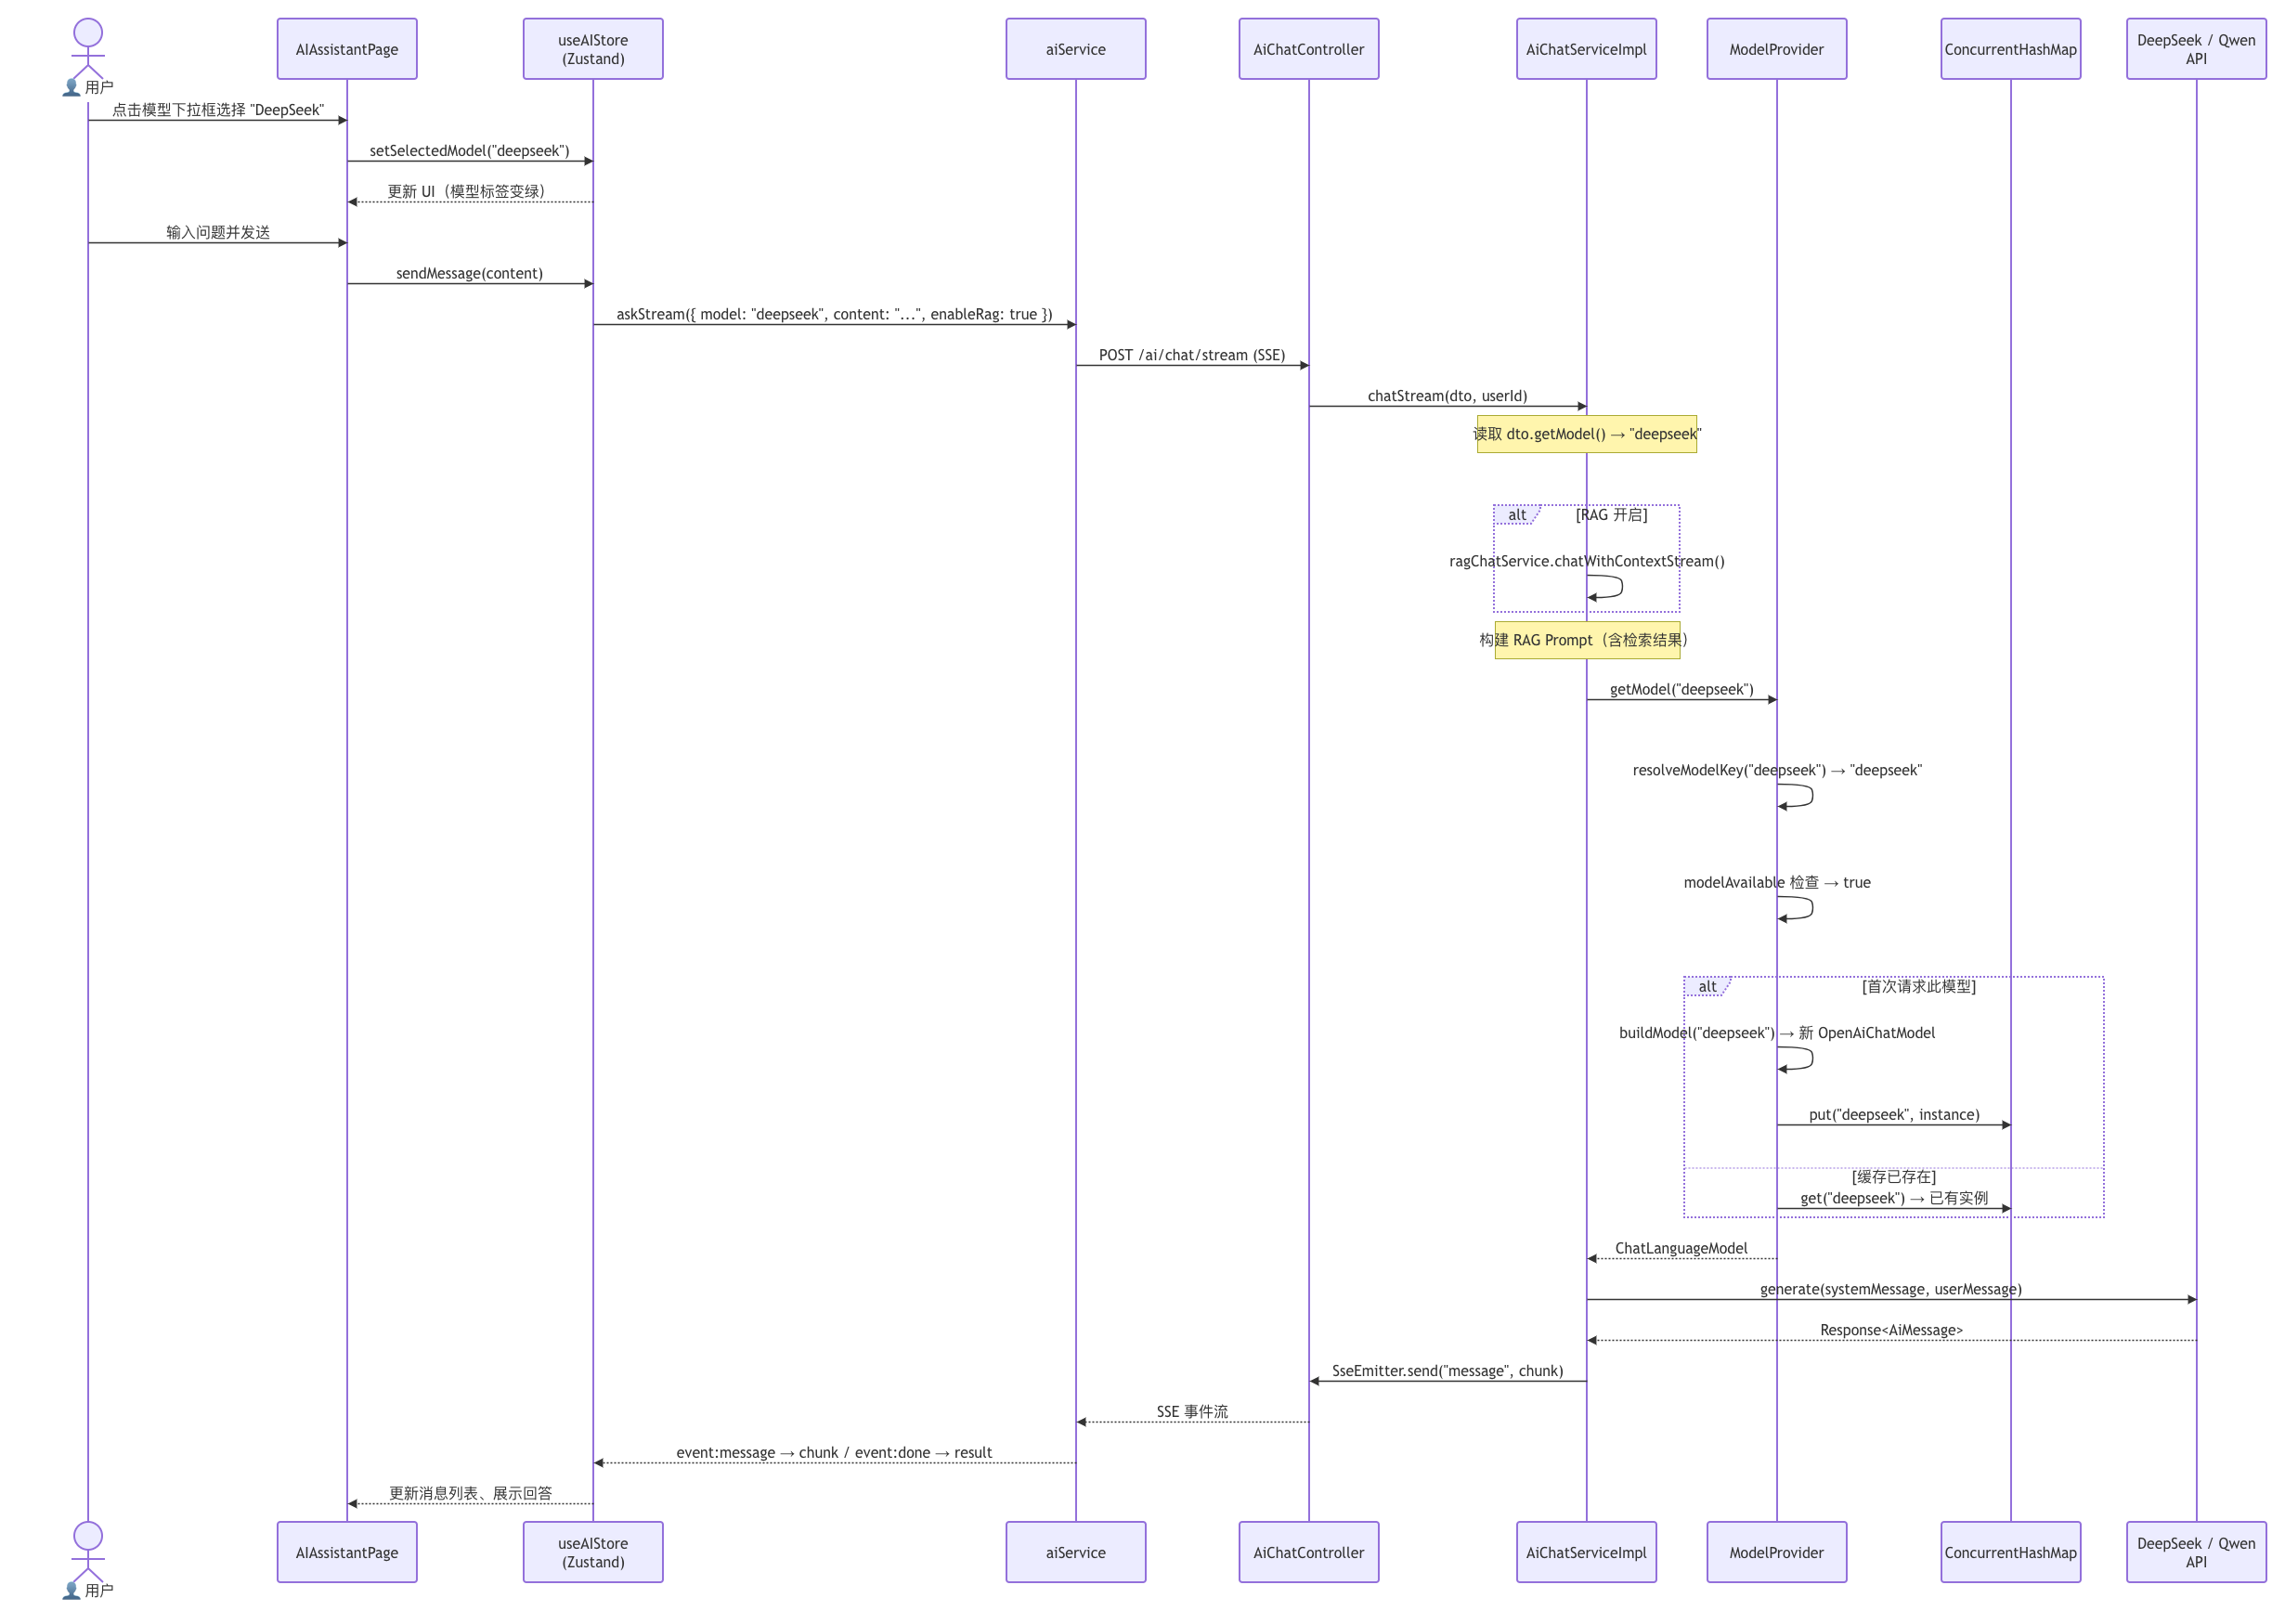
5.3 各服务中的模型解析模式
所有服务类使用统一的模型解析模式,三步走:
// 标准模式 —— AiChatServiceImpl
public ChatResponseVO chat(ChatRequestDTO requestDTO, Long userId) {
    // Step 1: 解析模型名(空 → 默认)
    String modelName = requestDTO.getModel() != null
        ? requestDTO.getModel()
        : modelProvider.getDefaultModelName();

    // Step 2: 获取模型实例
    ChatLanguageModel chatModel = modelProvider.getModel(modelName);

    // Step 3: 调用生成
    Response<AiMessage> response = chatModel.generate(
        SystemMessage.from(systemPrompt),
        UserMessage.from(userPrompt)
    );
    return buildResponse(response);
}

// 简化模式 —— AiDocumentServiceImpl(文档处理不提供用户选择)
// 始终使用默认模型:
ChatLanguageModel chatModel = modelProvider.getDefaultModel();

// KAG 抽取使用独立模型配置 —— LLMExtractionServiceImpl
// 不走用户选择,使用 kag.extraction.model 配置:
ChatLanguageModel chatModel = modelProvider.getModel(extractionModel);
6. 各服务中的模型使用模式
6.1 服务总览
| 服务 | 模型选择方式 | 场景特点 |
|---|---|---|
| AiChatService | 用户选择 → 默认 | 对话需要跟随用户偏好 |
| AiWritingService | 用户选择 → 默认 | 写作需要多样化的模型风格 |
| AiDocumentService | 固定默认模型 | 摘要/大纲/扩写,需要稳定输出 |
| RagChatService | 用户选择 → 默认 | 知识库增强对话 |
| KAGChatService | 用户选择 → 默认 | 图谱推理增强对话 |
| LLMExtractionService | kag.extraction.model 配置 | KAG 实体抽取,独立配置 |
6.2 AiChatService:对话服务
// kb-ai/src/main/java/com/knowledge/base/ai/service/impl/AiChatServiceImpl.java
public ChatResponseVO chat(ChatRequestDTO requestDTO, Long userId) {
    // RAG 路由:如果启用 RAG 且 ragChatService 可用,委托给 RAG 服务
    if (requestDTO.isEnableRag() && ragChatService != null) {
        try {
            return ragChatService.chatWithContext(requestDTO, userId);
        } catch (Exception e) {
            log.warn("RAG 检索失败,降级为标准对话", e);
        }
    }

    // 标准对话
    ChatLanguageModel chatModel = modelProvider.getModel(requestDTO.getModel());
    // ... 构建 Prompt、调用 LLM、构建响应
}
RAG 优先级:enableRag=true 时优先走 RAG 路径,RAG 失败则降级为标准对话。KAG 同理。
6.3 AiWritingService:写作服务
// kb-ai/src/main/java/com/knowledge/base/ai/service/impl/AiWritingServiceImpl.java
public SseEmitter generateStream(WritingRequestDTO dto) {
    // 写作默认使用 DeepSeek 的高温度(0.7),创意性强
    String modelName = dto.getModel() != null ? dto.getModel()
        : modelProvider.getDefaultModelName();
    ChatLanguageModel chatModel = modelProvider.getModel(modelName);

    // 构建写作 Prompt(含角色设定、风格要求、字数限制)
    String prompt = buildWritingPrompt(dto);

    // 流式生成(字符级分块,每块 10 个字符)
    SseEmitter emitter = new SseEmitter(30 * 60 * 1000L);
    CompletableFuture.runAsync(() -> {
        Response<AiMessage> response = chatModel.generate(UserMessage.from(prompt));
        String fullText = response.content().text();
        for (int i = 0; i < fullText.length(); i += CHUNK_SIZE) {
            emitter.send(SseEmitter.event()
                .name("message")
                .data(fullText.substring(i, Math.min(i + CHUNK_SIZE, fullText.length()))));
        }
        emitter.send(SseEmitter.event().name("done").data(buildDoneEvent()));
        emitter.complete();
    }, asyncTaskExecutor);

    return emitter;
}
6.4 AiDocumentService:文档处理
// kb-ai/src/main/java/com/knowledge/base/ai/service/impl/AiDocumentServiceImpl.java
public String generateSummary(String content) {
    // 文档处理不提供用户模型选择,始终使用默认模型
    ChatLanguageModel model = modelProvider.getDefaultModel();
    // ... 构建摘要 Prompt、调用 LLM
}
文档处理的摘要、大纲、扩写等功能面向"生成内容"的稳定性要求高于"风格多样性",因此统一使用默认模型。
7. 前端模型选择与交互
7.1 模型选择 UI
AI 助手页面的工具栏中有模型选择下拉框和 RAG/KAG 开关:
// src/pages/AIAssistantPage.tsx
<div className="toolbar">
    {/* 模型选择 */}
    <Select
        size="small"
        value={selectedModel}
        onChange={setSelectedModel}
        options={availableModels.map(m => ({
            label: m.displayName,
            value: m.key,
        }))}
        style={{ width: 140 }}
    />

    {/* 知识库增强开关 */}
    <Tooltip title="开启后AI将从知识库中检索相关文档辅助回答">
        <Space size={4}>
            <Switch size="small" checked={ragEnabled} onChange={toggleRag} />
            <span>知识库增强</span>
        </Space>
    </Tooltip>
    {/* 图谱推理开关 */}
    <Tooltip title="开启后AI将利用知识图谱进行多跳推理">
        <Space size={4}>
            <Switch size="small" checked={kagEnabled} onChange={toggleKag} />
            <span>图谱推理</span>
        </Space>
    </Tooltip>
</div>
7.2 Zustand Store 状态管理
// src/stores/ai.store.ts
interface AIState {
    selectedModel: string;                  // 默认 'qwen'
    availableModels: AIModelOption[];       // 从后端获取
    ragEnabled: boolean;                    // 知识库增强
    kagEnabled: boolean;                    // 图谱推理

    fetchModels: () => Promise<void>;       // GET /ai/chat/models
    sendMessage: (content: string) => Promise<void>;
}

// 初始化时获取模型列表
const fetchModels = async () => {
    try {
        const models = await aiService.getModels();
        set({ availableModels: models });
    } catch {
        // 降级:使用前端常量中的模型列表
        const fallbackModels = Object.values(AI_CONFIG.MODELS).map(m => ({
            key: m.key,
            displayName: m.displayName,
            description: m.description,
            isDefault: m.key === AI_CONFIG.DEFAULT_MODEL,
        }));
        set({ availableModels: fallbackModels });
    }
};

// 发送消息时携带模型选择
const sendMessage = async (content: string) => {
    const { selectedModel, ragEnabled, kagEnabled } = get();
    const response = await aiService.askStream({
        model: selectedModel,
        content,
        enableRag: ragEnabled,
        enableKag: kagEnabled,
    });
};
7.3 前端常量降级
当后端 API 不可用时(如应用刚启动、网络异常),前端使用本地常量作为降级:
// src/constants/index.ts
export const AI_CONFIG = {
    MAX_TOKENS: 4000,
    TEMPERATURE: 0.3,
    DEFAULT_MODEL: 'qwen',
    MODELS: {
        qwen: {
            key: 'qwen',
            displayName: '通义千问',
            description: '阿里云大语言模型,支持多轮对话、文本生成等',
            color: '#2563eb',        // 蓝色标识
        },
        deepseek: {
            key: 'deepseek',
            displayName: 'DeepSeek',
            description: '深度求索大语言模型,擅长代码生成和深度推理',
            color: '#10b981',        // 绿色标识
        },
    },
} as const;
7.4 模型列表 API
// kb-ai/.../controller/AiChatController.java
@GetMapping("/chat/models")
@Operation(summary = "获取可用模型列表")
public Result<List<ModelVO>> getModels() {
    List<ModelVO> models = modelProvider.getAvailableModels();
    if (models.isEmpty()) {
        log.warn("没有可用的 AI 模型:所有 API Key 均未配置");
    }
    return Result.success(models);
}
// 后端返回格式
[
{
"key": "qwen",
"displayName": "通义千问",
"description": "阿里云大语言模型,支持多轮对话、文本生成等",
"isDefault": true
},
{
"key": "deepseek",
"displayName": "DeepSeek",
"description": "深度求索大语言模型,擅长代码生成和深度推理",
"isDefault": false
}
]8. 流式响应:SSE 端到端实现
8.1 后端 SSE 发射器
// AiChatServiceImpl.chatStream()
public SseEmitter chatStream(ChatRequestDTO requestDTO, Long userId) {
    // 创建 30 分钟超时的 SseEmitter
    SseEmitter emitter = new SseEmitter(30 * 60 * 1000L);

    CompletableFuture.runAsync(() -> {
        try {
            // RAG / KAG / 标准 对话
            ChatResponseVO response = chat(requestDTO, userId);

            // 发送内容
            emitter.send(SseEmitter.event()
                .name("message").data(response.getContent()));

            // 发送元数据
            emitter.send(SseEmitter.event()
                .name("done")
                .data(objectMapper.writeValueAsString(response)));

            emitter.complete();

        } catch (Exception e) {
            emitter.completeWithError(e);
        }
    }, asyncTaskExecutor);

    return emitter;
}
8.2 前端 SSE 解析
// src/services/ai.service.ts
async askStream(
    data: ChatRequestDTO,
    callbacks: {
        onMessage: (chunk: string) => void,
        onDone: (result: ChatResponseVO) => void,
        onError: (msg: string) => void,
    }
): Promise<void> {
    const response = await fetch('/api/ai/chat/stream', {
        method: 'POST',
        headers: {
            'Content-Type': 'application/json',
            'Authorization': `Bearer ${getToken()}`,
        },
        body: JSON.stringify(data),
    });

    const reader = response.body!.getReader();
    const decoder = new TextDecoder();
    let eventType = '';
    let dataBuffer = '';

    while (true) {
        const { done, value } = await reader.read();
        if (done) break;

        const text = decoder.decode(value, { stream: true });
        const lines = text.split('\n');

        for (const line of lines) {
            if (line.startsWith('event:')) {
                eventType = line.substring(6).trim();
            } else if (line.startsWith('data:')) {
                dataBuffer = line.substring(5).trim();
                if (eventType === 'message') {
                    callbacks.onMessage(dataBuffer);
                } else if (eventType === 'done') {
                    callbacks.onDone(JSON.parse(dataBuffer));
                } else if (eventType === 'error') {
                    callbacks.onError(dataBuffer);
                }
            }
        }
    }
}
8.3 流式实现说明
当前系统的 SSE 实现使用 ChatLanguageModel.generate()(阻塞调用),而非 LangChain4j 的 StreamingChatLanguageModel。这意味着:
- 后端:一次
generate()调用获取完整响应,作为单个message事件发送 - 写作服务:通过字符级分块(10 字符/块)模拟流式效果
- WebSocket 替代:聊天历史中的多个对话通过
CompletableFuture异步执行,SSE 按顺序返回
这是当前版本的设计选择,未来升级为 LangChain4j StreamingChatLanguageModel 后可以实现真正的 Token 级流式输出。9. 新增一个模型:完整开发指南
假设我们要接入 OpenAI GPT-4o,以下是完整的改造步骤:
Step 1:backend — 添加配置
# kb-ai/src/main/resources/application.yml
openai:
  api-key: ${OPENAI_API_KEY:}
  base-url: ${OPENAI_BASE_URL:https://api.openai.com/v1}
  chat:
    options:
      model: ${OPENAI_MODEL:gpt-4o}
      temperature: 0.3
      max-tokens: 4096
# .env.example 追加
OPENAI_API_KEY=your-openai-api-key-here
OPENAI_MODEL=gpt-4oStep 2:backend — ModelProvider 注册
在 ModelProvider.java 中添加:
// 1. 添加 @Value 配置字段
@Value("${openai.api-key:}")
private String openaiApiKey;

@Value("${openai.base-url:https://api.openai.com/v1}")
private String openaiBaseUrl;

@Value("${openai.chat.options.model:gpt-4o}")
private String openaiModel;

@Value("${openai.chat.options.temperature:0.3}")
private Double openaiTemperature;

@Value("${openai.chat.options.max-tokens:4096}")
private Integer openaiMaxTokens;

// 2. 在 init() 中注册
@PostConstruct
public void init() {
    checkAndRegister("qwen", "通义千问", "...", qwenApiKey);
    checkAndRegister("deepseek", "DeepSeek", "...", deepseekApiKey);
    checkAndRegister("openai", "GPT-4o",               // ← 新增
        "OpenAI GPT-4o,支持多模态、长上下文", openaiApiKey);
    // ...
}

// 3. 在 buildModel() 中添加分支
case "openai" -> {
    return OpenAiChatModel.builder()
        .apiKey(openaiApiKey)
        .baseUrl(openaiBaseUrl)
        .modelName(openaiModel)
        .temperature(openaiTemperature)
        .maxTokens(openaiMaxTokens)
        .build();
}
Step 3:frontend — 添加常量
// src/constants/index.ts — AI_CONFIG.MODELS 追加
openai: {
    key: 'openai',
    displayName: 'GPT-4o',
    description: 'OpenAI GPT-4o,支持多模态、长上下文理解',
    color: '#74aa9c',    // OpenAI 标志绿色
},
Step 4:frontend — 类型更新(如需要)
如果 AIModelOption 已有 key、displayName、description、isDefault 四个字段,则无需修改。
改造总结
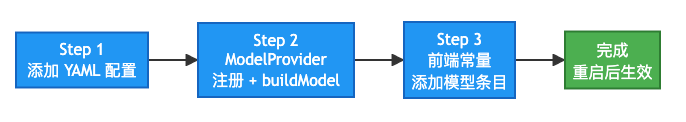
新增一个模型只需修改 4 处:
| 文件 | 修改内容 |
|---|---|
application.yml | 新增模型配置段 |
ModelProvider.java | 字段 + 注册 + buildModel 分支 |
constants/index.ts | 新增模型常量 |
.env.example | 新增环境变量文档 |
无需修改任何业务代码(Service、Controller 等),因为它们完全通过 modelProvider.getModel(modelName) 获取模型实例。
10. 容错与降级
10.1 降级层级
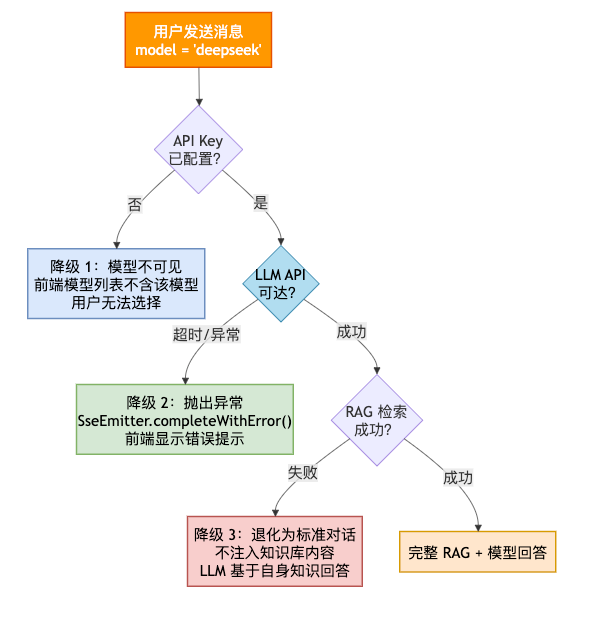
10.2 降级策略总结
| 层级 | 故障点 | 降级行为 | 用户感知 |
|---|---|---|---|
| 1 | API Key 未配置 | 模型不注册,不展示 | 前端下拉框无该模型 |
| 2 | LLM API 超时/异常 | 抛出异常,前端展示错误 | "AI 回答失败,请稍后重试" |
| 3 | RAG 检索失败 | 退化为纯 LLM 对话 | 回答无引用标注 |
10.3 模型回退
当用户选择了某个模型但该模型不可用时:
// ModelProvider.getModel()
public ChatLanguageModel getModel(String modelName) {
    String key = resolveModelKey(modelName);
    if (!modelAvailable.containsKey(key)) {
        throw new IllegalStateException(
            "模型 " + key + " 的 API Key 未配置");
    }
    // ...
}

// AiChatServiceImpl — 用户请求的模型不可用时的兜底
private String resolveModel(ChatRequestDTO requestDTO) {
    if (requestDTO.getModel() != null) {
        // 检查该模型是否可用
        if (!modelProvider.isModelAvailable(requestDTO.getModel())) {
            log.warn("用户请求的模型 {} 不可用,回退到默认模型", requestDTO.getModel());
        } else {
            return requestDTO.getModel();
        }
    }
    return modelProvider.getDefaultModelName();
}
总结
- 供应商无关的抽象:所有模型通过
ChatLanguageModel接口访问,业务代码不感知底层是通义千问还是 DeepSeek。新增 OpenAI 兼容模型只需配置和一处 switch 分支。 - 懒加载 + 缓存:
instanceCache.computeIfAbsent()确保模型实例只创建一次,应用启动时不阻塞在外部 API 调用上。 - API Key 驱动的注册机制:有 Key 就注册、无 Key 就跳过。可以用通义千问做对话 + DeepSeek 做代码生成,灵活组合。
- 前端本地常量降级:后端模型列表 API 不可用时,前端使用
constants/index.ts中的硬编码模型列表作为兜底,确保用户始终能看到模型选择器。 - 多服务一致的模型解析模式:7 个服务类统一使用
modelProvider.getModel(modelName)获取模型,代码风格高度一致。 - RAG/KAG 与模型切换解耦:模型选择和知识增强是两个独立维度。用户可以"通义千问 + RAG"、"DeepSeek + RAG + KAG"、"GPT-4o + 纯对话"任意组合。
适用场景
多模型接入与切换最适合以下场景:
- 对话:用户根据偏好选择模型
- 代码生成:使用 DeepSeek 等擅长代码的模型
- 创意写作:使用高 temperature 的模型
- 成本优化:简单问题用便宜模型,复杂推理用强模型
- 多供应商灾备:一个供应商故障时快速切换到另一个
